
做老龄化方向的研究,想找一套被全球同行反复验证过的追踪数据?CHARLS 篇提过,它的问卷参考了美国的 HRS——这一篇就讲 HRS 本尊:健康与退休研究(Health and Retirement Study),全球老龄化追踪研究的标杆,CHARLS、ELSA、SHARE 都以它为蓝本。老规矩——认识它(01)→ 拿到它(02)→ 看懂它(03)→ 用对它(04)→ 做研究(05)→ 发论文(06),先看图。
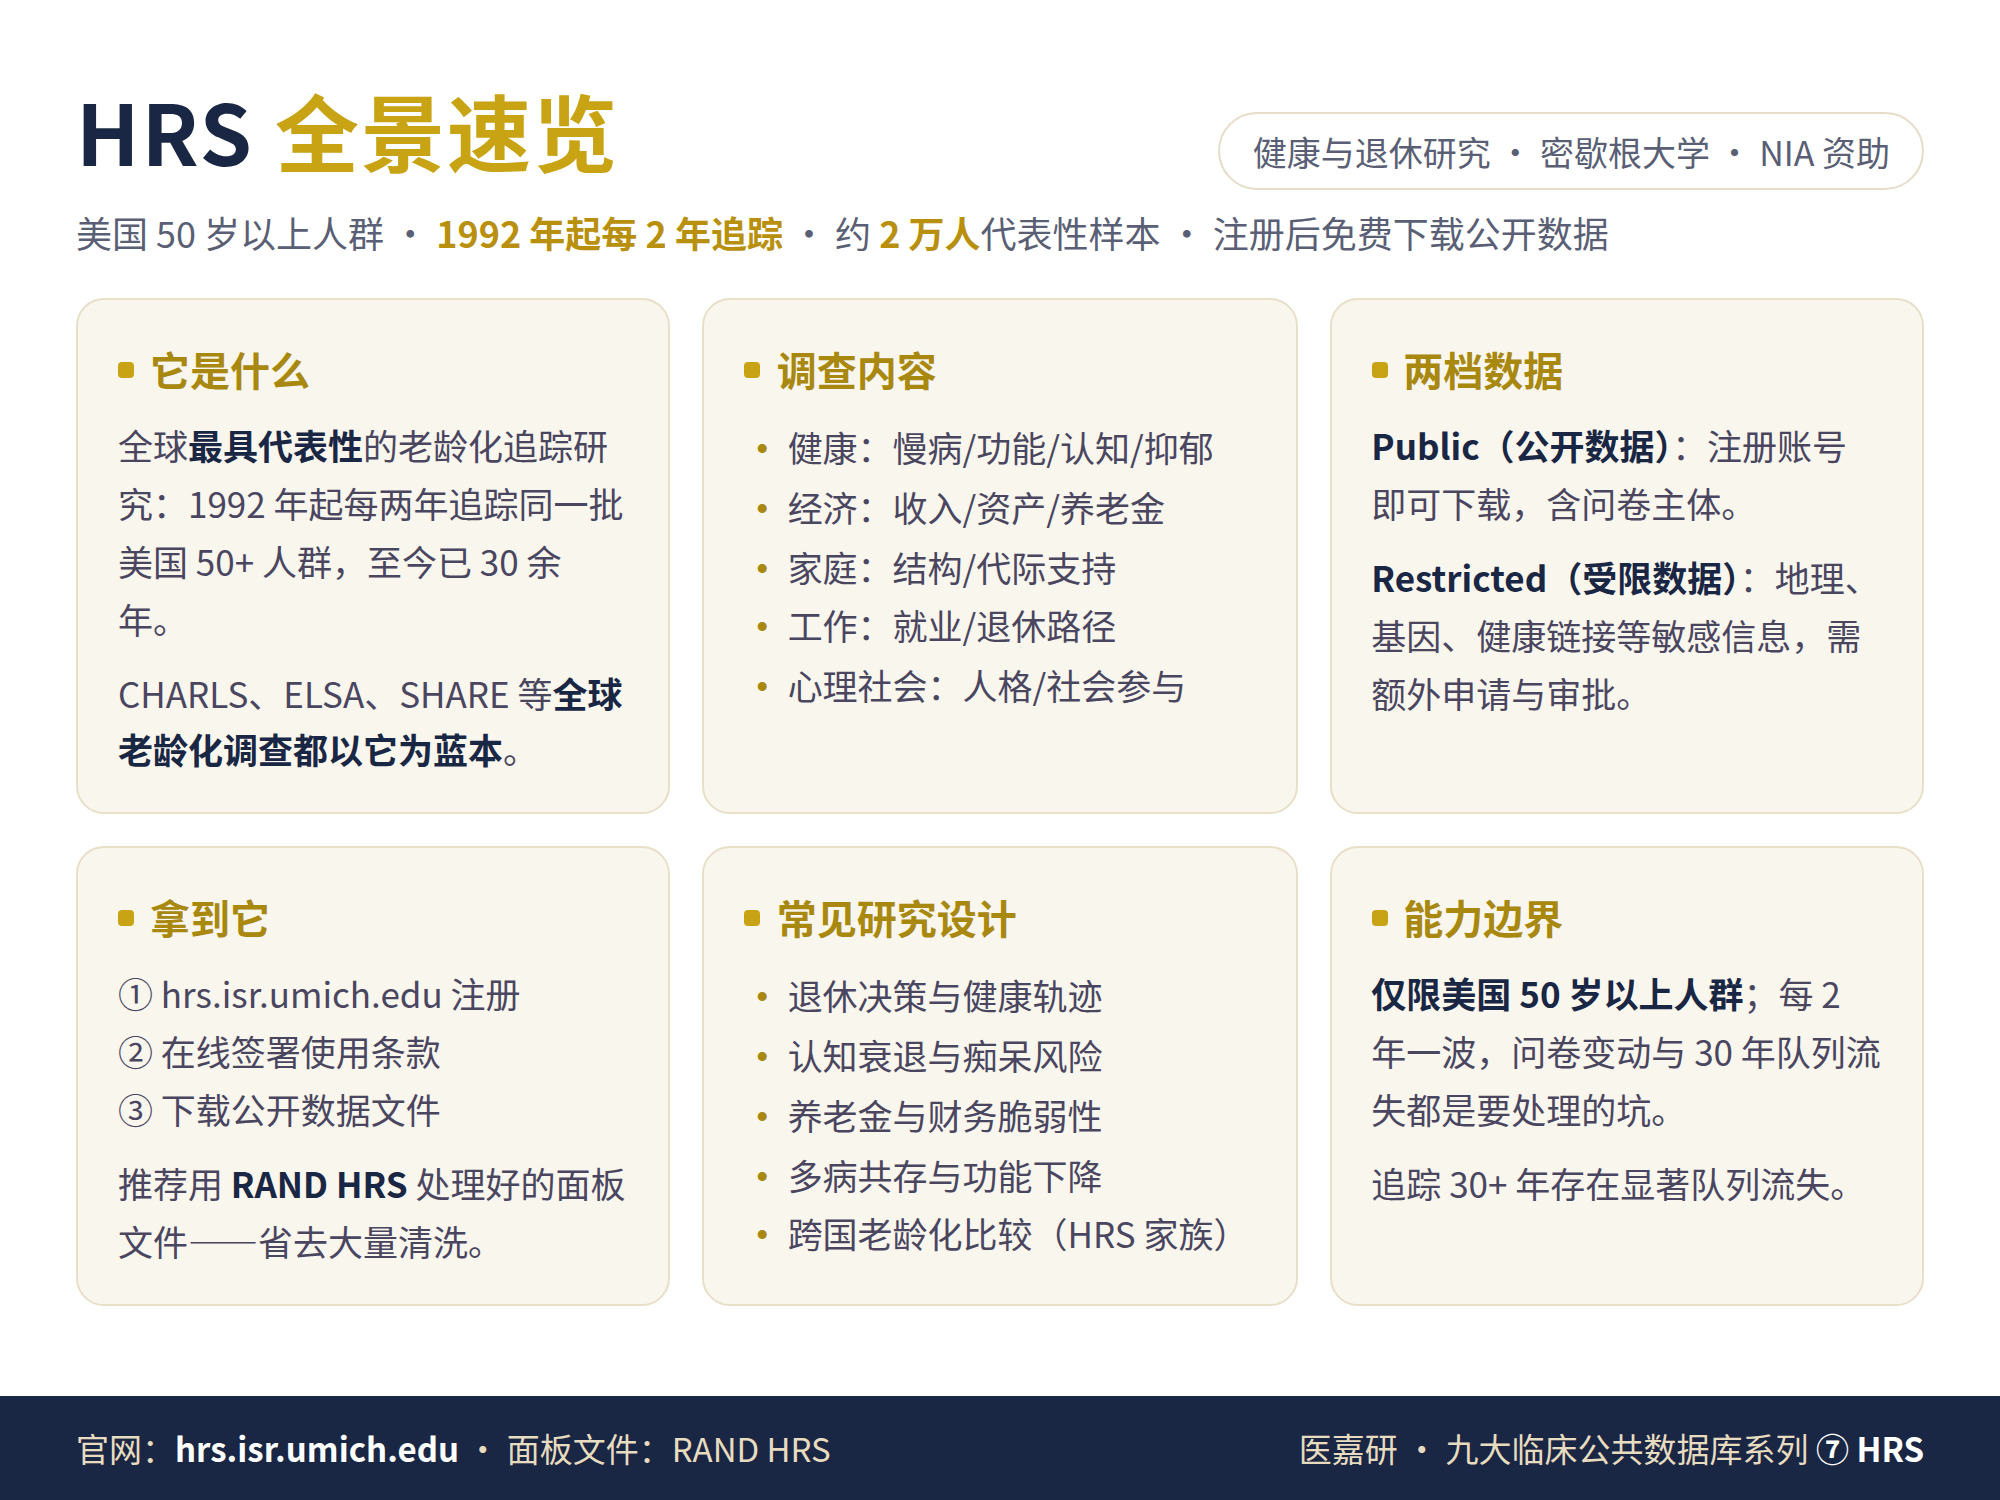
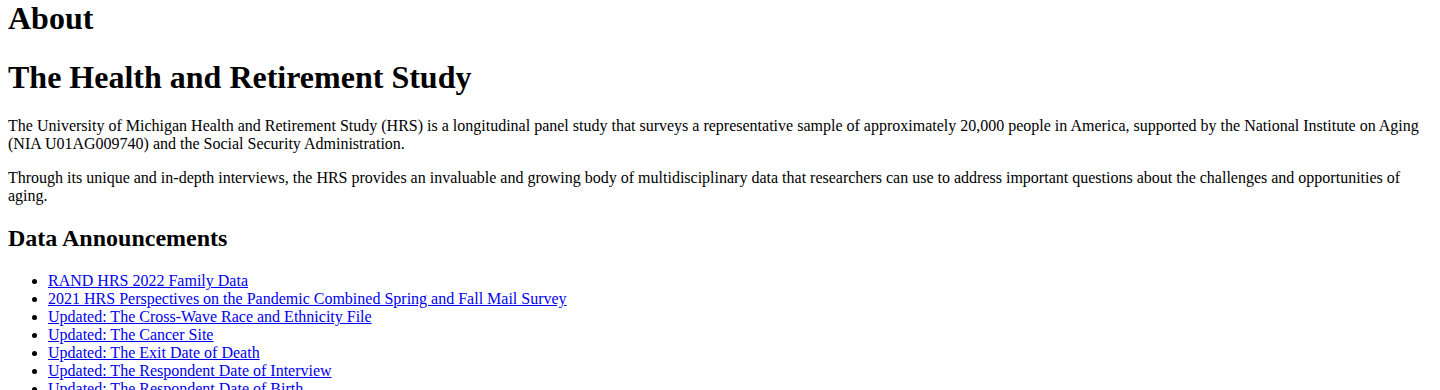
全称:Health and Retirement Study(健康与退休研究)
主持机构:密歇根大学社会研究所(ISR),美国国立卫生研究院(NIH)下属国家老龄研究所(NIA)与社会保障局(SSA)资助
官网:https://hrs.isr.umich.edu/
起始年份:1992 年,此后每 2 年追踪一轮
样本:约 20,000 名美国 50 岁及以上代表性人群
01 认识它:全球老龄化追踪的标杆
HRS 于 1992 年启动,初衷是为退休、医保、储蓄等公共政策讨论提供可检验的数据依据。于是研究人员开始追踪美国即将步入退休的人群,把"变老"这件事拆成可量化的维度——健康、经济、家庭、工作、心理——每隔两年回去测量一次,一测就是 30 多年。
这类对同一批人反复追踪测量的数据叫面板数据(panel data);与之相对,横断面调查只在一个时点给不同的人各拍一张快照。面板数据让研究者直接看到"同一个人怎么变老",而不只是比较"不同年龄的人有什么不同"——这正是"追踪同一个人 30 年"的价值。
队列设计:1992 年首轮抽样针对 1931-1941 年出生的人(当时 51-61 岁),并设置了几个过度抽样(oversample)——非裔美国人、西班牙裔居民、佛罗里达州居民——以提高这些重要群体的样本代表性。此后大约每 6 年加入一批新的"刷新队列"(refreshment cohort,如 1942-47、1948-53、1954-59 年出生),让样本始终能代表现在的 50 岁以上人群。配偶(不限年龄)也会被一并纳入并随访,因此夫妻常常是一个分析单位。
它是全球最具代表性的以"健康×经济×家庭"三维视角追踪老龄化的面板研究——CHARLS(中国)、ELSA(英国)、SHARE(欧洲)、KLoSA(韩国)、JSTAR(日本)的问卷设计都以 HRS 为蓝本,变量定义刻意保持国际可比,这正是跨国老龄化研究能直接在"HRS 家族"内部做同量表比较的原因。
02 拿到它:注册即下,但务必分清公开与受限
HRS 数据完全免费,但分两档,千万别弄混:
- Public(公开数据):在 hrs.isr.umich.edu 注册账号、在线签署使用条款,即可下载全部公开问卷数据——健康、经济、家庭、工作、心理等主体模块全在这里
- Restricted(受限数据):这部分才是重头,需单独走流程——地理信息(社区/州级数据)、Medicare/Medicaid 链接(美国联邦医保 Medicare 与医疗补助 Medicaid 的行政医疗数据)、基因与生物样本数据(唾液 DNA、干血斑生物标志物)等。需提交研究计划和知情同意信息,签署保密协议,审批通过后在VDI 安全虚拟桌面中访问,不能直接下载到本机
对绝大多数研究,公开数据已经足够。强烈建议直接用 RAND HRS 面板文件:兰德公司(RAND,美国一家非营利研究机构)把 30 余年、16 轮追踪的原始数据清洗成一个包含全部 16 轮的单文件面板——一行一个人,同一变量在各轮的取值并排排开(变量名前缀标明轮次,如 R1…R16)——变量名统一、缺失值经插补(imputation)处理、包含大量构造好的变量(constructed variables),还自带权重。对新手来说,用 RAND HRS 能省去自己合并几十张原始表、处理缺失值的大量工作。RAND HRS 同样是免费注册的。
03 看懂它:波次结构与能拿到的数据
HRS 的数据按波次(wave)组织:1992、1994、1996……每两年一轮,目前已到 2022 波(共 16 轮)。问卷覆盖五大模块(健康、经济、家庭、工作自 1992 年首轮起就是核心,心理社会为后续扩展):
- 健康:自评健康、慢病诊断(高血压/糖尿病/心脏病/关节炎/肺病等)、ADL/IADL 功能(吃饭穿衣、出门管钱等日常自理与操持能力)、抑郁症状(CES-D-8,8 题抑郁量表)、认知功能测验、睡眠与疼痛
- 经济:收入、资产、债务、住房、消费、医疗保险、退休账户
- 家庭:婚姻、子女、代际经济往来、照料提供与接受
- 工作:就业状态、退休时间与类型、养老金(DB=待遇确定型、DC=缴费确定型)、工作经历
- 心理社会:人格(大五)、社会参与、歧视体验、生活满意度、孤独感
除了问卷,HRS 还有一批链接数据把问卷与外部记录连起来,大大拓宽分析空间:Medicare 医疗索赔数据(可研究真实就医行为与技术利用,是问卷难以覆盖的行政医疗记录)、基因型数据(唾液 DNA,做遗传-环境交互)、生物标志物(干血斑检测的多个临床指标)。这些多为受限数据,需要走申请流程。
个体跨波次用 HHID + PN(家庭 ID + 个人编号)匹配。需要注意:公开问卷数据在各波次间高度一致,但部分变量有更名或口径调整——RAND HRS 已经把这些统一对齐,自己合并原始文件时务必逐一查 codebook。
04 用对它:面板数据的三个关键操作
- 追踪流失(attrition):30 年追踪意味着大量失访与死亡——每波次的留存率都要报告,并对"流失者 vs 留存者"做系统性差异比较。常用的两种处理:逆概率加权(inverse probability weighting)来校正选择偏倚,或做缺失数据多重插补。受访者去世后,HRS 会由代理人(proxy)完成一次 exit interview(离访),末端事件仍可捕捉
- 权重:HRS 提供截面权重和纵向权重(分析哪些波次用哪个权重,别拿截面权重做多年分析)。RAND HRS 文件里已附带权重变量,直接调用即可。做全国性年龄 50+ 人群推断必须用权重
- 年龄 / 队列 / 时期三效分清:1992 年 51 岁的人和 2022 年 51 岁的人出生相差 30 年,面对的经济与健康环境完全不同。跨年比较时要把年龄效应(age)、队列效应(cohort)、时期效应(period)分开,否则得出的"随时间变化"很可能其实是"不同代人本身的差异"
05 做研究:HRS 高频发文方向
- 退休与健康:退休时机对认知/抑郁/死亡率的影响、强制退休 vs 自愿退休的健康差异、退休与饮酒/吸烟行为改变
- 认知衰退与痴呆:认知轨迹分型、教育/职业的认知储备效应、痴呆风险预测——HRS 的认知模块(含代理报告的认知障碍)是该领域主流的数据来源之一
- 财务脆弱性与退休充足性:退休储蓄是否够用、医疗支出对资产的侵蚀、长寿风险、"退休金财富由谁承担"的代际转移
- 多病共存与功能下降:慢病组合模式、功能衰退轨迹、虚弱指数(frailty index)构建
- 照料(caregiving):谁在照顾老年人、照料的健康与经济代价、工作与照料的两难——老龄化社会的高政策相关主题
- 跨国比较:HRS vs CHARLS vs ELSA——同量表跨文化的健康老龄化比较,尤其在"中老年人健康决定因素"上中国数据有独特增量
能力边界明确:仅限美国 50 岁以上人群,不能外推到年轻人或其他国家;每 2 年一波,时间粒度比逐年调查粗;30 年追踪的队列流失不可避免;自报健康与回忆存在偏倚;Medicare 链接等关键资源在受限数据里,需申请。
06 发论文:老龄化研究的"标准答案",也是差异化的考场
HRS 是老龄化领域引用量最大的数据集之一——用它做"退休与健康"的论文已经写了 30 多年,纯描述性分析的边际价值在递减。差异化空间主要在三个方向:
- 纵向方法:轨迹建模(latent class growth modeling)、状态转移模型、竞争风险模型——用更精细的纵向设计从别人做过的主题里挖新东西
- 跨国比较:把 HRS 和 CHARLS 配套做中美对比——同样的研究设计,中国高发或中国独有的健康问题(如特定的慢病组合、代际照料)天然自带差异化,也更容易被国际期刊接受
- 链接数据:把 HRS 问卷 + Medicare 索赔 + 生物标志物组合起来做多数据源研究,比单一问卷更有新意
我们辅导的常规路径:选题查新与差异化设计(1-2 周)→ RAND HRS 面板构建与变量对齐(2-4 周)→ 纵向统计分析与敏感性分析(3-5 周)→ STROBE(观察性研究报告规范)写作与投稿(5-8 周)。导师一对一示范与把关,分析与写作由你本人完成。
下一篇讲 eICU——和 MIMIC 同为 ICU 重症数据库,但它是多中心:覆盖全美 208 家医院、335 个 ICU、超过 20 万次住院(2014-2015),正好补上 MIMIC 单中心样本不够的短板。关注医嘉研科研资讯,九大临床公共数据库逐个讲透。