
做肿瘤方向的研究,想找到一套几乎覆盖全癌种、有官方权威背书的公开数据?前四篇讲完人群调查(NHANES)、中老年追踪(CHARLS)、全球模型估算(GBD)、ICU 真实世界数据(MIMIC)——这一篇讲肿瘤专科方向的"母库":SEER,美国国家癌症研究所(NCI)的人群级肿瘤登记系统。老规矩,一条主线——认识它(01)→ 拿到它(02)→ 看懂它(03)→ 用对它(04)→ 做研究(05)→ 发论文(06),先看图。
全称:Surveillance, Epidemiology, and End Results Program(监测、流行病学与最终结果项目)
主持机构:美国国家癌症研究所(NCI)癌症控制与人口科学部(DCCPS)
官网:https://seer.cancer.gov/
最新数据:SEER Incidence Data 1975-2023(2026 年 4 月发布)
覆盖:SEER 8/12/17/21 四档登记处子集,最大子集覆盖美国约 45% 人口
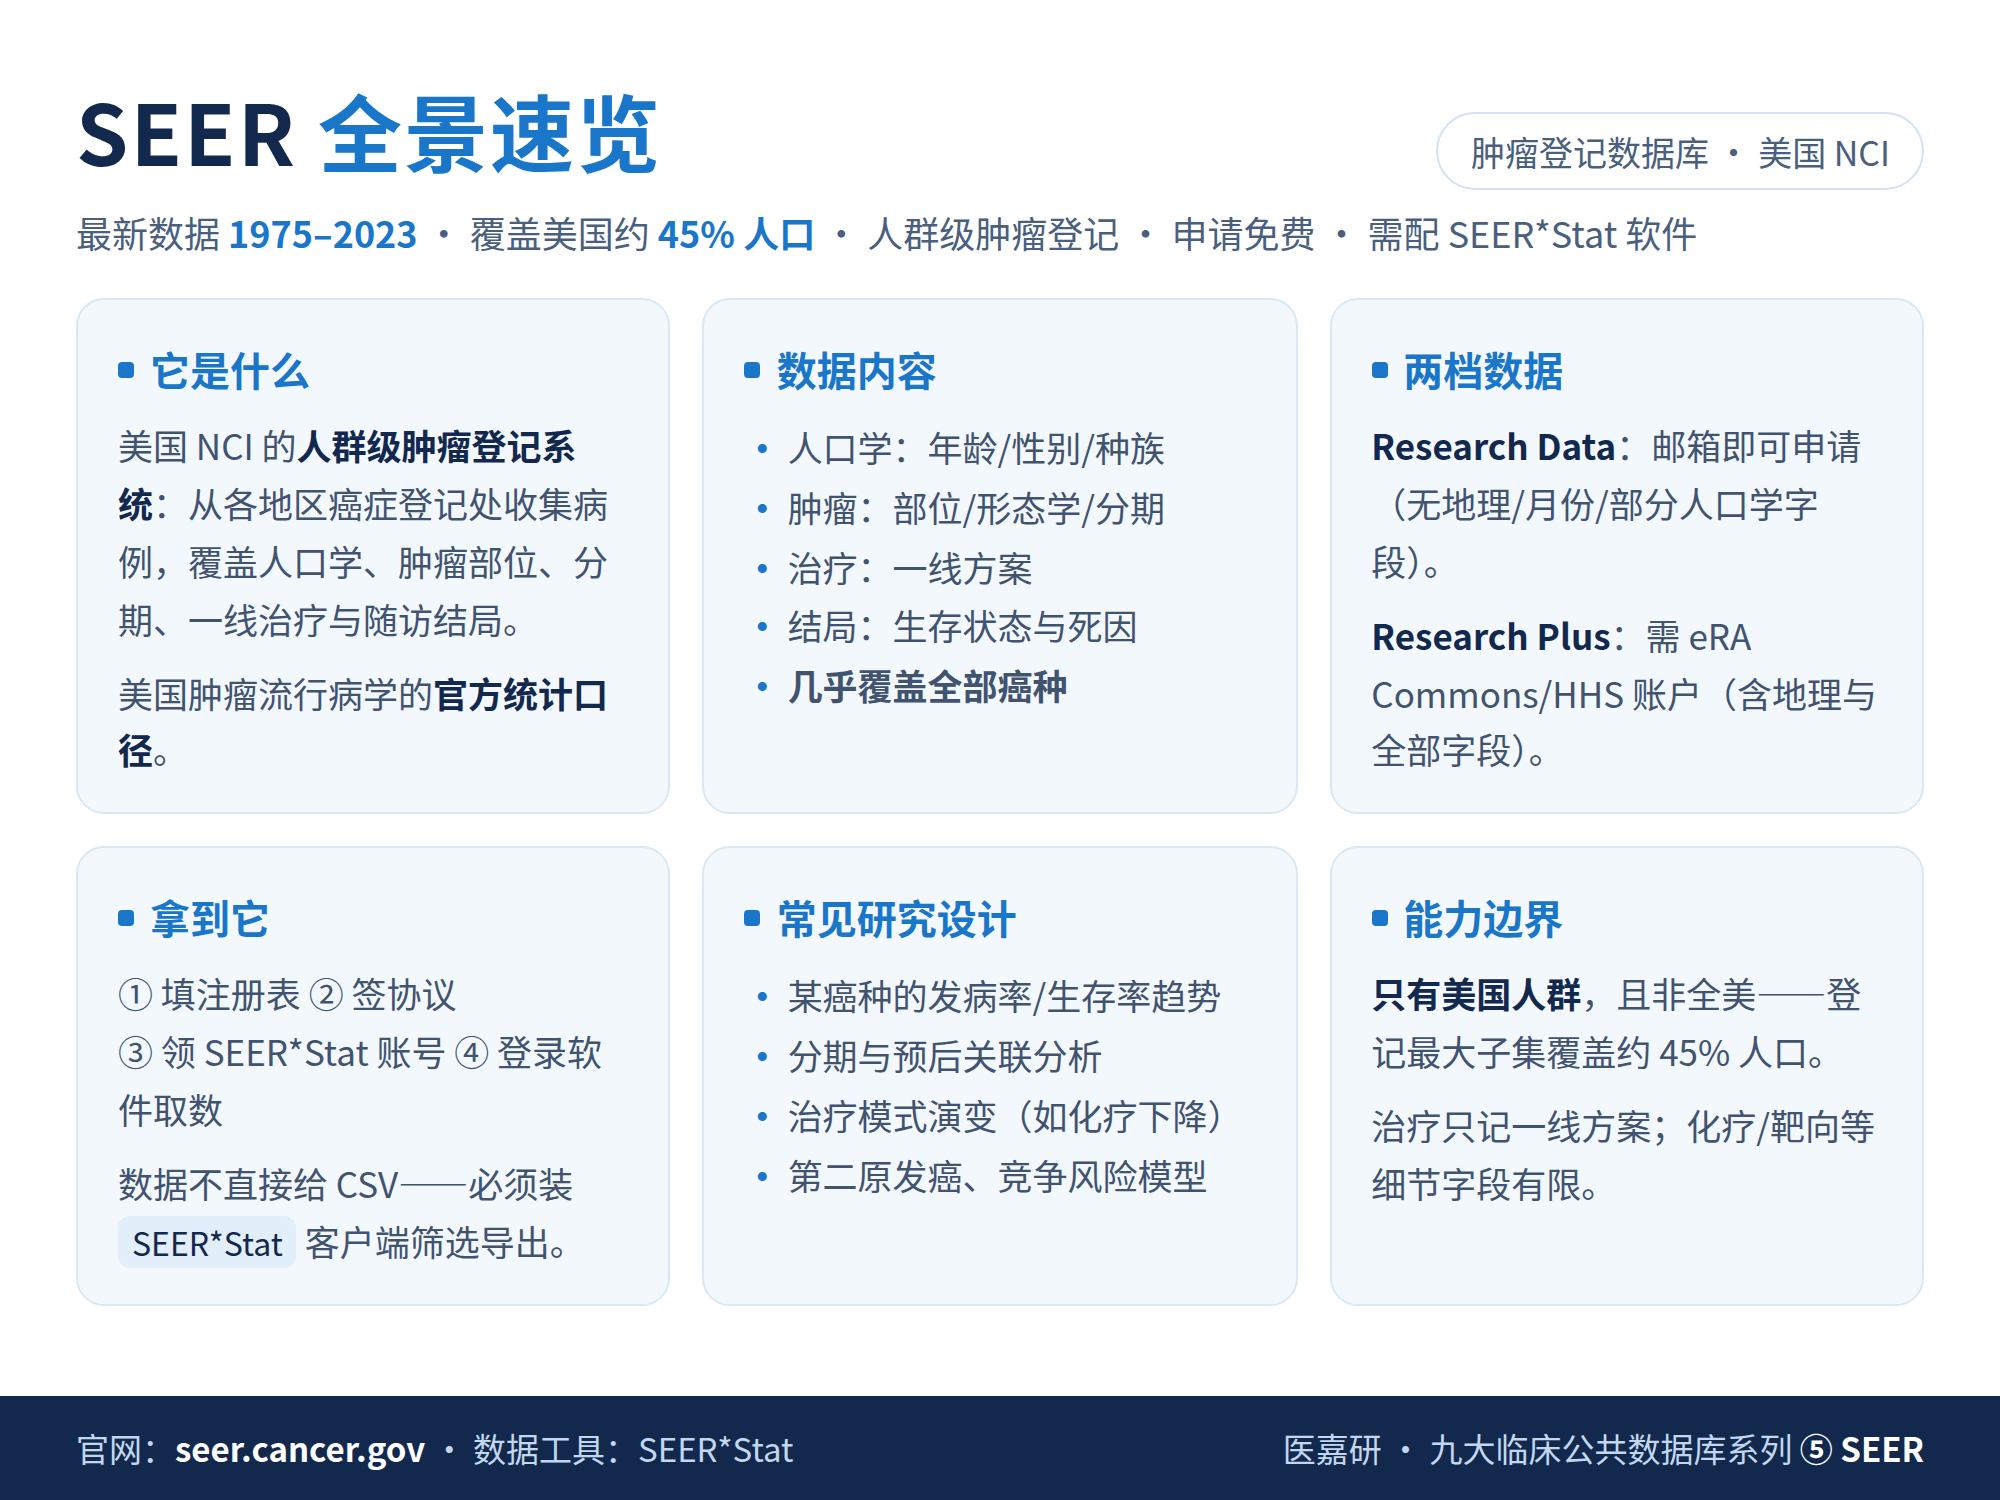
01 认识它:美国肿瘤统计的官方口径
SEER 项目成立于 1973 年,发病数据自 1975 年起持续收集,是美国运行最久、覆盖最广的人群级肿瘤登记系统。它不是一家医院的病历,而是从分布在全国的多个癌症登记处(registries)收集病例。SEER 按登记处数量分档提供子集——SEER 8(约 8.3% 美国人口,1975 年起)到 SEER 21(约 45.8%,2000 年起)——最大子集覆盖美国约 45% 的人口。每一个登记处覆盖其辖区内的所有新发癌症病例,形成真正意义上的"人群级"数据。
你在文献里看到的"美国癌症发病率""五年生存率"的权威数字,绝大多数来自 SEER——它就是美国肿瘤流行病学的官方统计口径。最新一轮 SEER Incidence Data 覆盖 1975-2023 年,于 2026 年 4 月发布(基于 2025 年 11 月提交的登记数据)。
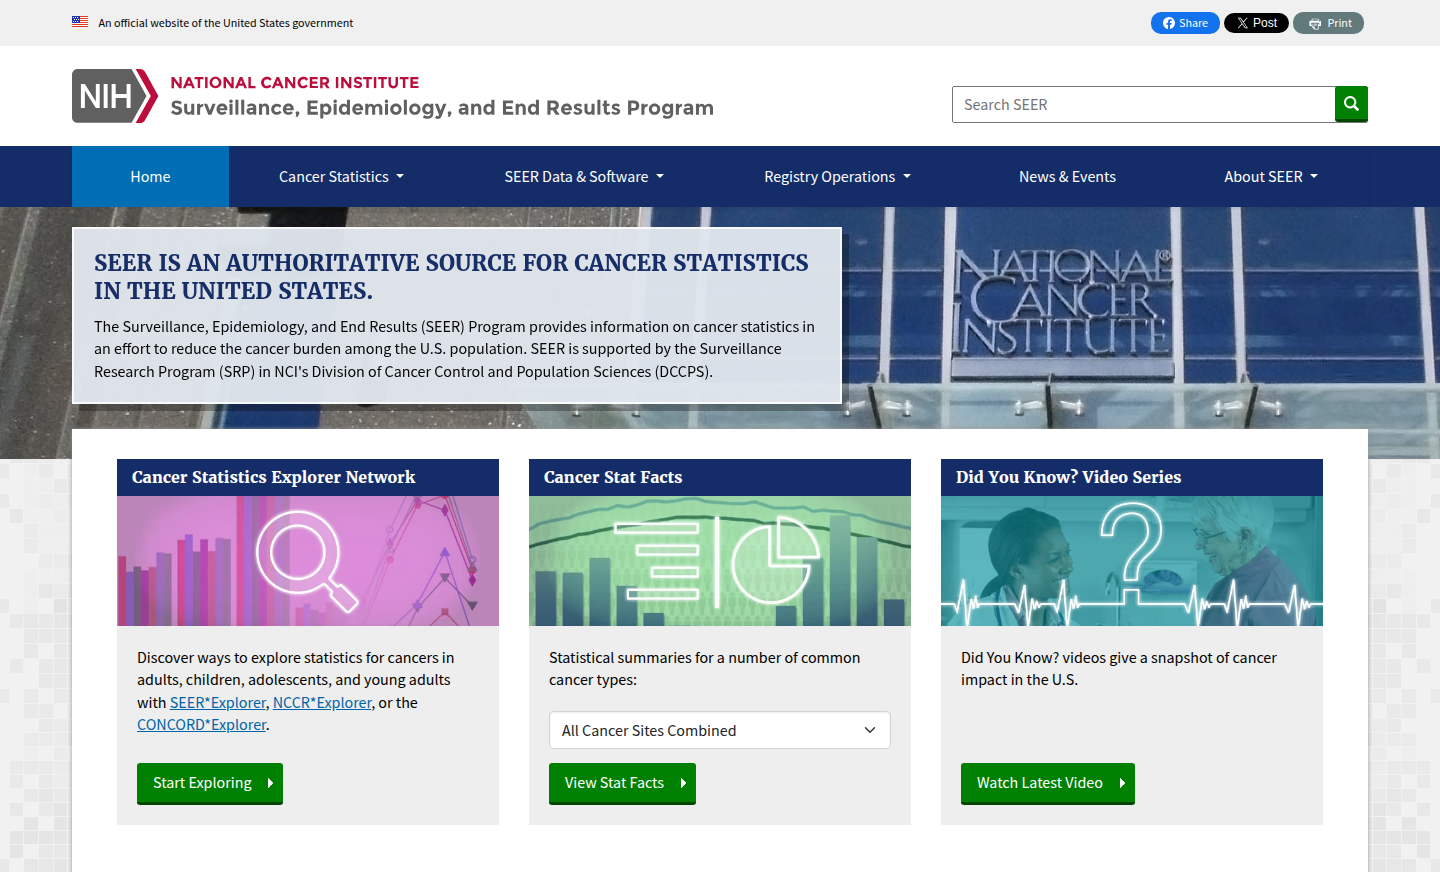
02 拿到它:两档数据,两种门槛
SEER 的数据申请完全免费,但不同于前几个数据库"下载即用"——它的数据需要先在官网申请访问权限,再通过专用软件 SEER*Stat 筛选导出。官网把数据分成两档,门槛差别很大:
- Research Data(研究数据):排除了地理信息、精确诊断月份(只保留年份)和部分人口学字段——任何人凭有效邮箱即可申请,填写注册表 → 签署协议 → 获取 SEER*Stat 账号 → 登录取数
- Research Plus and NCCR Data(研究增强版 + 儿童癌症登记数据):包含地理信息、精确诊断月份和全部人口学字段——需要 eRA Commons(NIH 研究者账号系统)或 HHS(美国卫生与公众服务部)账户,且不在受限国家/地区(2025 年 4 月起 NIH 明确禁止"受关注国家/地区"用户访问 Research Plus 与 NCCR 数据),额外需要提供导师或监督人信息
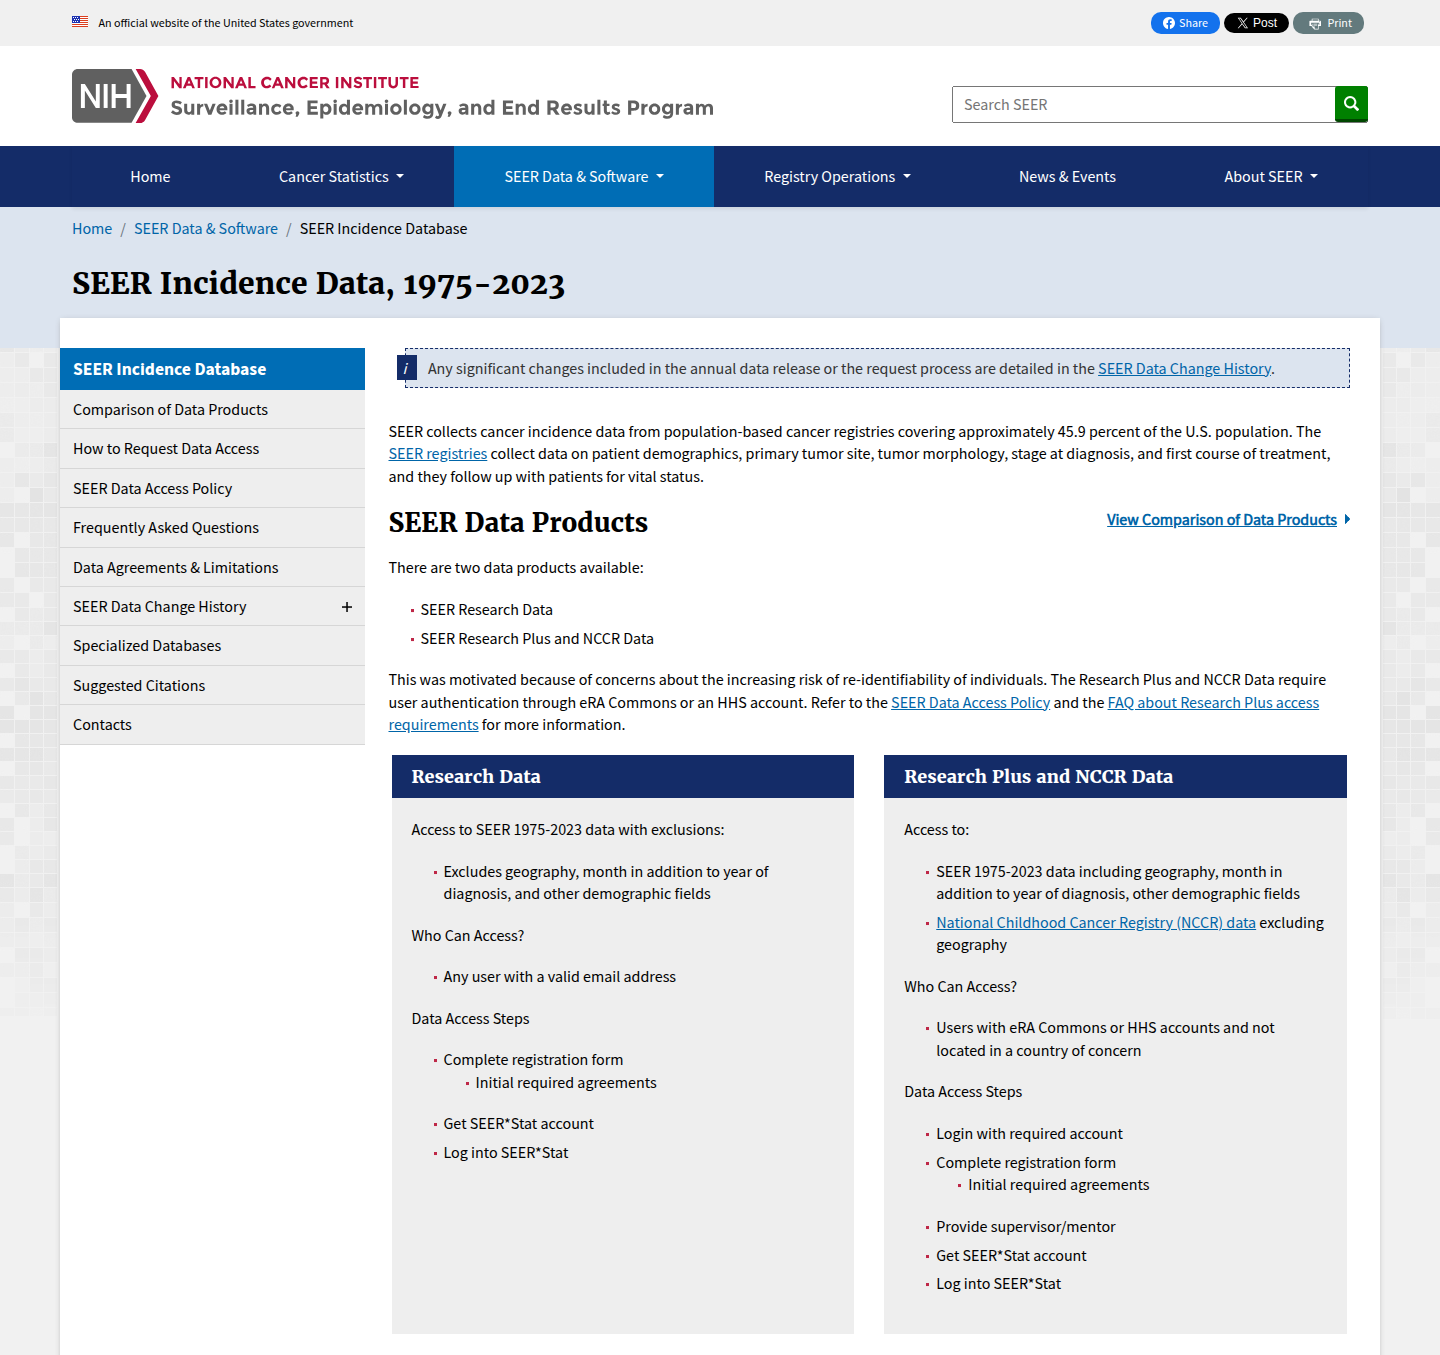
对大多数国内研究者,Research Data 已经够用——发病率、生存率、分期分布这些核心分析都不需要地理字段。提交申请并验证邮箱后由官方处理发放账号,Research Plus/NCCR 通道官方口径约 2 个工作日;数据本身不直接给 CSV 文件,必须安装 SEER*Stat 客户端软件在本地筛选、计算后导出。
03 看懂它:每个病例的五类信息
SEER 的每一条记录是一个癌症病例,核心字段分五类:
- 人口学:诊断年龄、性别、种族(白人/黑人/亚裔/其他)、婚姻状况
- 肿瘤信息:原发部位(ICD-O-3 部位编码,国际疾病分类肿瘤学专辑第 3 版)、组织学类型(形态学编码)、诊断时的分期(SEER Historic Stage / AJCC 分期,美国癌症联合委员会分期系统)、分级
- 治疗:一线治疗方案——手术、放疗、化疗(是否接受)、激素治疗等
- 结局:随访生存状态、生存月数、死因(癌症特异性死亡 vs 其他死因)
- 多原发:同一患者的第 1/2/3…个原发癌序列号——做"第二原发癌"研究的钥匙
癌种覆盖几乎全谱系:乳腺、肺、结直肠、前列腺、胃、肝、甲状腺、淋巴瘤、白血病……凡是你能想到的实体瘤和血液肿瘤,基本都在 SEER 里。选癌种时先确认该癌种在所选登记数据里的样本量是否足够——罕见癌种建议合并多年份。
04 用对它:登记数据的三个关键口径
SEER 数据干净、字段规范,但有三个口径必须拿捏准:
- 发病率 ≠ 患病率 ≠ 死亡率:SEER Incidence 是"新发病例"数据;做生存分析用的是随访模块;不要拿发病数据直接算患病负担
- 分期口径因年份而异:SEER Historic Stage 是粗粒度(localized/regional/distant,仅覆盖到 2015 年诊断的病例,2018 年起由 Summary Stage 2018 接续),AJCC 分期字段分代加入:6th 版对应 2004 年起诊断的病例(Collaborative Stage 系统),7th 版自 2010 年诊断年起、8th 版自 2018 年起——跨年合并必须统一口径
- 生存分析的竞争风险:肿瘤特异性死亡和非肿瘤死亡互为竞争事件——用 Fine-Gray 模型或累积发生率函数,而不是简单 Kaplan-Meier(KM 生存曲线,会高估)
SEER*Stat 软件按分析目标分多种会话类型:Frequency(频数统计)、Rate(计算发病率/死亡率,用于流行病学描述)、Trends(长期趋势)、Case Listing(导出病例清单,用于自定义分析)、Survival(生存率计算)、MP-SIR(多原发癌的标准化发病比)、Left-Truncated Life Table(条件生存)等。入门者通常从频数、发病率与生存三类入手;软件本身内置率计算(age-adjusted rate,年龄标准化率)、生存分析、趋势检验——但灵活的分析(多因素回归、竞争风险、倾向评分)要导出到 R/Stata 完成。
05 做研究:SEER 高频发文方向
- 单癌种流行病学描述:某癌种的发病率趋势、年龄分布、种族差异——入门方向,样本量天然充足
- 预后因素分析:分期、治疗、人口学特征与肿瘤特异性生存的关联——Cox/竞争风险模型是标配
- 治疗模式演变:如某癌种化疗使用率十年变化、新辅助治疗的推广轨迹
- 第二原发癌:放疗后第二肿瘤风险、癌症幸存者的新发癌监测
- 预后模型与列线图:基于 SEER 构建 nomogram 预测癌症特异性生存——发文量极大,需要外部验证才站得住
能力边界明确:只有美国人群,且登记最大子集覆盖约 45% 而非全美——外推到其他地区要谨慎;治疗只记录一线方案,化疗只记"用/不用"无剂量;没有合并症、生活质量、复发信息;登记滞后(最新数据通常晚 2-3 年)。
06 发论文:癌种选题的差异化空间
SEER 发文量巨大,但肿瘤领域病种细分极多——热门癌种的套路选题(乳腺癌 nomogram)高度饱和,而罕见癌种、特定亚组(青少年、老年、少数族裔)、第二原发癌、治疗模式演变仍有大量空白。选题时先看近 2 年该癌种的 SEER 发文量,饱和方向果断换。
我们辅导的常规路径:选题查新与癌种/亚组差异化设计(1-2 周)→ SEER*Stat 队列构建与数据导出(2-3 周)→ 生存分析/竞争风险/建模与可视化(3-5 周)→ STROBE/TRIPOD 规范写作与投稿(5-8 周)。导师一对一示范与把关,分析与写作由你本人完成。
下一篇讲 GCO(GLOBOCAN)——覆盖全球 186 个国家、34 种癌症的全球癌症观测数据库,回答"某国某癌种负担多重"这类宏观问题的首选。关注医嘉研科研资讯,九大临床公共数据库逐个讲透。