
想做重症方向的研究,想拿到真实的 ICU(Intensive Care Unit,重症监护室)数据?前三个数据库——NHANES 是美国人群调查、CHARLS 是中国中老年追踪、GBD 是全球模型估算——都没有"病房里正在发生什么"这层颗粒度。MIMIC 是第四个完全不同的物种:它是波士顿 BIDMC 医院(Beth Israel Deaconess Medical Center,贝斯以色列女执事医疗中心)收治的急诊与 ICU 病人的逐小时记录——心率、血压、呼吸机参数、每一支药的给药时刻、每一次化验结果,时间戳精确到分钟。这篇继续老规矩——认识它(01)→ 拿到它(02)→ 看懂它(03)→ 用对它(04)→ 做研究(05)→ 发论文(06),先看图。
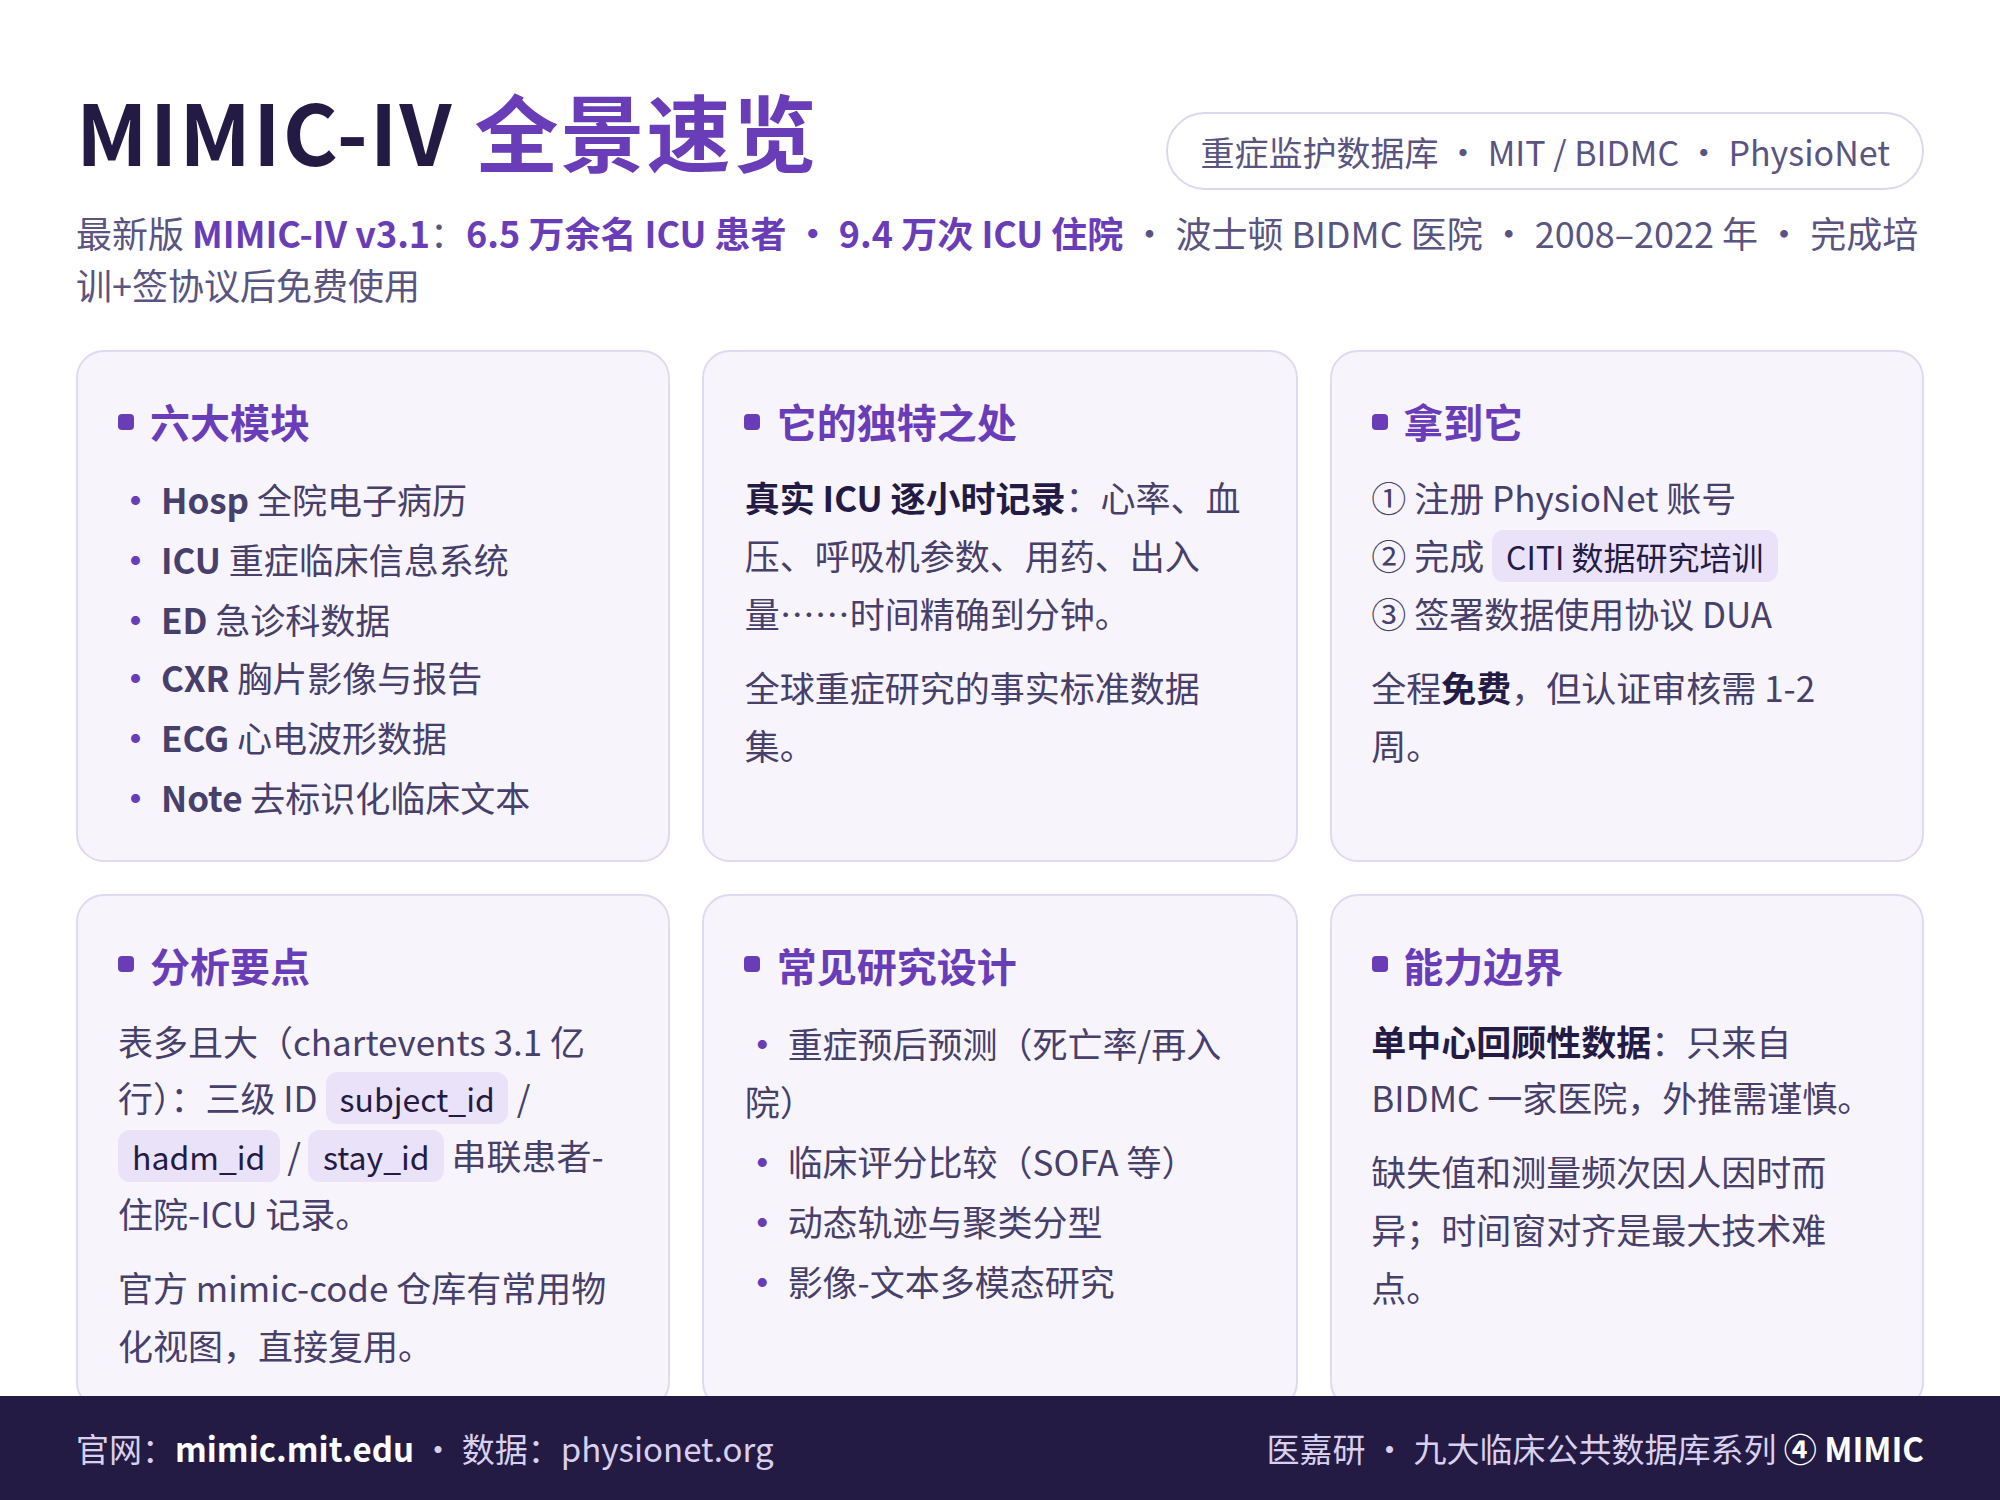
全称:Medical Information Mart for Intensive Care(重症医疗信息集市)
主持机构:MIT 计算生理学实验室 + 波士顿 Beth Israel Deaconess Medical Center(BIDMC)
官网:https://mimic.mit.edu/ · 数据托管:https://physionet.org/
最新版本:MIMIC-IV v3.1(2024 年 10 月发布),数据时间跨度 2008-2022 年
规模:ICU 患者 65,366 名、ICU 住院 94,458 次;含急诊在内的全库个体 364,627 名、住院 546,028 次
01 认识它:重症医学研究的事实标准数据集
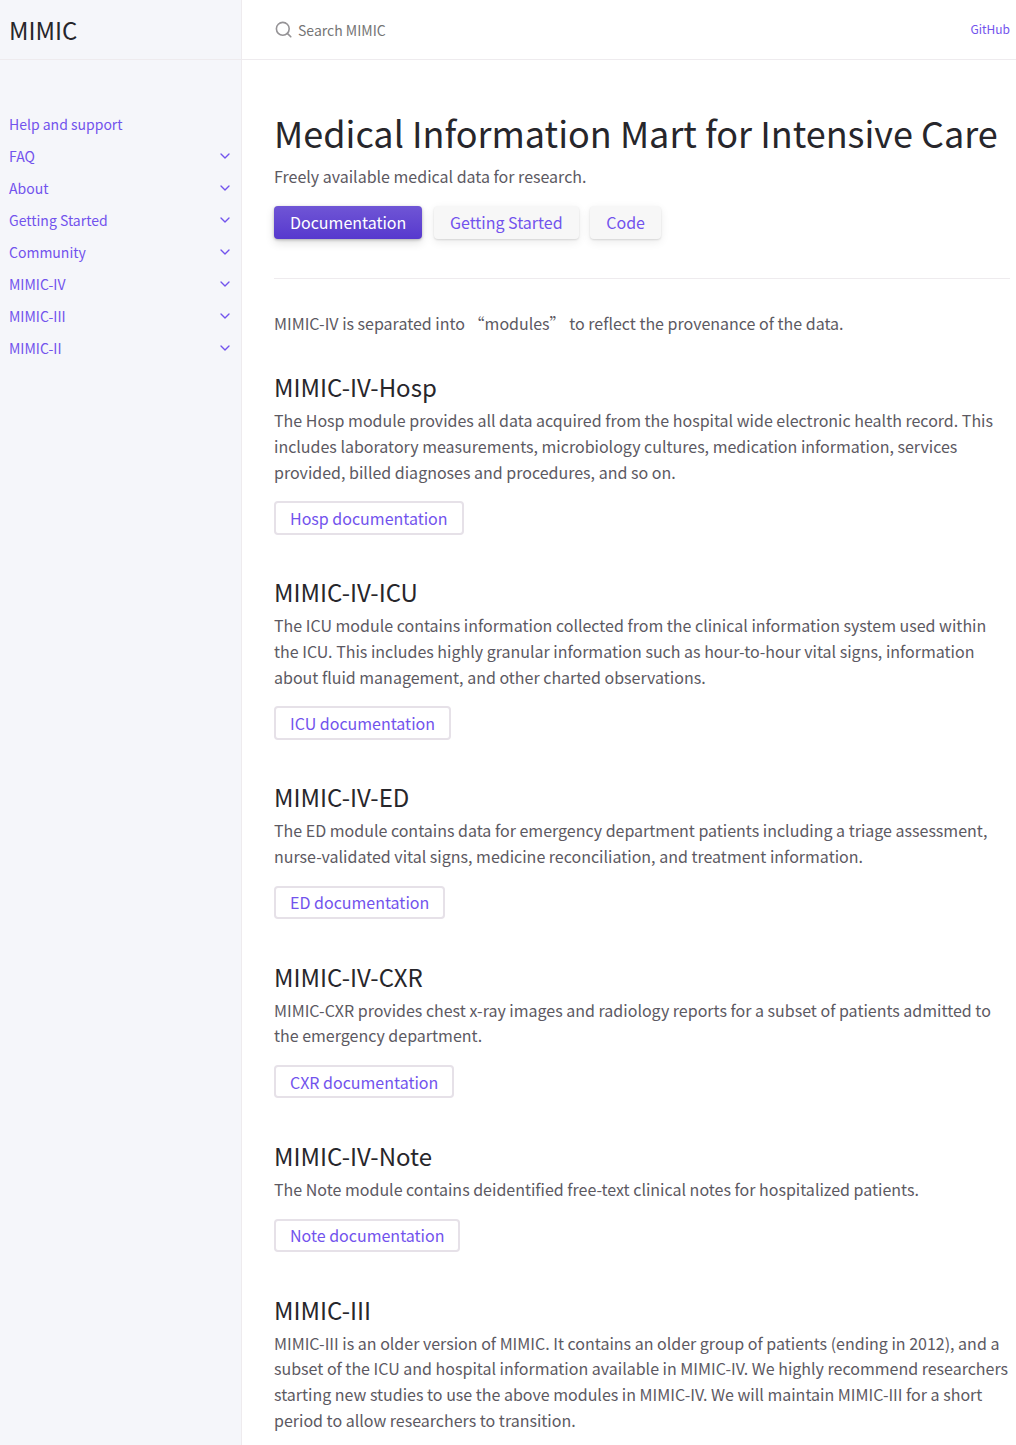
MIMIC 由 MIT 计算生理学实验室与波士顿 BIDMC 医院联合构建。MIMIC-IV 是它目前的最新主版本,按"模块"组织——每个模块对应一种数据来源:官方文档列出六大模块——全院电子病历(Hosp)、ICU 临床信息系统(ICU)、急诊科(ED)、胸片影像与报告(CXR)、心电波形(ECG)、去标识化临床自由文本(Note)。其中 Hosp 与 ICU 是 MIMIC-IV 主数据集自带的两个核心模块(官方口径"two modules: hosp, and icu"),ED/CXR/ECG/Note 则是同一家族下需在 PhysioNet 单独签 DUA 申请的扩展数据集;另有旧版本 MIMIC-III(数据止于 2012 年)仍在维护、供历史研究迁移,官方明确建议新研究直接使用 MIMIC-IV。
与调查类数据库不同,MIMIC 的每一条记录都来自真实临床场景:不是问卷里的"您睡眠如何",而是监护仪逐小时记录的心率;不是"您是否在用降压药",而是哪一分钟推注了哪一毫克去甲肾上腺素。这种粒度让它成为重症预测模型、临床决策支持、器官支持策略研究里被广泛引用的公开 ICU 数据集。
02 拿到它:免费,但要先完成认证
MIMIC 不收费,但也不是"点一下就能下载"——PhysioNet 对受保护健康信息(PHI,Protected Health Information)设有"认证访问"(credentialed access)机制,需先完成下列流程:
- 注册 PhysioNet 账号(官方提示:机构邮箱非必需,但有助于通过审核)
- 完成 CITI(美国高校医院通用的在线伦理培训平台)"Data or Specimens Only Research" 模块培训——官方指定的人体受试者保护课程,在线完成;提交时需上传 CITI Completion Report(完成报告),不能只交证书
- 提交认证申请并等待审核——官方口径通常 1-2 周;通过后再登录数据集页面在线签署 DUA(Data Use Agreement,数据使用协议)
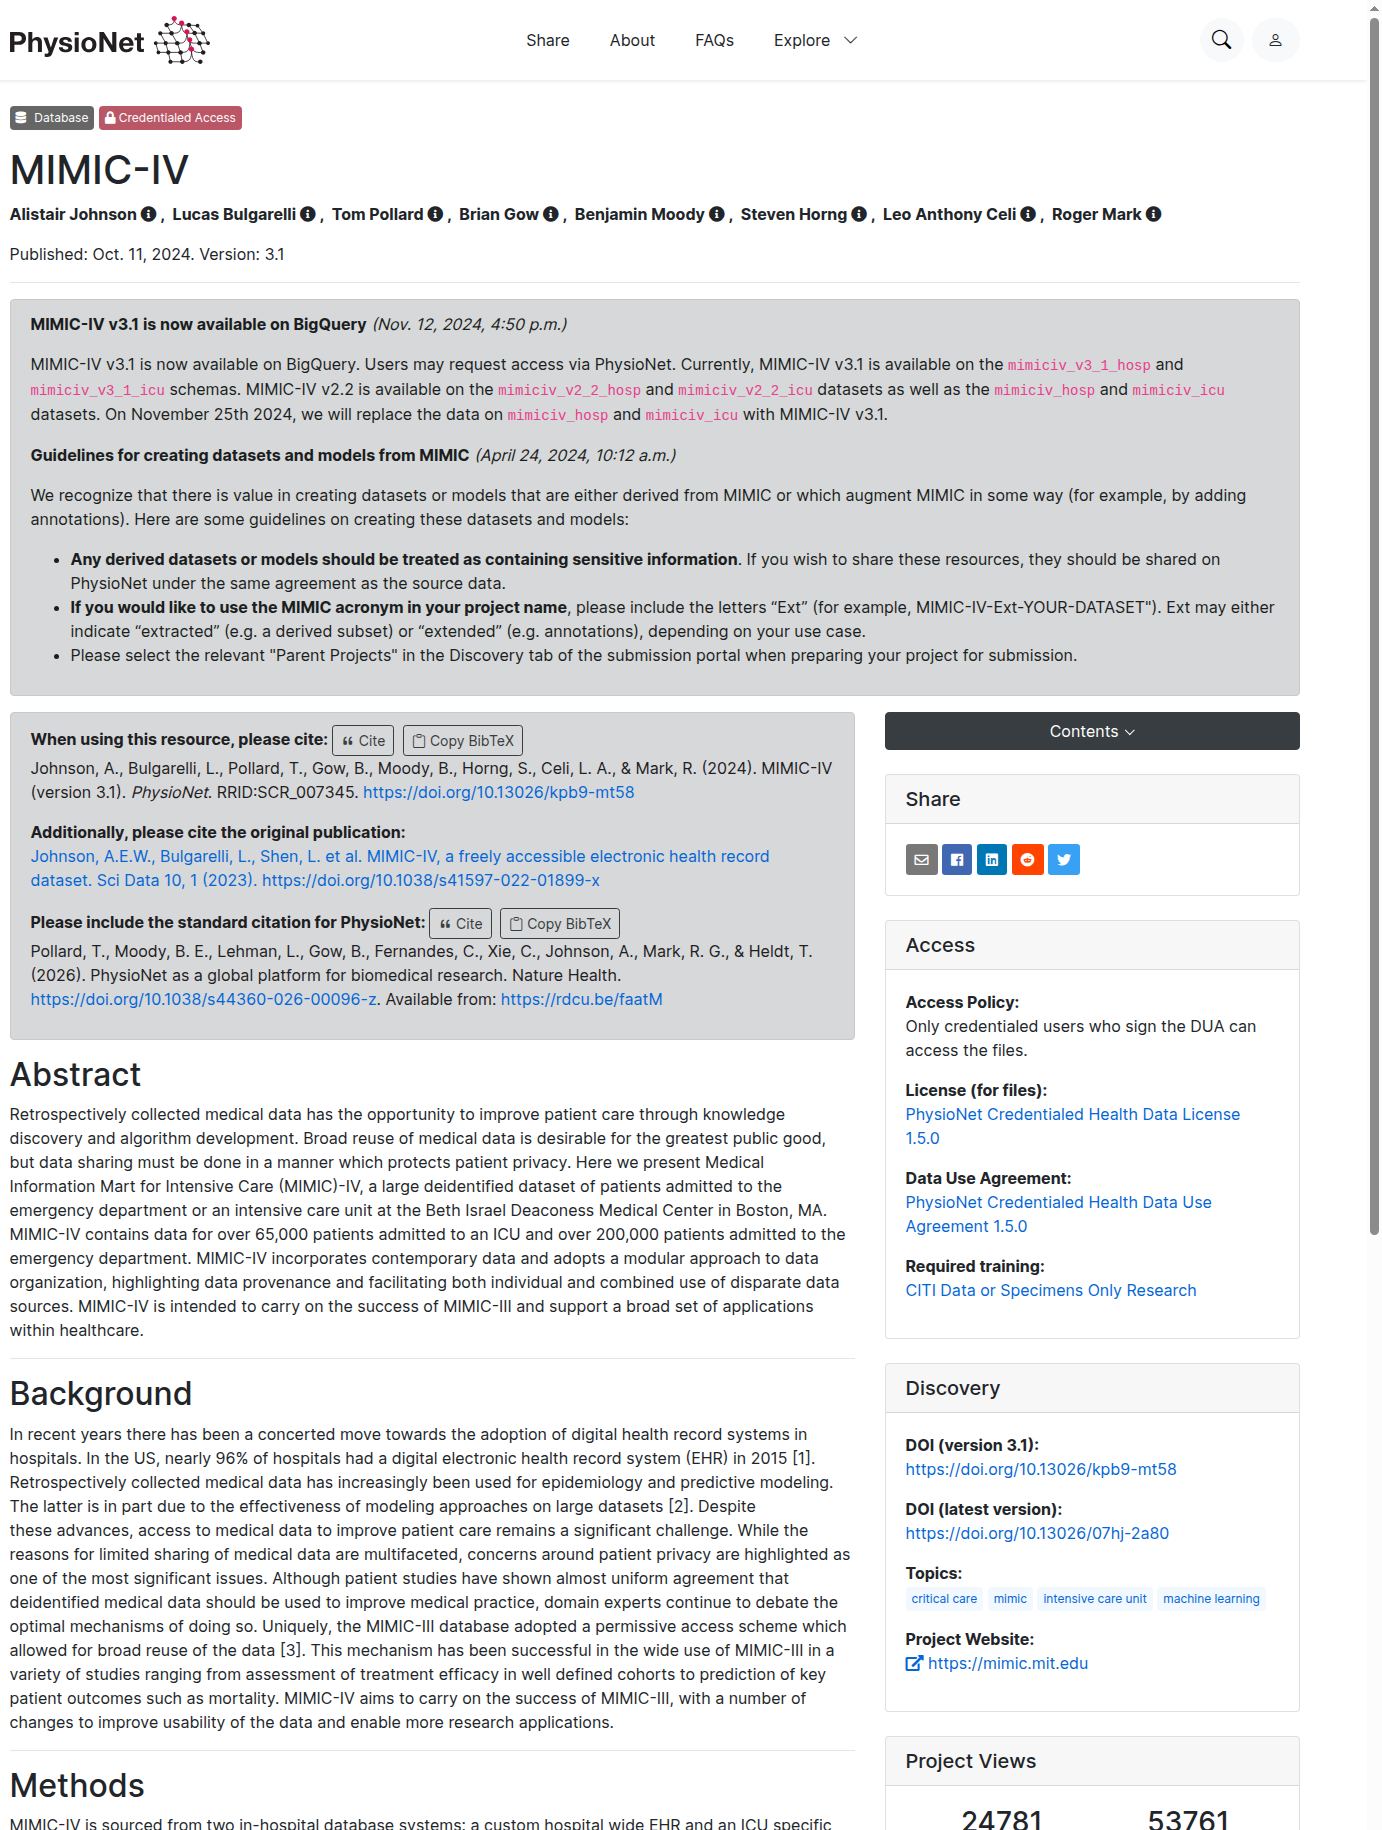
通过认证后,数据文件(CSV 格式压缩包,体量较大)直接在 PhysioNet 页面下载;官方同样推荐云端访问——提供 Google BigQuery、AWS、Google Cloud Storage 三种方式,其中 BigQuery 最适合直接写 SQL 查询。国内研究者同样可以申请——但要预留认证等待期,不要把选题启动和认证下载排进同一周。
03 看懂它:三级 ID 与多模块联用
MIMIC-IV 的数据结构比前三个数据库复杂得多,核心是三级标识。直观地说,它就是一张张按时间戳排列的记录表——"某患者、某时刻、某项测量",海量数据行靠这些 ID 串联:
- subject_id:一位患者(同一人可能多次住院)
- hadm_id:一次住院(住院期间可能进出 ICU 多次)
- stay_id:一次 ICU 入住(最小分析单元)
常用表各司其职:patients(人口学)、admissions(住院记录)、icustays(ICU 入住)、chartevents(床旁监护的生命体征与仪器读数,通常约每小时记录一条、时间戳精确到分钟,是最大的一张表——官方文档标注 313,645,063 行,约 3.1 亿)、labevents(实验室化验)、inputevents/outputevents(液体出入量)、prescriptions(处方)、diagnoses_icd(ICD 诊断编码,即国际疾病分类的标准编码)。跨模块分析(如"ICU 患者同时合并的 ED 分诊信息")靠这些 ID 联表完成。
官方在 GitHub 维护了 mimic-code 仓库,把常用的派生视图(如 SOFA(序贯器官衰竭评估)评分、脓毒症标记、首次入 ICU 24 小时指标汇总)做成了现成的 SQL——SQL 是操作数据库的查询语言,"物化视图"则是把常用统计预先算好存成表,跑查询时直接复用——不要从零写,先读 mimic-code。
04 用对它:时间对齐是最大技术难点
MIMIC 的深度是把双刃剑。四个必须正面处理的问题:
- 时间窗对齐:做"入 ICU 24 小时内预测死亡率",要精确定义"入 ICU 时刻"为 t=0,所有特征落在 [t0, t0+24h],标签落在 [t0+24h, 出院]——时间窗稍有偏差就构成数据泄漏
- 缺失与频次不均:不是每个患者每小时都有血压记录,缺失本身携带信息("没测"往往意味着病情稳定)——填补策略(前向填充/插值/缺失指示变量)会显著改变结果
- 版本对应:MIMIC-III 与 MIMIC-IV 的表结构不同,III 时代的经典代码迁移到 IV 需要逐表核对
- 规模:chartevents 有 3 亿多行,本机 Excel/Python 直接读会爆内存——应先用 SQL 在 PostgreSQL(一种开源数据库软件)或 BigQuery(谷歌云的数据库服务)里筛出目标队列与变量,再做分析
05 做研究:MIMIC 高频发文方向
- 重症预后预测:ICU 死亡率、28 天死亡率、再入院、机械通气时长的机器学习预测——发文量很大
- 临床评分比较与优化:SOFA、APACHE II、qSOFA(ICU 常用的三种危重症严重程度评分)在特定亚组中的表现比较,或构建简化新评分
- 动态轨迹与亚型发现:脓毒症/AKI(急性肾损伤,Acute Kidney Injury)患者的生理轨迹聚类,识别异质性亚型
- 治疗策略评价:血管活性药物、液体复苏、镇静策略的早期启动时机与结局
- 多模态研究:CXR 影像 + Note 文本 + 结构化指标的联合建模
能力边界必须写清:单中心(数据只来自 BIDMC 一家医院)回顾性(基于既有病历记录事后汇总,而非前瞻设计)数据,结论外推到其他医院/其他国家需谨慎;回顾性观察研究不能回答因果;编码与录入误差存在;DUA 禁止再识别患者与数据二次分发——论文图表里不能出现任何可识别信息。
06 发论文:重症 AI 的高产数据源,也是方法学的试金石
MIMIC 是重症 AI 论文被广泛引用的数据集,也被审稿人"审美疲劳"——纯"用 XGBoost(一种常用机器学习模型)预测死亡率"的套路文章已很难出彩。差异化在临床问题本身:问一个 ICU 医生真的关心的问题(如"哪种患者能从早期液体复苏中获益"),比把模型从 XGBoost 换成 Transformer(一类深度学习架构)更有价值。
我们辅导的常规路径:选题查新与临床问题凝练(1-2 周)→ 认证、下载与队列构建(2-4 周)→ 特征工程、建模与敏感性分析(3-6 周)→ TRIPOD/PROBAST 规范写作与投稿(5-8 周)。导师一对一示范,从 PhysioNet 认证到投稿全程把关,分析与写作由你本人完成。
下一篇讲 SEER——美国国家癌症研究所的肿瘤登记数据库,肿瘤流行病学研究的重要入口。关注医嘉研科研资讯,九大临床公共数据库逐个讲透。