
想做一篇覆盖全球的流行病学研究,却连一个病例都没有?GBD(全球疾病负担研究)就是为此而生:它不采集任何个体数据,而是把全球各国的疾病与死亡登记、健康调查和科学文献建模成一套覆盖 204 个国家/地区、跨越 30 余年的标准化估算。它是公共数据库里独特的"二手数据之王",也是发表流行病学与卫生政策方向 SCI 的高产数据源。这篇沿用系列老规矩——认识它(01)→ 拿到它(02)→ 看懂它(03)→ 用对它(04)→ 做研究(05)→ 发论文(06),先看图。
全称:Global Burden of Disease Study(全球疾病负担研究)
主持机构:健康指标与评估研究所(IHME,Institute for Health Metrics and Evaluation)——华盛顿大学医学院下设的独立研究机构
主要资助:比尔及梅琳达·盖茨基金会、华盛顿州政府等(2007 年共同出资创立 IHME)
官网:https://www.healthdata.org/research-analysis/gbd
数据工具:https://vizhub.healthdata.org/gbd-results/(免费注册登录后使用,限非商业用途)
在线可视化:https://vizhub.healthdata.org/gbd-compare/(GBD Compare,注册后使用)
最新版本:GBD 2023(2025 年 10 月发布),估算时间跨度 1990-2023 年
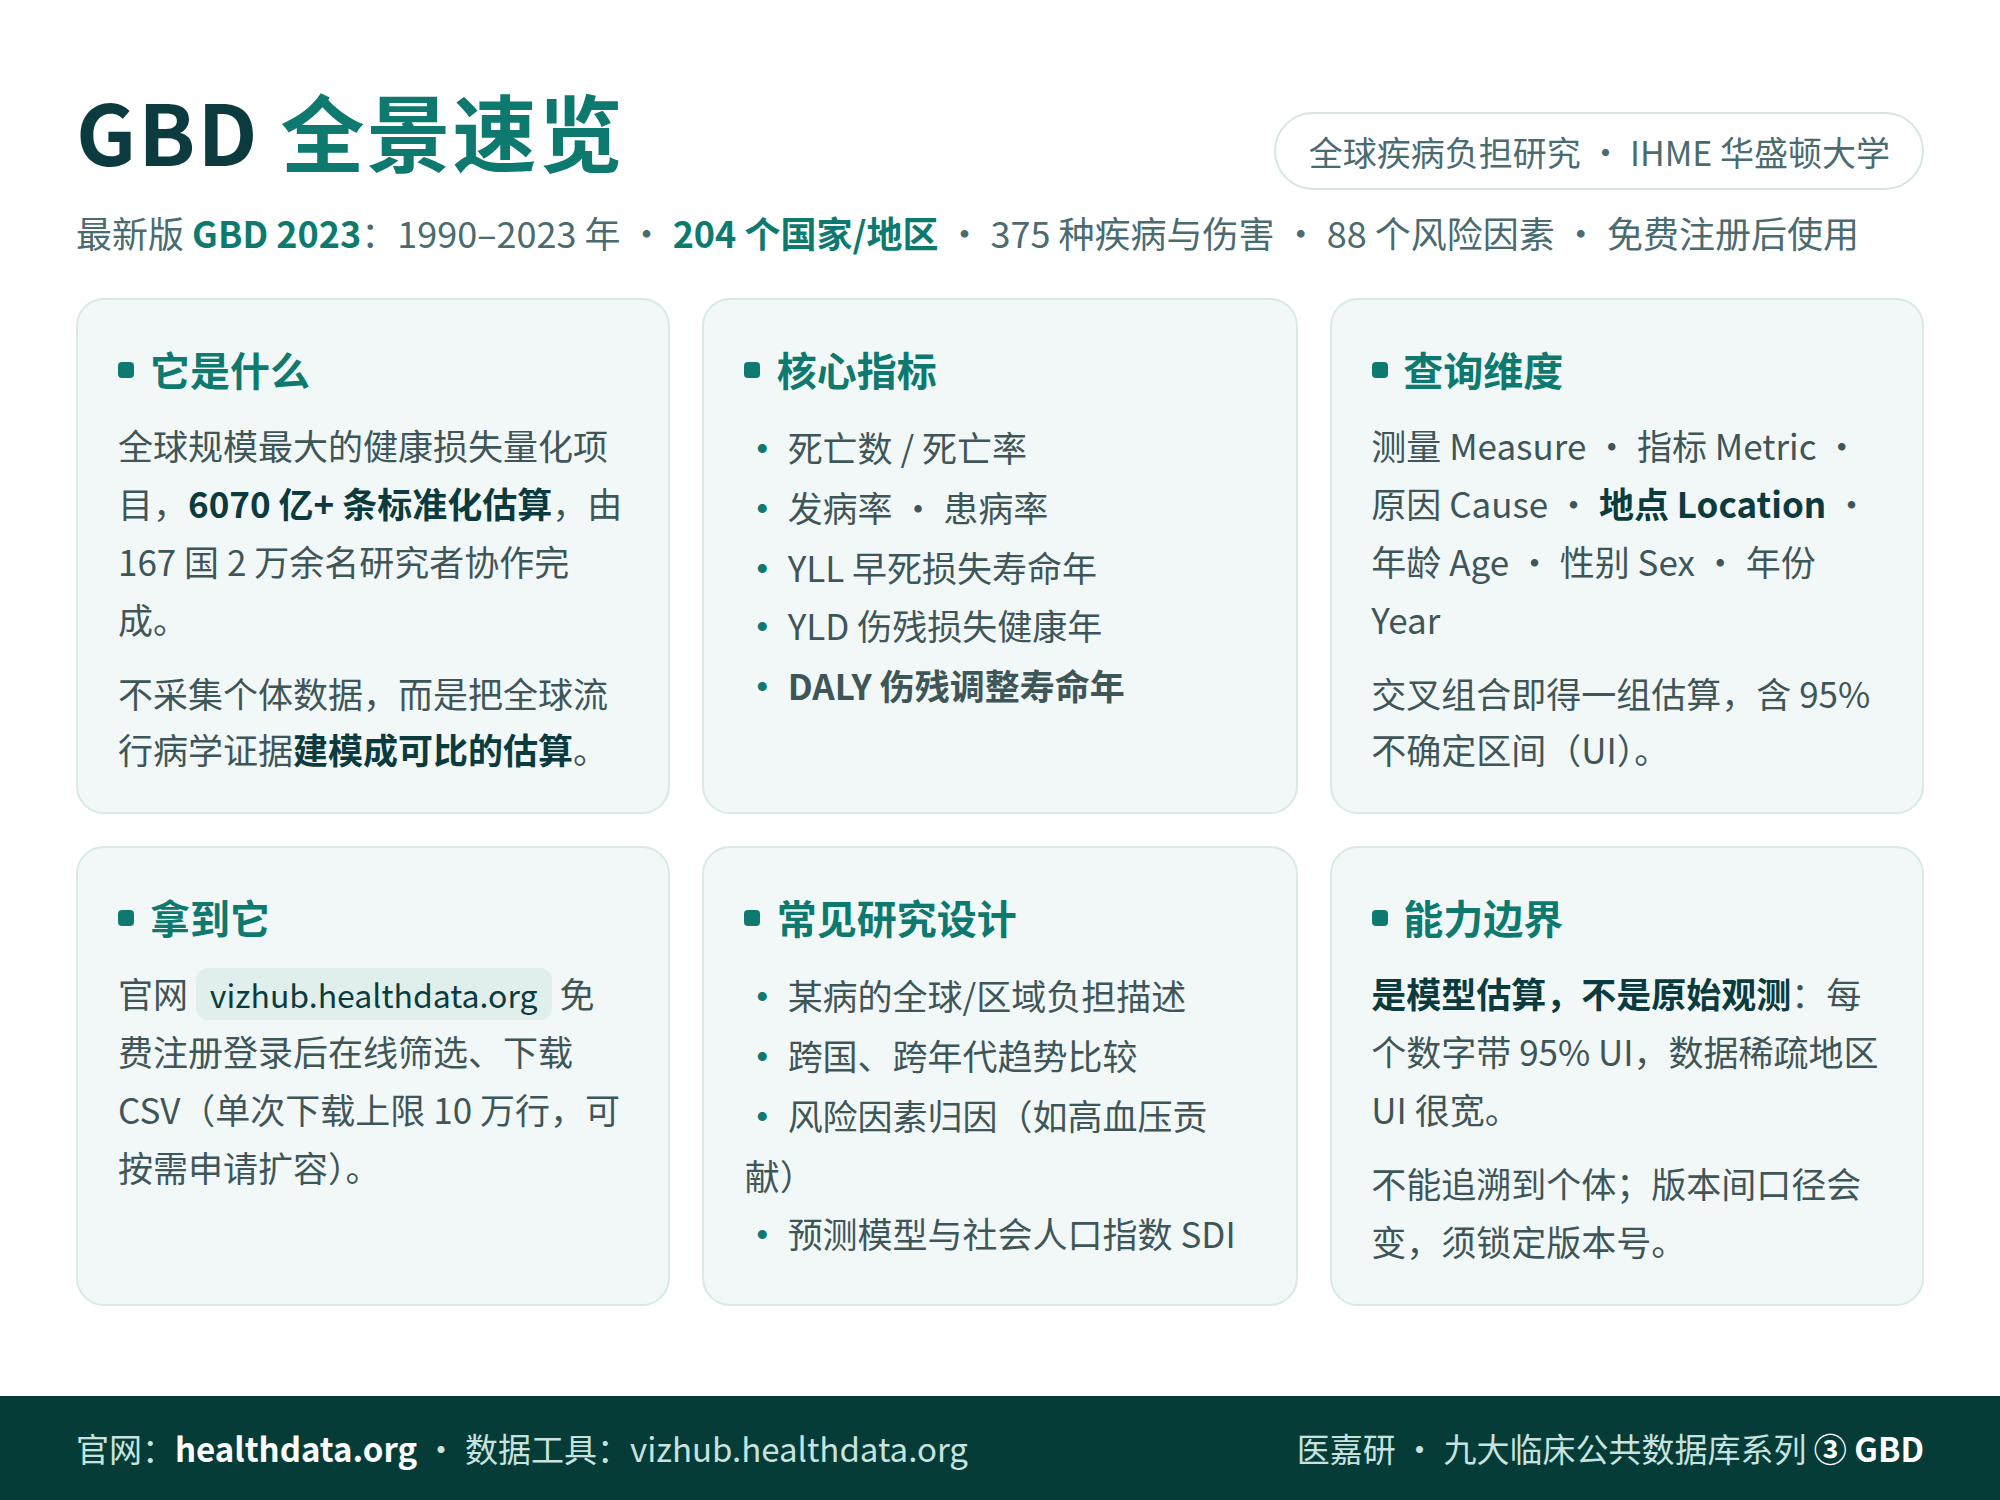
01 认识它:6070 亿条估算拼出的世界健康图景
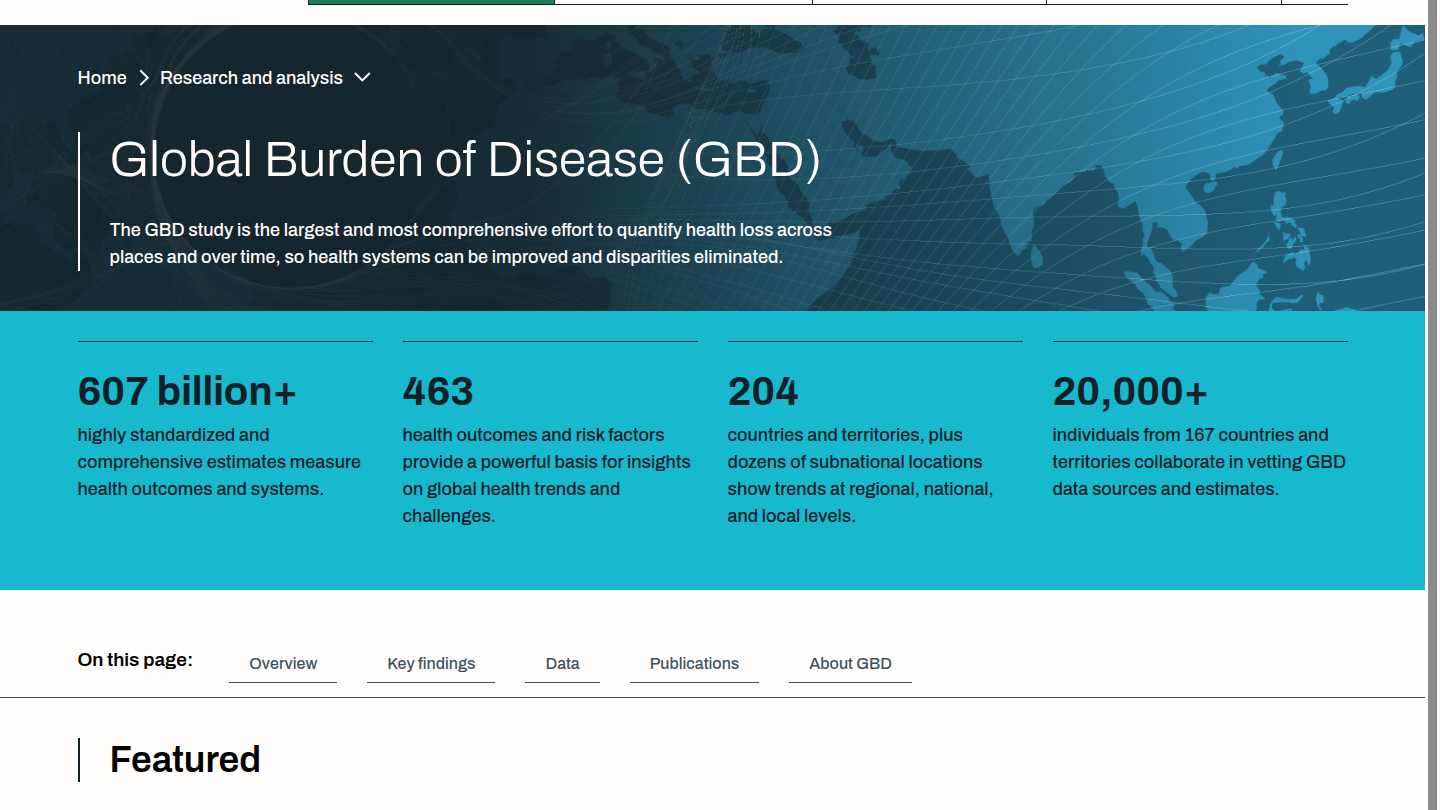
GBD 是全球规模最大的健康损失量化项目。官网挂着四个数字:6070 亿+ 条高度标准化的估算、463 项健康结果与风险因素、204 个国家/地区(含 660 个次国家级地点)、2 万多名来自 167 国的协作研究者。最新一轮 GBD 2023 覆盖 375 种疾病与伤害、88 个可干预的风险因素,时间跨度从 1990 年到 2023 年——官方称这轮结果描绘了新冠疫情之后世界健康状况的完整图景。
它与前两篇的 NHANES、CHARLS 有本质不同:GBD 没有原始个体数据。IHME 团队把各国的生命登记、流行病学调查、疾病登记、科学文献等超过 31 万个数据源汇总,用 DisMod-MR(一种贝叶斯元回归模型)等工具,为每一种"疾病 × 地区 × 年龄 × 性别 × 年份"组合计算出统一的估算值。你拿到的每个数字都带 95% 不确定区间(UI)——数据越稀疏的地区,区间越宽。
02 拿到它:Results 工具在线筛选下载
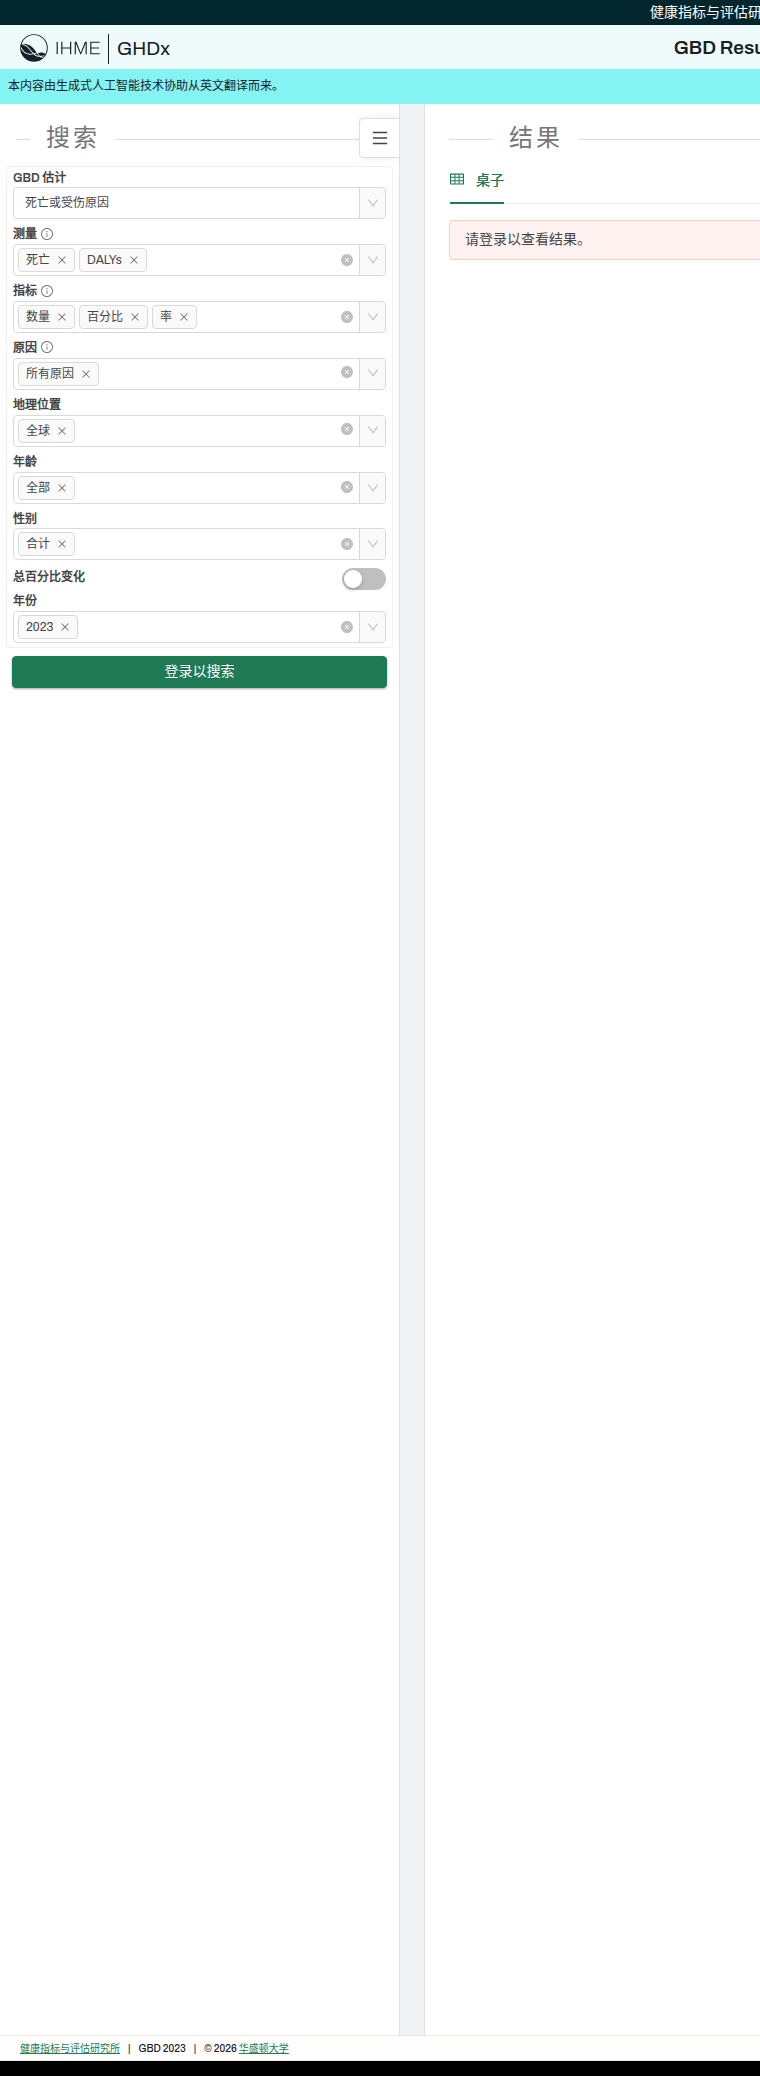
GBD 的官方数据入口是 GBD Results 工具(vizhub.healthdata.org/gbd-results/)。左侧筛选面板里依次选好七个维度——GBD 估计口径(GBD Estimate)、测量(Measure)、指标(Metric)、地理位置(Location)、年龄(Age)、性别(Sex)、年份(Year,1990-2023)——先在"估计口径"里定下要查哪类结果(死因、风险因素、健康期望寿命、人口/生育等),具体病种和危险因素再在随之出现的"原因(Cause)"下拉里勾选。交叉组合后,工具返回网页数据表和折线图,也可下载 CSV;注意网页表格显示的是四舍五入后的数值,完整精度的结果以下载文件为准。
两点使用须知:其一,官方要求所有用户注册账号(免费)并登录后才能查询和下载数据;其二,下载有上限——单次请求最多 10 万行,参数选太多会报错,需要更多数据可向官方提交扩容申请(公开用户按次批准,每次增加 10 万行)。想一次性获取大体量数据,可到 GHDx(IHME 的全球健康数据编目库)的 GBD 2023 专题页(ghdx.healthdata.org/gbd-2023)下载官方打包好的部分结果文件。
不急着下载、想先在线"逛一逛"数据,可用姊妹工具 GBD Compare(vizhub.healthdata.org/gbd-compare/):用地图、树图、箭头图等十几类图表直观比较各国、各年龄性别的疾病模式与时间趋势,同样注册后使用。
03 看懂它:五个核心指标与分级目录
读懂 GBD 先理解五个核心指标:
- 死亡数与死亡率:最直接,但只反映致命结局
- 发病率(Incidence)与患病率(Prevalence):描述疾病在人群中的存在规模
- YLL(早死损失寿命年):因早死而损失的寿命年数,= 死亡数 × 该年龄的标准期望寿命
- YLD(伤残损失健康年):带病生存的质量折损,= 患病数 × 伤残权重
- DALY(伤残调整寿命年)= YLL + YLD:GBD 的标志性综合指标,一把尺子量所有疾病
除以上五个指标外,GBD 还提供期望寿命(Life Expectancy)与健康期望寿命(HALE,即在"完全健康"状态下预期可活的年数)等汇总指标,可用来区分"活得长"与"活得健康"。
疾病和伤害按四级分层目录组织(Level 1-4):Level 1 只有三大类(传染/母婴/营养、非传染性疾病、伤害),往下逐级细分到具体病种。风险因素同样按分层目录组织,顶层分行为、代谢、环境/职业三大类。层级选择直接决定结果粒度——选 Level 1 只能做大趋势,选 Level 3/4 才能落到具体病种。
04 用对它:它是模型,不是观测
GBD 数字是模型估算,用对它必须守住三条:
- 永远带上不确定区间:报告估算时附上 95% UI,数据稀疏地区(如部分非洲国家)的 UI 可能非常宽——只报点估计是对读者的误导
- 锁定版本号:每一轮 GBD 都会回算历史年份,2021 版的"2010 年估算"和 2023 版的"2010 年估算"并不相同。论文方法部分必须写明用的是 GBD 2023,引用那一年的数据
- 理解它是"可比性"工具而非"真值"来源:GBD 的价值在于跨国、跨年的标准化可比,而非还原某一个数字的精确真实值
分析层面的常规操作:用年龄标准化率(age-standardized rate, ASR)做跨国比较消除人口结构差异;用 EAPC(估计年变化百分比,estimated annual percentage change)刻画时间趋势;用 SDI(社会人口指数,Socio-demographic Index)把地区按发展水平分层——这三件套是 GBD 论文方法学的标准配置。
05 做研究:GBD 高频发文方向
- 单病种全球负担描述:某癌症/慢病在全球与中国的负担、分布与趋势——发文量最大的入门方向
- 风险因素归因分析:如"高血压贡献了全球多少疾病负担"、"空气污染与卒中"的归因 DALY 与死亡
- 跨国/跨区域比较:中国与美国、金砖国家之间、一带一路沿线国家的同病种负担差异
- 时间趋势预测:用 GBD 历史数据拟合 ARIMA(时间序列)或 BAPC(贝叶斯年龄-时期-队列)模型预测未来 10-20 年负担
- 疾病间关联与共病负担:如糖尿病与痴呆、抑郁与慢病的负担叠加分析
能力边界同样明确:不能做个体层面的因果推断(它连个体数据都没有);数字是模型产物,结论的稳健性完全取决于对 UI 和版本口径的交代;同一病种的定义在 GBD 与临床实践之间常有差异(如 GBD 的"糖尿病"口径与临床诊断口径不同),写作时要对齐。
06 发论文:高产,但也最拥挤
GBD 是国内公共数据库发文竞争最激烈的方向之一——免费、标准化、覆盖全病种,意味着入门门槛低,也意味着任何热门病种都有几十上百篇同类研究。差异化空间在分析设计:把一个病种的"描述"做成"分解分析"(如把负担变化拆解成人口增长、老龄化、流行病学变化三部分),或叠加 SDI 不平等分析、前沿分析(frontier analysis),文章的方法学含量就完全不同。另需留意官方规则:为撰写"全球层面论文"(覆盖全球或大多数国家的分析)申请扩大下载限额,官方明确不予批准,这类论文按其发表政策由 GBD 合作网络主导;撰写国家级、区域级论文则可正常提交扩容申请。
我们辅导的常规路径:选题查新与差异化设计(1-2 周)→ Results 工具数据下载与清洗(2-3 周)→ ASR/EAPC/SDI 标准分析与可视化(3-5 周)→ GATHER(健康估算报告规范,Guidelines for Accurate and Transparent Health Estimates Reporting)写作与投稿(5-8 周)。导师一对一示范与把关,分析与写作由你本人完成。
下一篇讲 MIMIC——和前三个完全不同:它来自波士顿一家医院的真实 ICU,记录的是单个患者床旁逐小时的生命体征与检验数据。关注医嘉研科研资讯,九大临床公共数据库逐个讲透。