
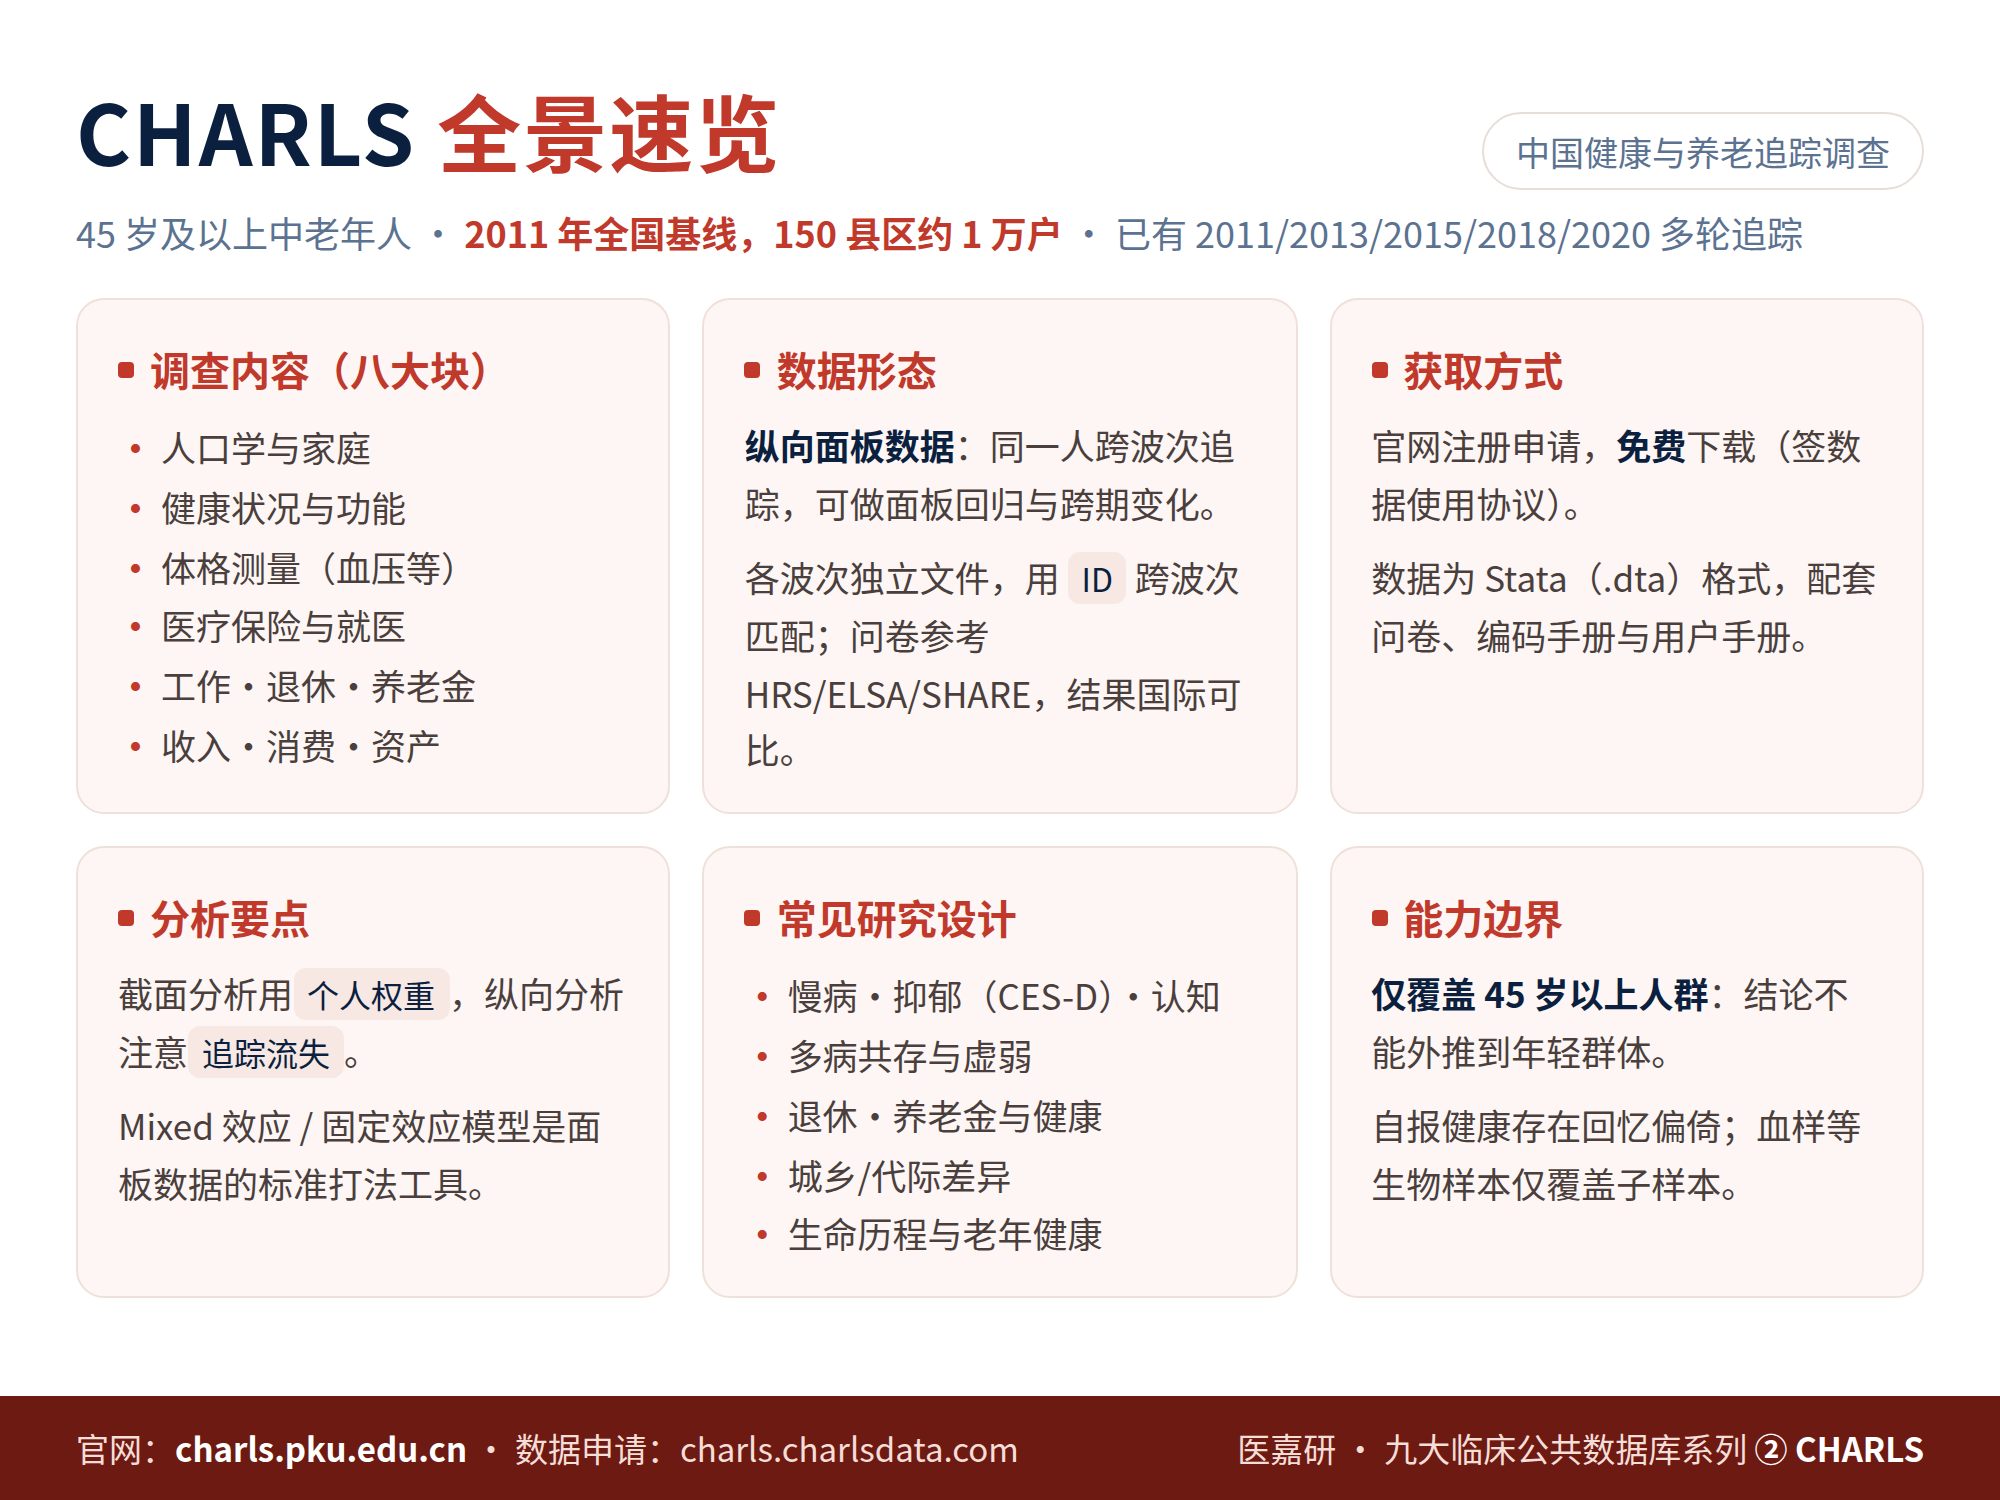
不想做实验、也没有临床病例,还想发 SCI?除了 NHANES,中国自己就有一个国际级的选择:CHARLS(中国健康与养老追踪调查)。它聚焦中国 45 岁及以上中老年人(含其配偶),是研究"中国老龄化"绕不开的数据源,官网也称其数据"在学术界得到了广泛的应用和认可"。这篇沿用老规矩讲清楚它——认识它(01)→ 拿到它(02)→ 看懂它(03)→ 用对它(04)→ 做研究(05)→ 发论文(06),先看图。
全称:China Health and Retirement Longitudinal Study(中国健康与养老追踪调查)
执行机构:武汉大学和北京大学共同执行(国家自然科学基金委资助的重大项目)
官网:https://charls.pku.edu.cn/
获取方式:注册申请,免费下载(签署数据使用协议)
调查对象:45 岁及以上中老年人及其配偶;全国基线覆盖随机抽取的 150 个县区、450 个村居、约 1 万户家庭、约 1.7 万人
01 认识它:中国版的 HRS,专为老龄化研究而生
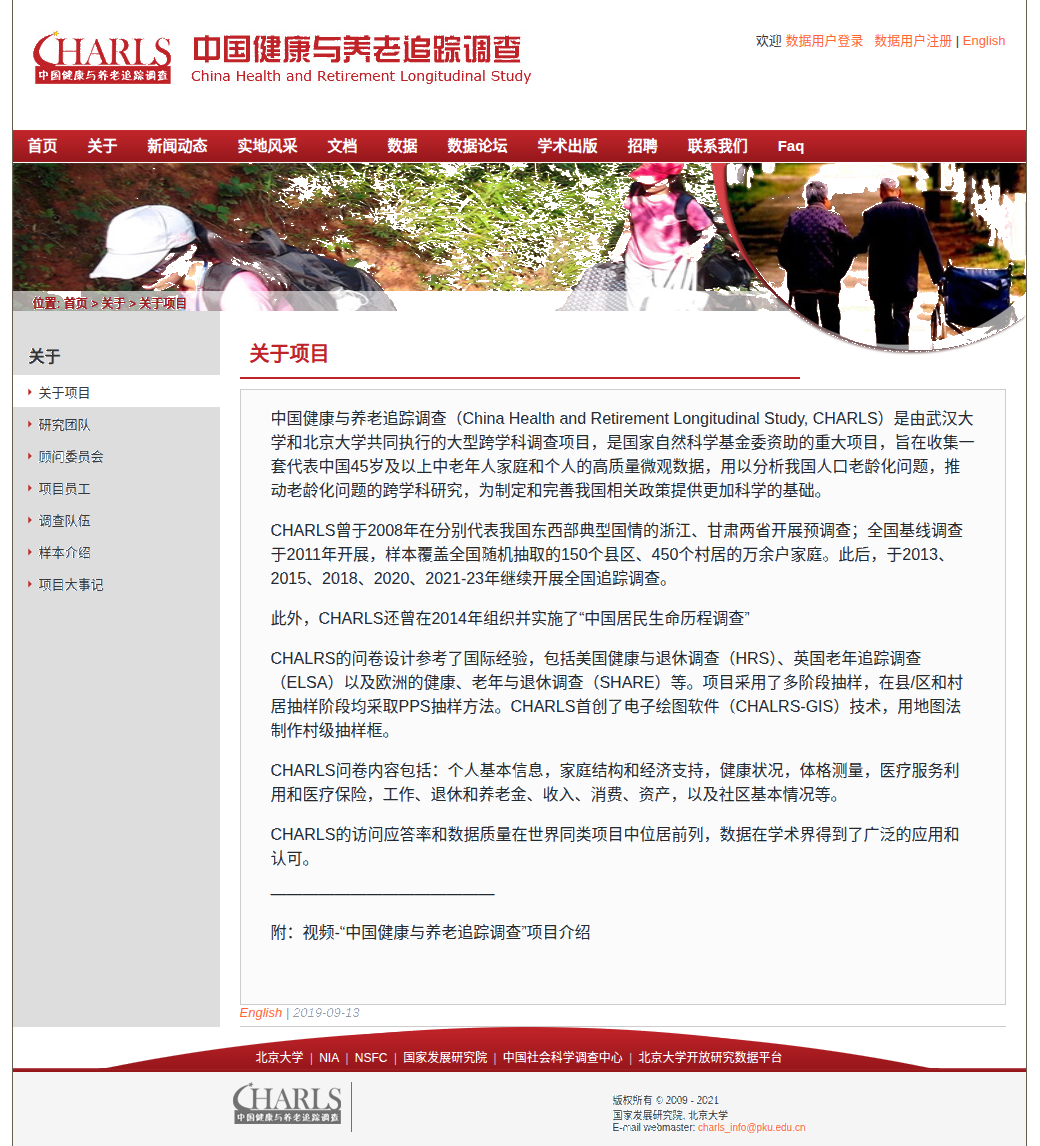
CHARLS 是由武汉大学和北京大学共同执行的大型跨学科调查项目,是国家自然科学基金委资助的重大项目(官网页脚版权署名为"国家发展研究院,北京大学")。2008 年先在浙江、甘肃两省开展预调查,2011 年开展全国基线调查(baseline,即作为后续追踪起点的那次调查):覆盖 150 个县区、450 个村/社区,访问约 1 万户家庭、约 1.7 万人;抽样分县(区)—村(居)—家户—个人四个阶段,前两级采用 PPS 抽样(按人口规模成比例的概率抽样,抽中的村/社区即初级抽样单位 PSU)。此后在 2013、2015、2018、2020、2021-2023 年持续开展全国追踪调查——同一批人每两到三年随访一次,形成宝贵的纵向面板数据(panel data:对同一批人反复测量、能跨年份追出个人轨迹的数据;与之相对,只看某一个时间点的叫横截面数据)。
它的问卷设计参考了国际同类调查的经验:美国的 HRS(Health and Retirement Study,健康与退休研究)、英国的 ELSA(English Longitudinal Study of Ageing,英国老年追踪调查)、欧洲的 SHARE(Survey of Health, Aging and Retirement in Europe,欧洲健康、老年与退休调查),官网英文版也明确写着:CHARLS"基于 HRS 及同类老龄调查"。变量口径与这些调查相近,意味着你用 CHARLS 做的研究,可以直接和全球老龄化研究对话——这是它优于一般自建队列的地方。
对中国研究者还有一个现实优势:研究对象是中国人群。中老年慢病、养老保障、城乡健康差异这些本土议题,用 CHARLS 写出来的论文天然更"对症",也更容易讲出 NHANES 讲不了的中国故事。
02 拿到它:注册申请,免费下载
CHARLS 数据在官网注册申请后免费下载。具体流程按官网 FAQ 的说明:注册时在网站上签署用户数据使用协议并提供个人信息,然后到邮箱点击确认邮件激活账号;之后可以分别申请公开发布的各轮调查数据,申请会在 3 个工作日内得到是否批准的答复。
首页导航的"数据"栏目按波次(wave,即一轮调查)组织,每个波次点进去都有配套的问卷、用户手册与数据编码参考书。目前已公开发布的全国调查数据覆盖 2011 年基线、2013、2015、2018、2020 各轮追踪(2020 年轮于 2023 年 11 月发布,文件中还包括一个"疫情模块"),另有 2014 年"中国居民生命历程调查"、2008 年两省试调查、2012 年两省追踪调查,以及由 Gateway to Global Aging 项目整理的 Harmonized CHARLS(跨波次统一变量版)。官网"关于项目"页还提到 2021-2023 年开展的新一轮全国追踪调查;截至本文定稿,数据区公开发布的最新一轮仍是 2020 年,写论文引用数据时,请以官网数据区的最新版本为准。
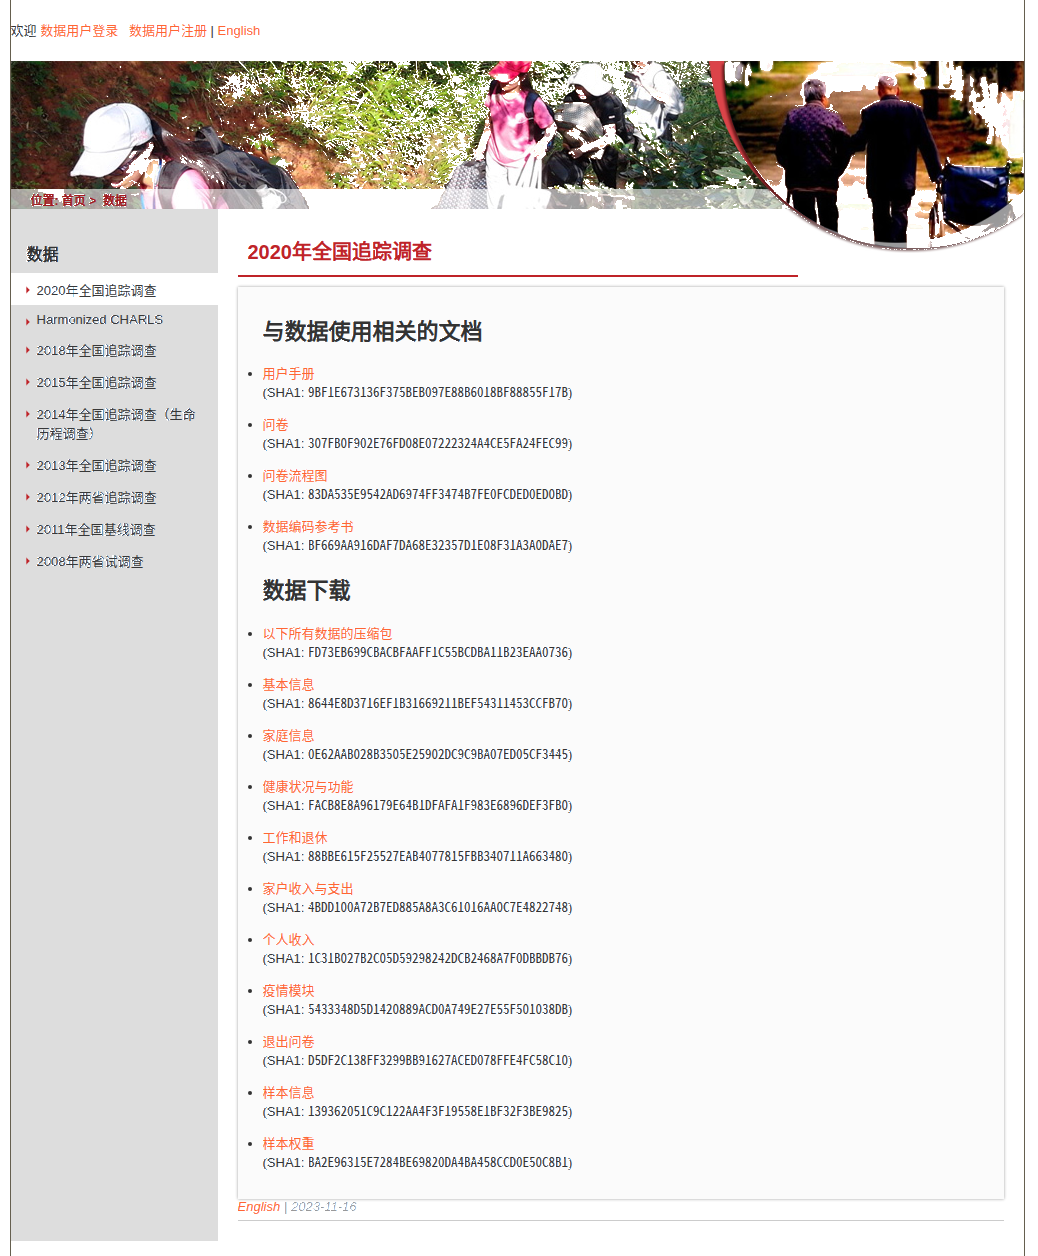
两个使用建议:一是下载后先读用户手册,CHARLS 的变量跨波次会有更名与调整,手册里写清了对应关系;二是关注官网"学术出版"栏目,里面按年份收录了中文期刊论文、英文期刊论文等已发表成果清单——查选题新颖性时,先看你想做的方向已经被谁做过、做到什么程度。
数据格式上,官网 FAQ 明确:数据库是 Stata(.dta)格式,按波次和模块分文件提供。安装 Stata 即可直接打开;用 R 的读者可以加载 haven 包读取 .dta 文件;如果要用其他软件,可以先把 .dta 转换成对应的格式。数据分析中遇到问题,可以先翻用户手册,也可以到官网的 CHARLS 数据论坛检索或提问。
03 看懂它:八大模块与跨波次匹配
CHARLS 的问卷内容覆盖八大板块:
- 人口学背景:年龄、性别、教育、婚姻、户籍(城镇/农村)
- 家庭结构:家庭成员、代际经济往来
- 健康状况:自评健康、医生诊断的慢性病(高血压、糖尿病、心脏病、中风、关节炎等十余种)、ADL/IADL 功能(日常生活活动与工具性日常生活活动,如穿衣、洗澡、做饭、管钱,衡量能否独立生活)、抑郁量表 CES-D 10(10 题版流调中心抑郁量表)、认知功能测验
- 体格测量与生物样本:血压、身高体重、握力、峰值呼气流速(一口气吹出的最大气流速度,反映肺功能)等体检项目;部分波次还会采集血样,检测血糖、血脂、糖化血红蛋白等指标
- 医疗保险与就医:参保类型、门诊住院利用、自付支出
- 工作、退休与养老金:就业状态、退休类型、养老保险
- 收入、消费与资产:家庭收入结构、支出、住房资产
- 社区与省级行政代码:社区问卷记录村/社区的社会、经济与政策环境;行政代码可用来合并地区层面的经济、政策等外部数据
数据组织上是每个波次一套文件(人口学、健康、家庭等分文件),跨波次分析时用个人 ID 匹配同一受访者的多期记录。初次合并面板数据的新手容易踩两个坑:变量名跨波次不一致(要用 Harmonized CHARLS 或编码手册对齐),以及把"曾参与某波次"误当成"每波次都在"(追踪是动态的,有人中途退出或失访)。
04 用对它:面板数据的正确打开方式
CHARLS 与 NHANES 最大的不同在于纵向结构。这带来两类规范用法:
- 截面分析:只用基线或某一波数据做患病率、关联分析——注意使用官网随数据发布的个人权重(cross-section weight,截面权重)做加权,维持全国代表性
- 面板分析:跨波次看"变化"——固定效应模型(消除个体不随时间变化的混杂)、混合效应模型、Cox 生存分析(以随访时间为轴)
纵向研究的特有风险是追踪流失(attrition):坚持留下来接受随访的人,往往和中途失访的人在健康等特征上系统性不同,直接用完整样本会引入偏倚。论文方法部分要报告每轮随访的留存率,讨论部分要交代流失的影响——审稿人几乎必问。
05 做研究:CHARLS 高频发文方向
- 心理健康:抑郁(用现成的 CES-D 10 量表即可算分)与慢病、睡眠、社会参与、代际支持的关联——CHARLS 的热门发文方向
- 认知功能:认知衰退的预测因素与保护因素,常与生活方式、慢病管理结合
- 多病共存与虚弱:多重慢病共存模式、虚弱指数(FI,用健康缺陷项目占比衡量整体脆弱程度)与健康结局
- 退休、养老金与健康:法定退休年龄前后的健康变化(可用断点回归这类准实验设计)、养老保险与就医行为
- 城乡与代际:农村老年人的医疗可及性、子女外出务工与留守老人健康
能力边界同样明确:人群限定 45 岁以上,结论不能外推到年轻群体;健康信息以自报为主,存在回忆偏倚;血检等生物样本为子样本,用之前要确认样本量与权重。选题时先把这三条边界想清楚,写作时主动交代,比被审稿人指出来体面得多。
06 发论文:国产数据的红利期与门槛
CHARLS 对中国研究者的红利很明显:本土议题 + 中国人群 + 国际可比量表,写出来的论文既符合国内职称评审的偏好,也投得出去。但红利期也意味着竞争——抑郁、认知这些热门方向的"常规组合"已经高度饱和,纯套路化的选题越来越难。
我们辅导的常规路径:选题查新与差异化设计(1-2 周)→ 数据申请与面板合并(2-4 周)→ 加权/面板统计分析与敏感性分析(3-5 周)→ STROBE(观察性研究报告规范)写作与投稿(5-8 周)。导师一对一示范,数据申请到投稿全程把关,分析与写作由你本人完成。
下一篇讲 GBD——不收集任何个体,却能量化全球 200 多个国家疾病负担的"怪才"数据库。关注医嘉研科研资讯,九大临床公共数据库逐个讲透。