
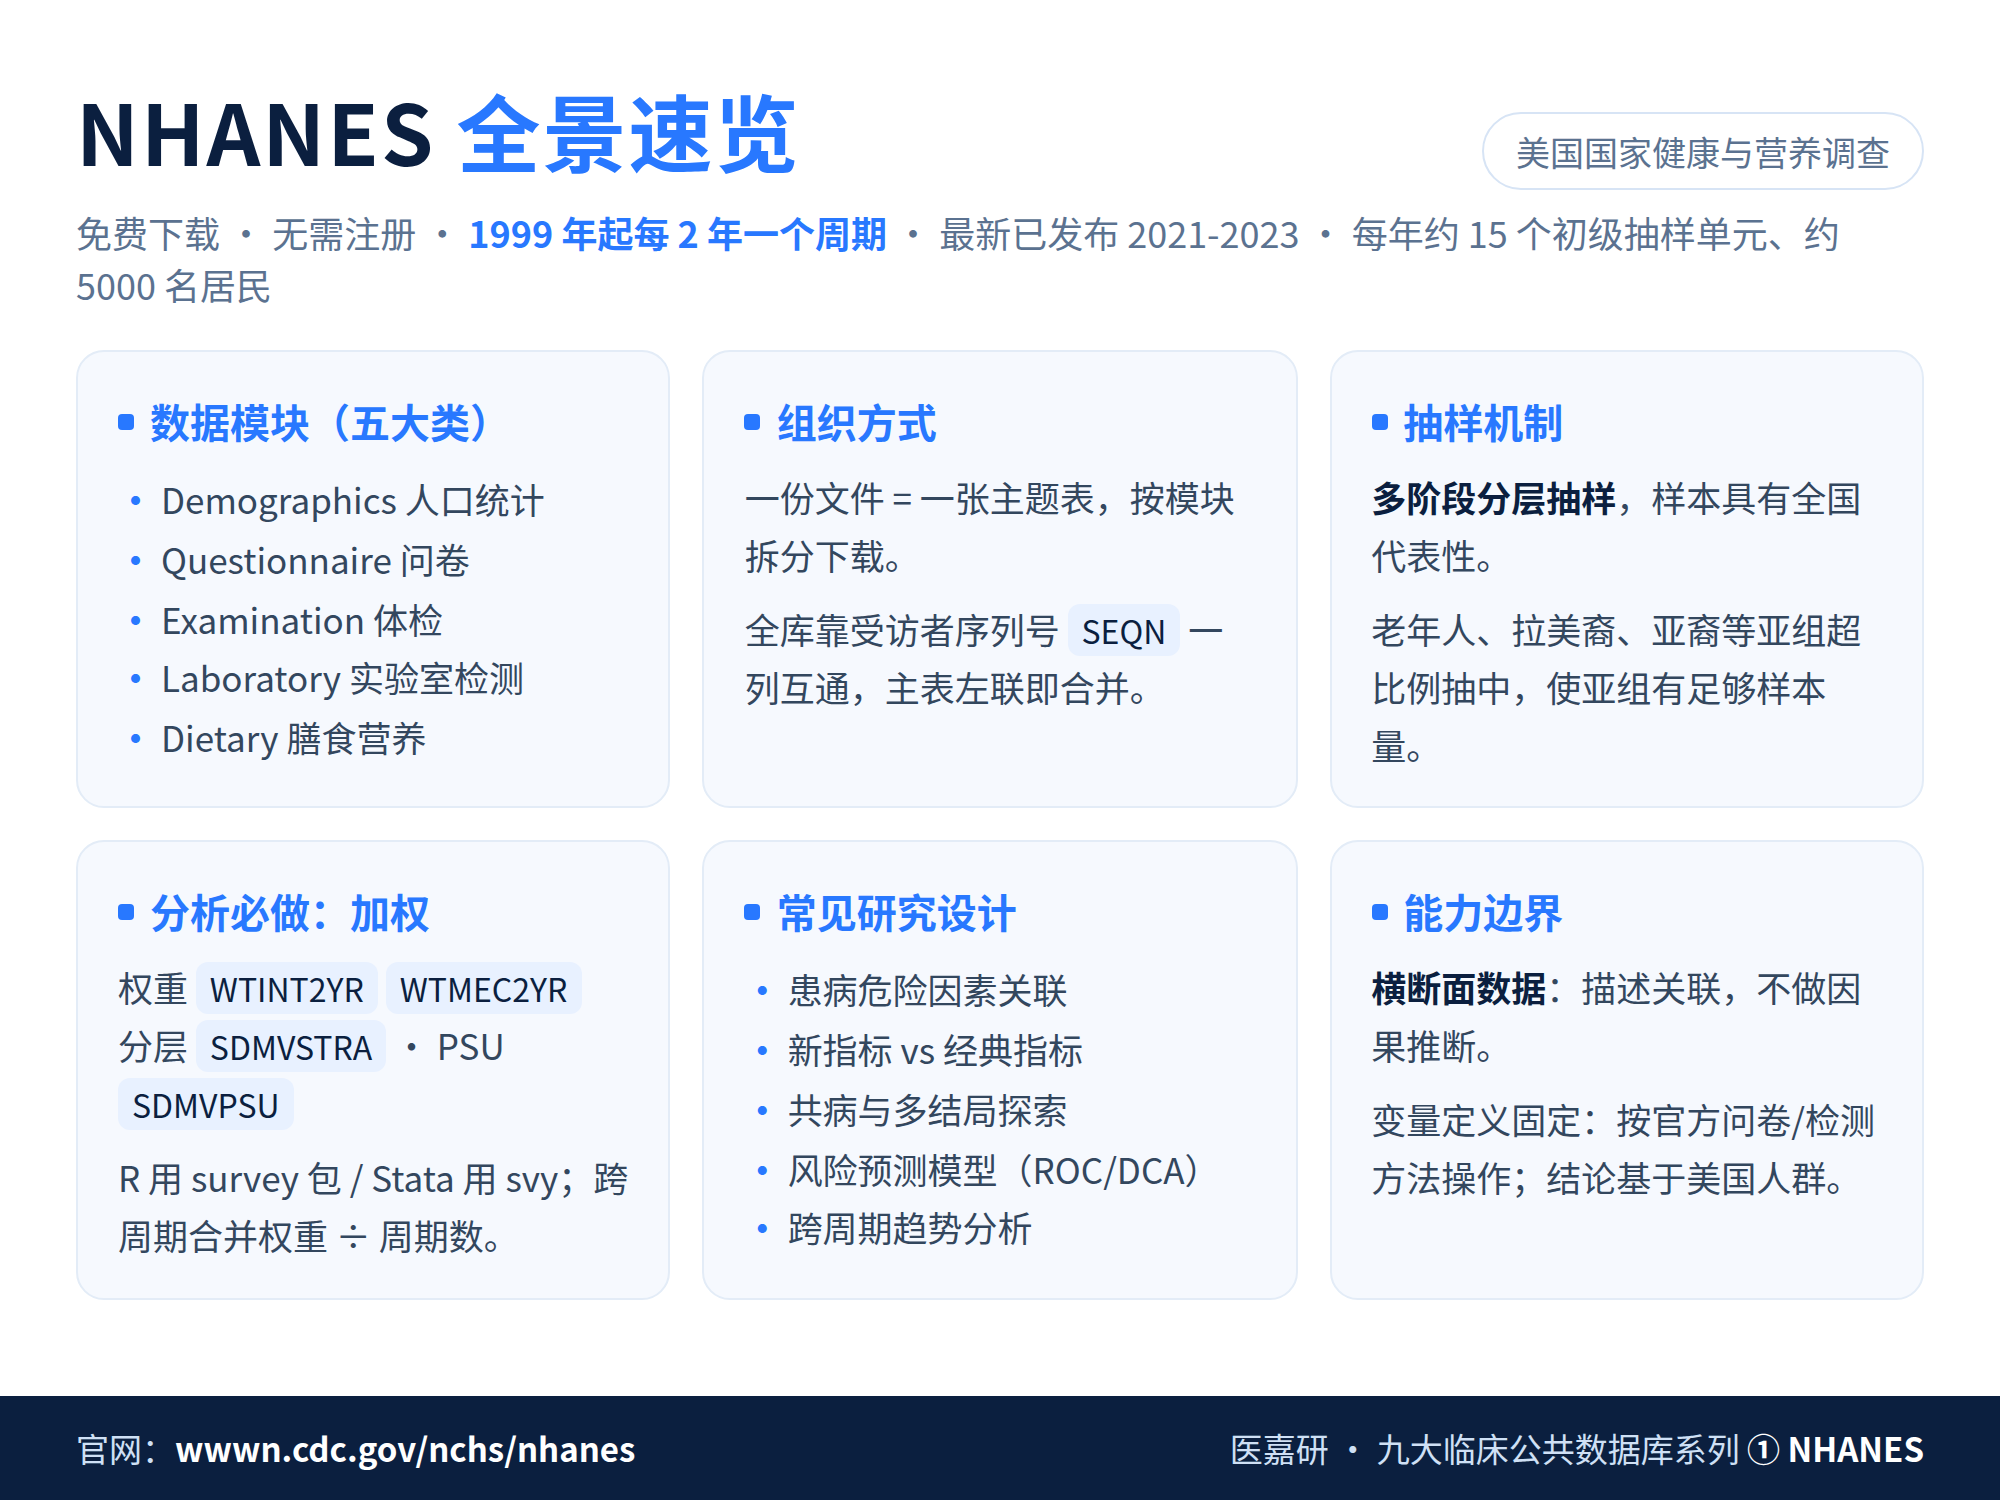
想在零病例积累的情况下发一篇 SCI?在临床研究人员中,NHANES 可能是被提及最多的词:美国官方开源、免费下载、样本量大、变量丰富。这篇按一条主线讲清楚它——认识它(01)→ 拿到它(02)→ 看懂它(03)→ 用对它(04)→ 做研究(05)→ 发论文(06)。赶时间的话,先记住下面这张图。
全称:National Health and Nutrition Examination Survey(美国国家健康与营养调查)
主管机构:美国 CDC(疾病控制与预防中心)下属国家卫生统计中心(NCHS)
官网:https://wwwn.cdc.gov/nchs/nhanes/
获取方式:免费、无需注册,官网直接下载
数据周期:1999 年起连续开展,每两年一个发布周期
01 认识它:从 1960 年代走到今天的国民健康调查
NHANES 由美国 CDC 组织,是全球历史悠久、体系成熟的国民健康调查之一。项目自 1960 年代起多轮开展,1999 年起改为连续运作:2000 年起每年走访约 15 个初级抽样单元(PSU,通常为一个县或几个相邻县;1999 年为 12 个),访问约 5000 名居民(含成人与儿童)——先完成家庭访谈,再邀请到流动体检车(MEC)完成体格检查、实验室检测与问卷评估。样本为美国平民非机构人群(平民,且不居住在监狱、养老院等机构中),覆盖从婴幼儿到老年人的全年龄段,共同拼出这一人群健康与营养状况的全国画像。
调查结束后,脱敏数据按周期统一发布在官网,任何研究者都可以免费下载。数据公开、变量齐全、样本有全国代表性——这三点决定了它是"临床公共数据库挖掘"的首选入口。
02 拿到它:官网三件套
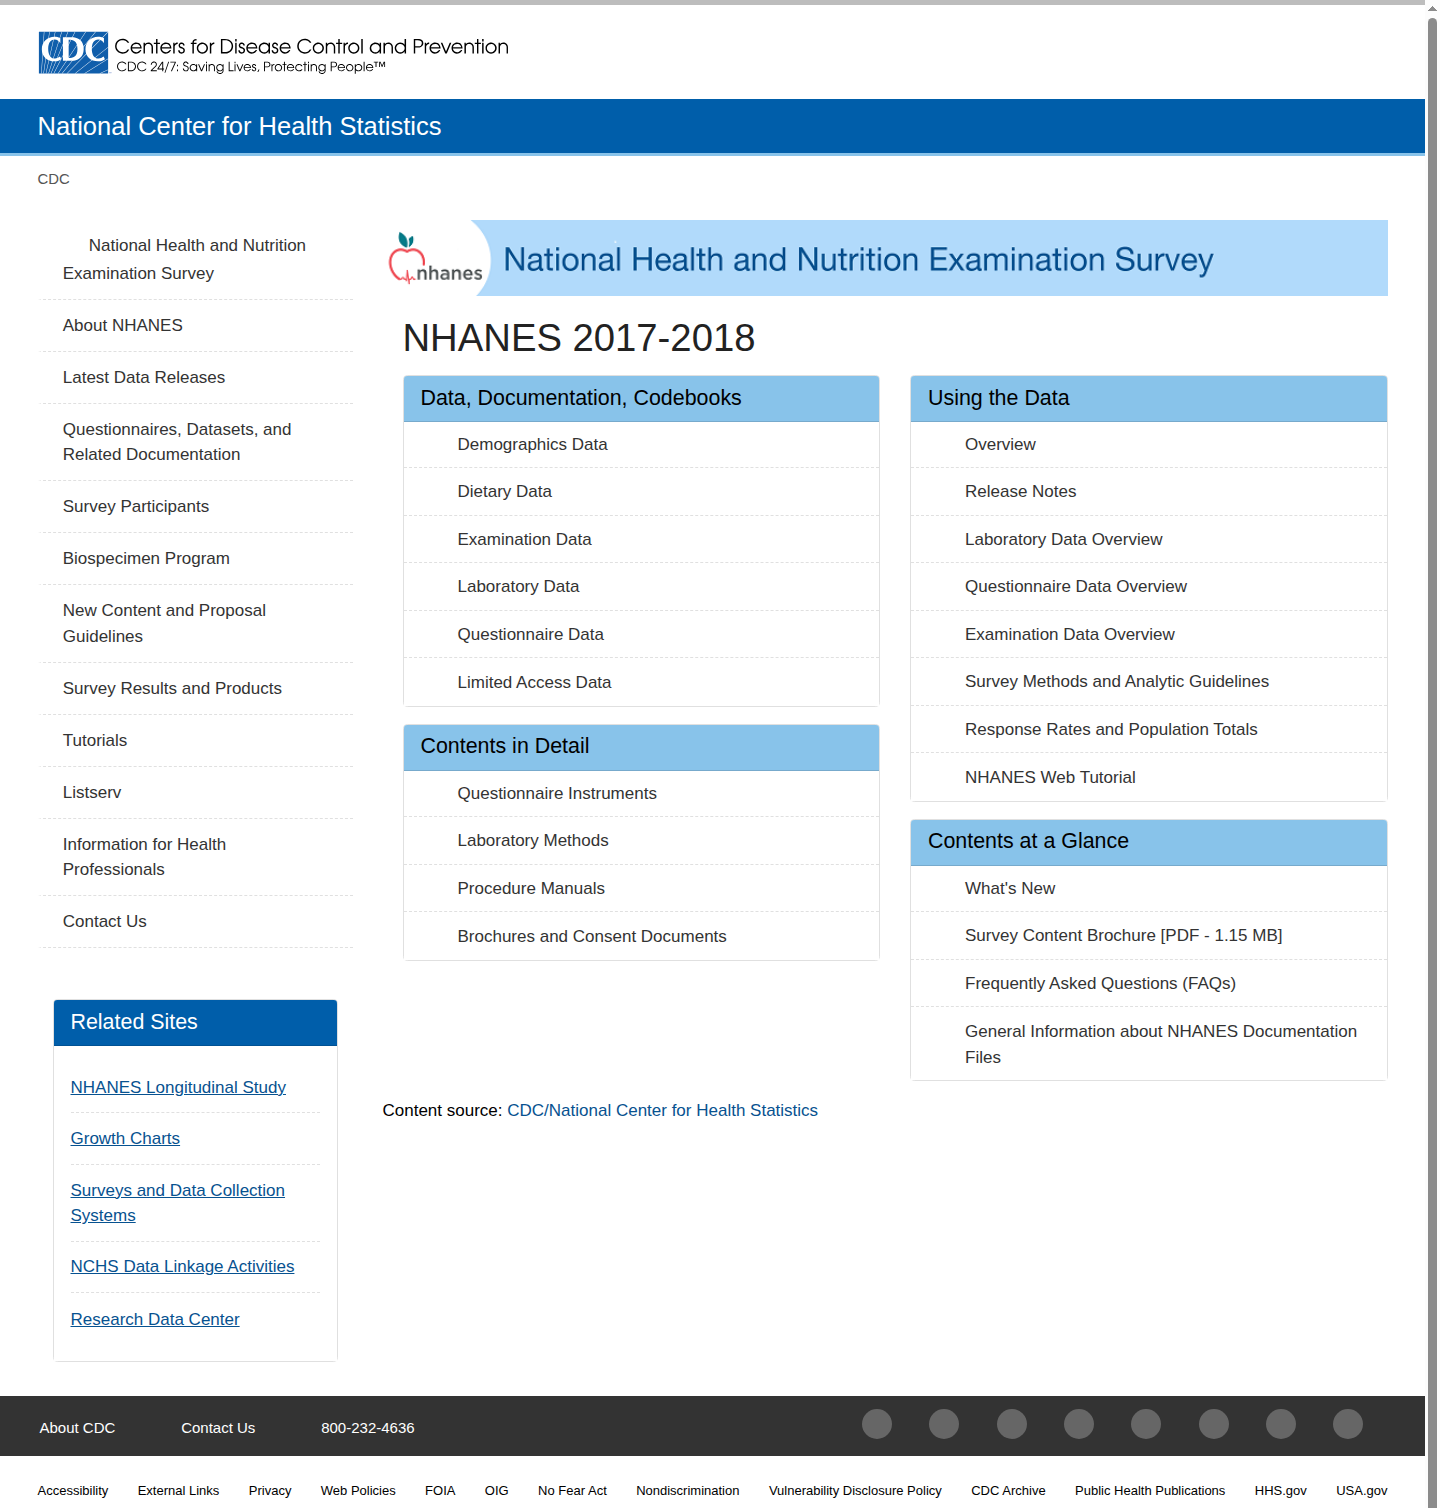
官网的数据主页按发布周期组织:目前已发布 1999-2000 至 2021-2023 的数据文件——其中受疫情影响,2019-2020 未单独发布,并入 2017-2020 “疫情前”(Pre-Pandemic)数据;2021-2023 周期即官网菜单标注的 NHANES 08/2021-08/2023,是当前最新的可用数据。更晚的 2025-2026 周期,官网目前只放出问卷工具与操作文档,数据文件页面明确标注 “not yet released”(尚未发布)。每个已发布周期的页面,都按人口统计、膳食、体检、实验室、问卷五大类分列文件清单,每份数据文件都配套说明文档与 codebook(变量说明书)。
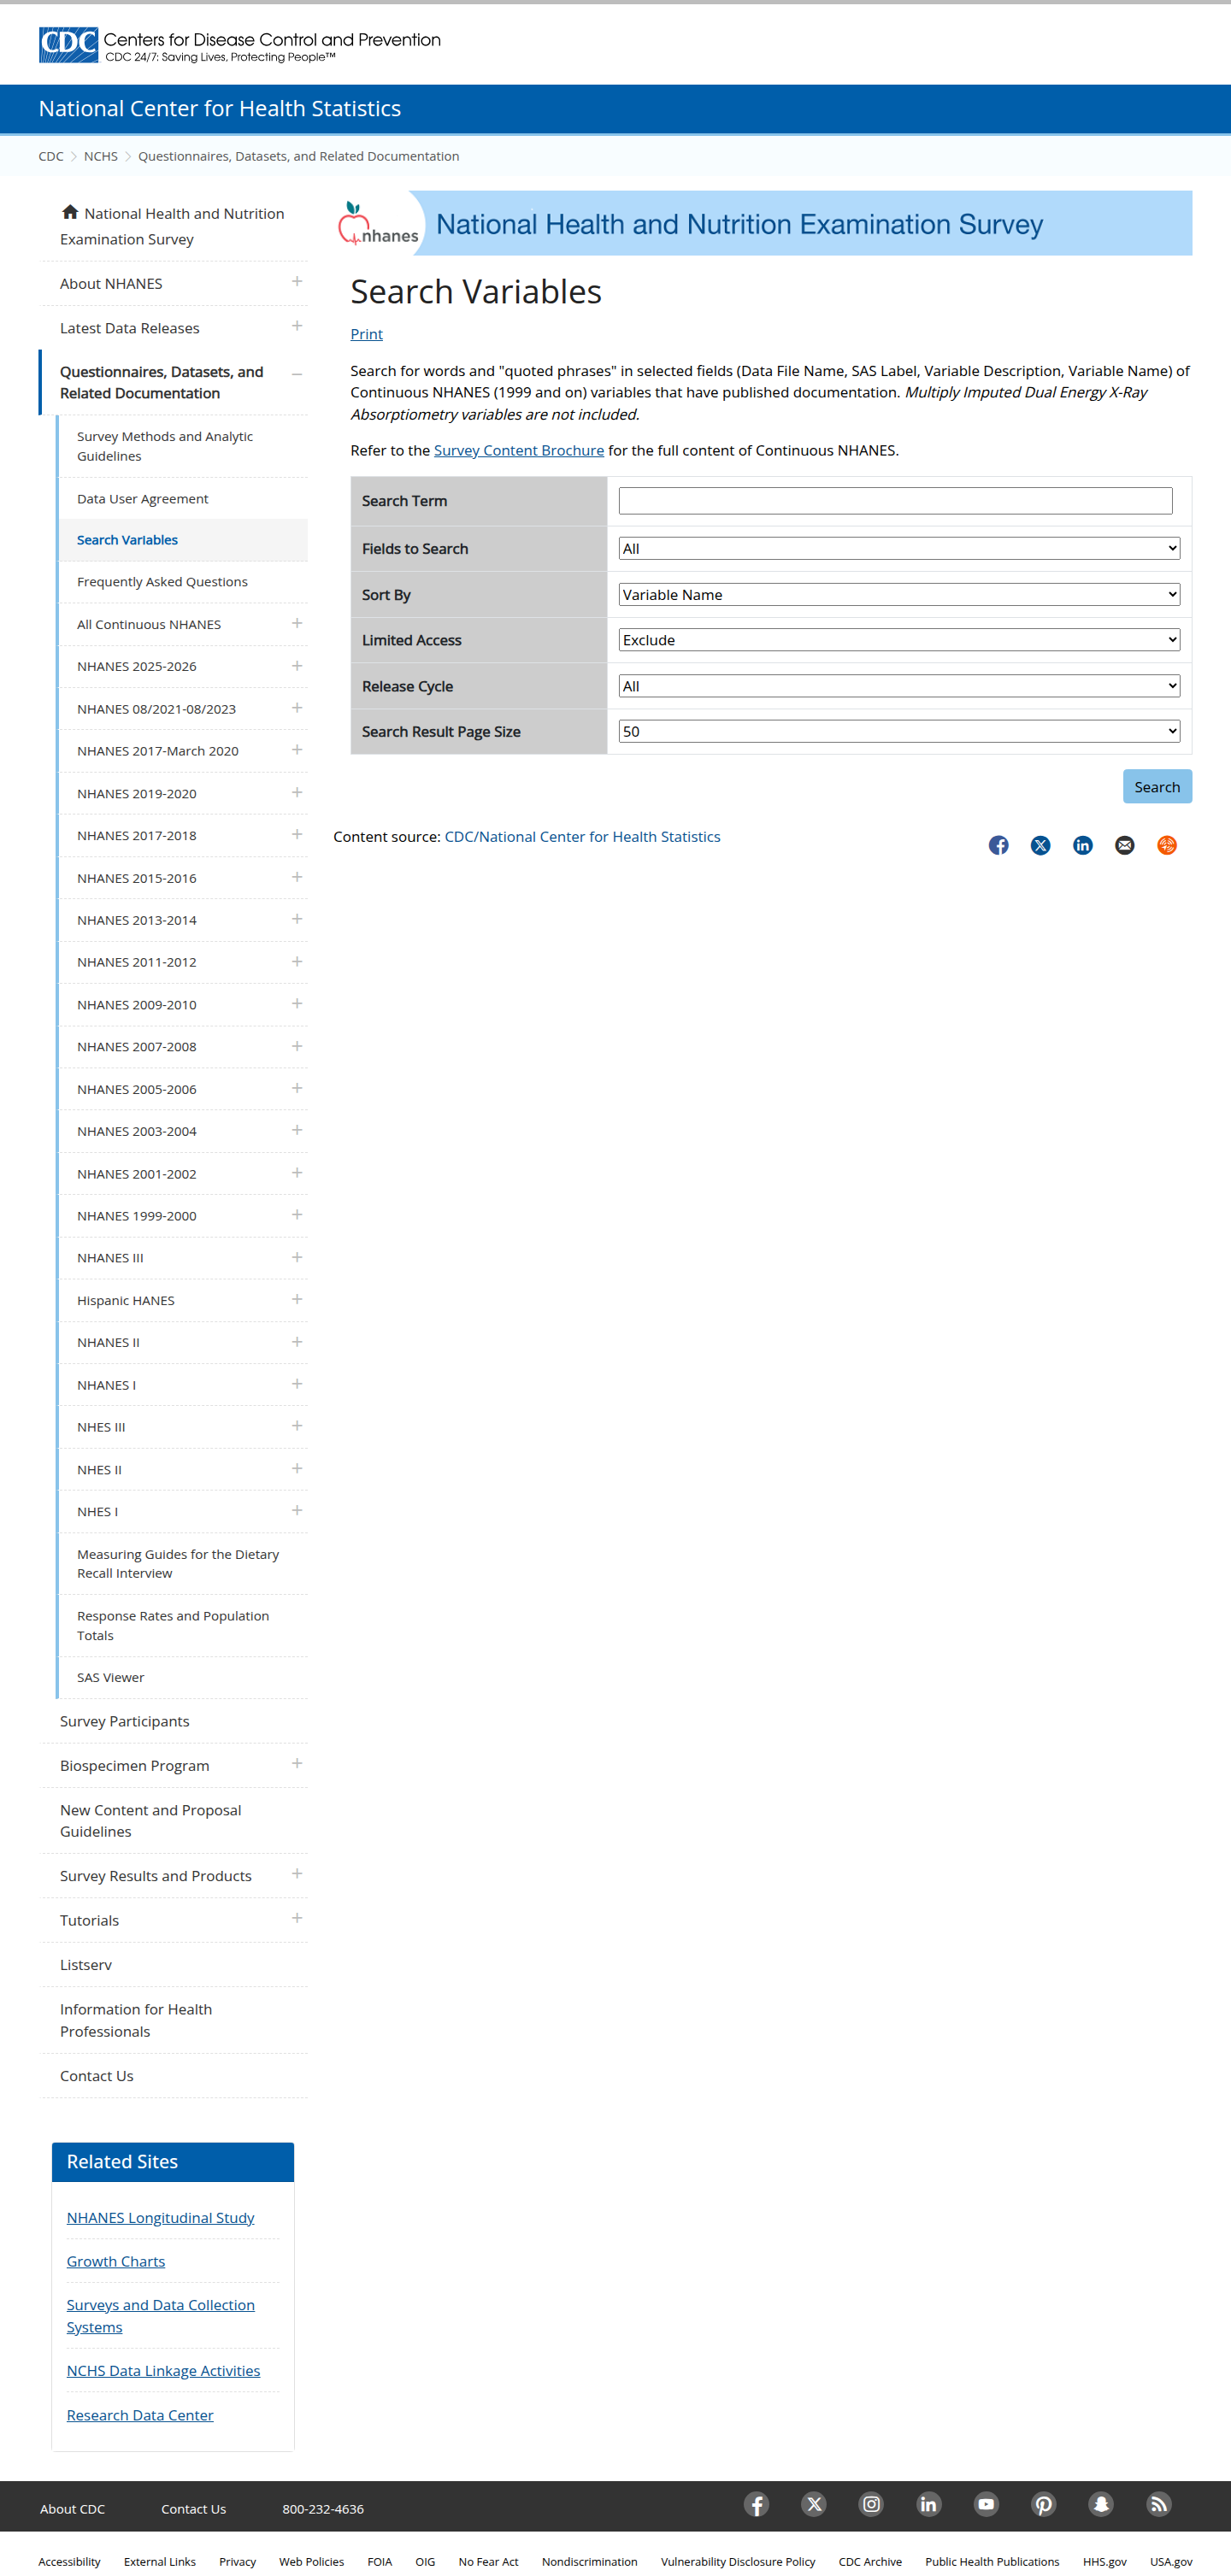
下载之外,官网还有两个高频入口。一个是 Search Variables(变量检索):按关键词跨周期查变量。比如想研究"糖尿病",一次就能看到所有周期里的相关变量与可用年份——这是选题阶段的刚需工具,先确认变量在哪些周期可用,再定研究设计。
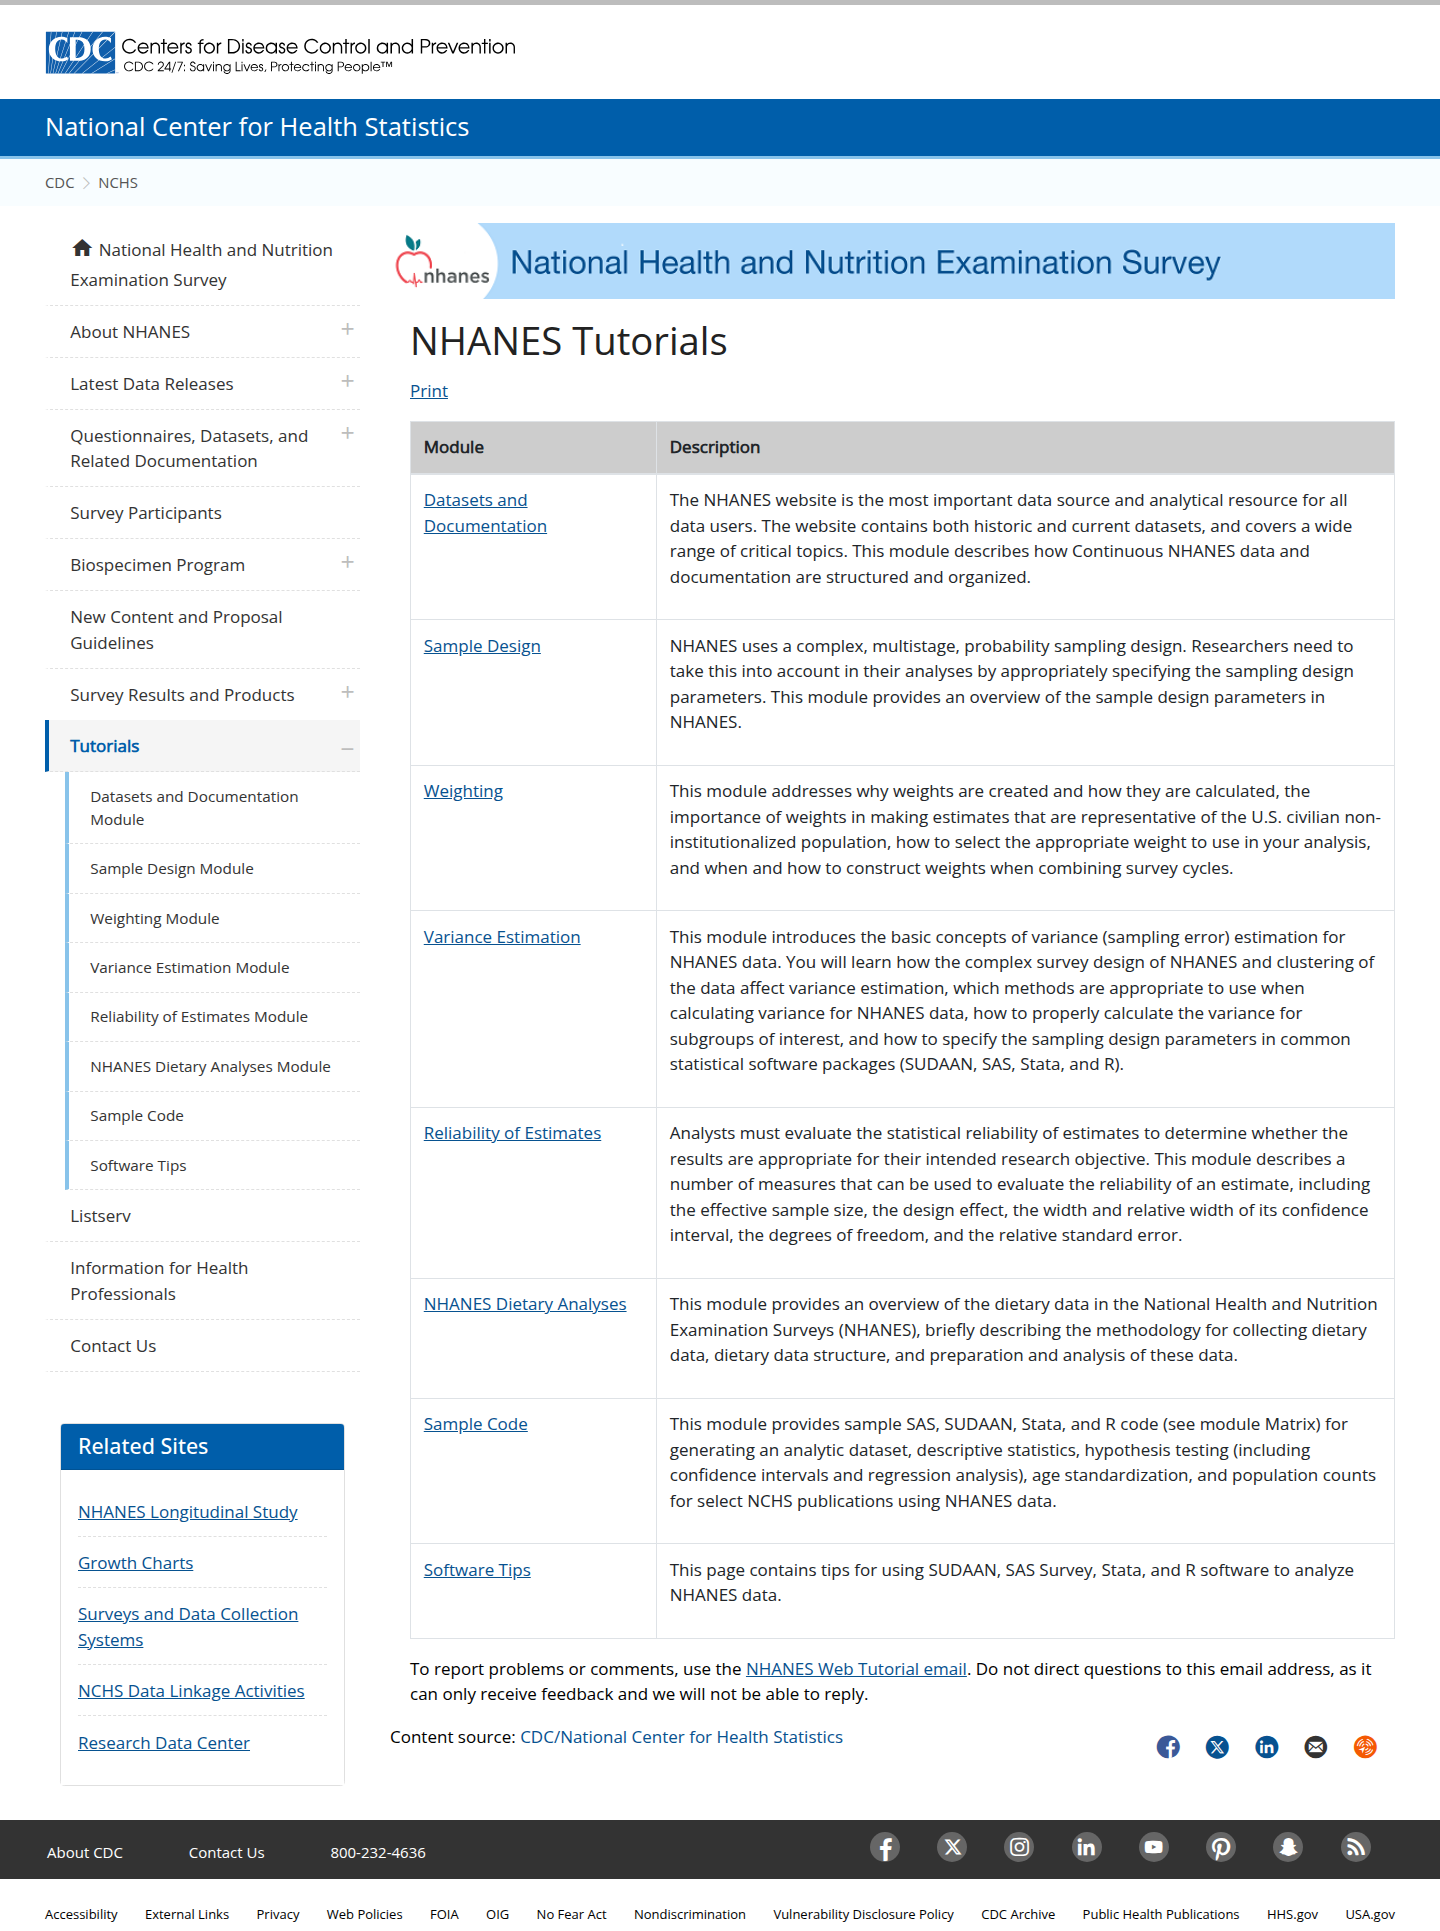
另一个是 NHANES Tutorials(官方教程):抽样设计、加权、方差估计这些审稿人最常追问的方法学要点,官方都有逐步示范。动数据之前先过一遍,能避开大部分新手错误。
03 看懂它:五大模块与变量说明书
NHANES 的数据按主题拆成一个个独立文件,一张表一个主题,常用的五大类是:
- Demographics(人口统计):性别、年龄、种族、教育、收入、婚姻状况与家庭结构等基础信息(如 DEMO_J)
- Questionnaire(问卷):吸烟饮酒、膳食行为、睡眠、抑郁量表(DPQ,官方抑郁筛查问卷)、身体活动(PAQ,身体活动问卷)等自报信息
- Examination(体检):血压、身高体重(BMI,身体质量指数)、腰围、口腔检查等体格测量,握力、骨密度(DXA,双能 X 线骨密度检测)等项目仅在部分周期提供
- Laboratory(实验室):血糖、糖化血红蛋白、血脂、尿酸、肝肾功能、炎症因子等生物标志物
- Dietary(膳食):24 小时膳食回顾、膳食补充剂摄入等营养数据
各文件通过受访者序列号(SEQN)关联:把人口统计文件当主表,按 SEQN 左联(以主表为基准逐行匹配,主表里的受访者一条不丢)体检、实验室或问卷文件,就能拼出一份完整的个人数据——这是每次 NHANES 分析的技术起点。
动手合并之前,先读懂 codebook。以 2017-2018 周期的 DEMO_J 人口统计文件为例:每个变量都有变量名、SAS 标签(数据文件自带的变量说明)、英文原题、适用人群和取值频数表,官方定义一目了然——不用下载数据,就能先判断这个变量适不适合你的研究。文件名末尾的字母随周期递增:2017-2018 是 DEMO_J,最新的 2021-2023 周期则是 DEMO_L;用哪个文件,以对应周期页面的清单为准。
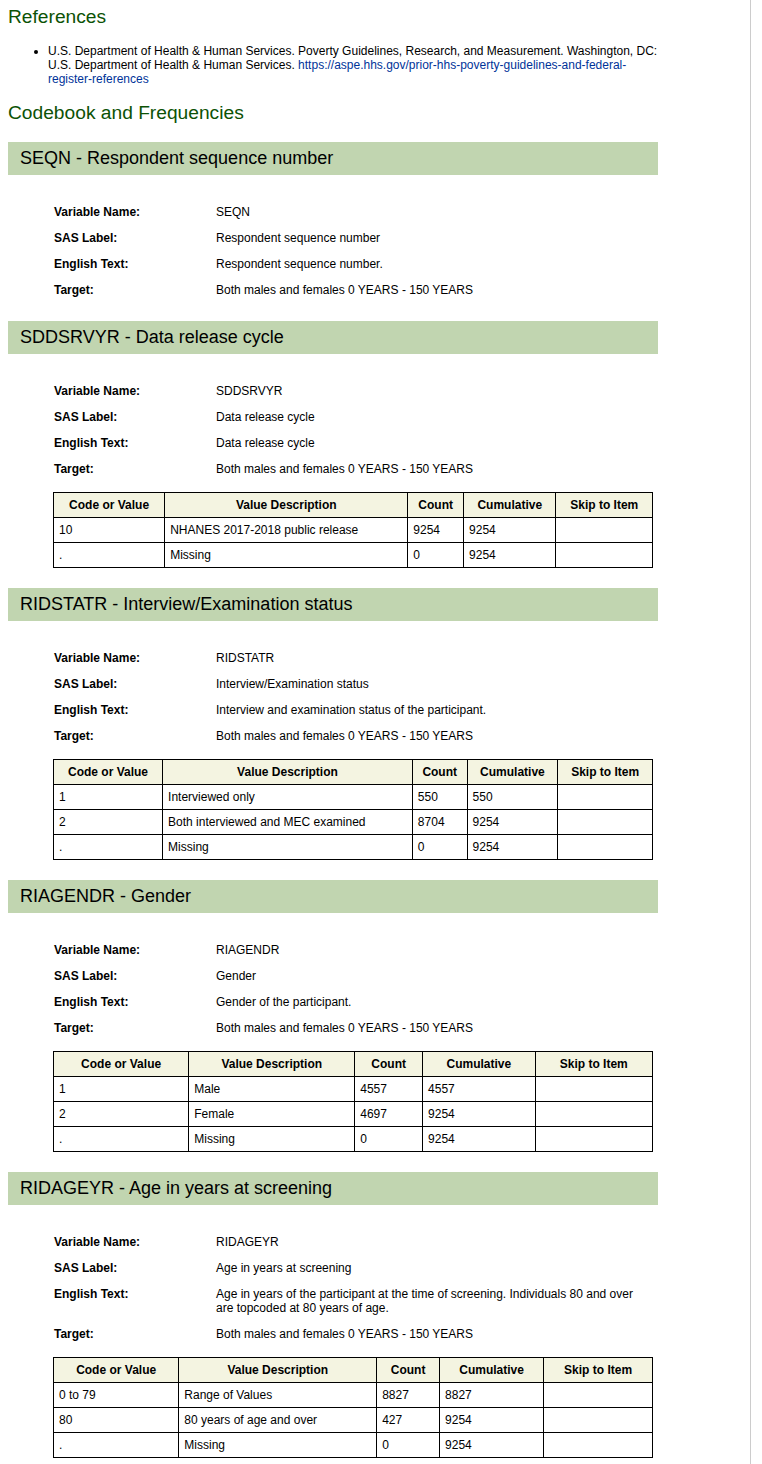
特别要注意缺失值编码:不少分类变量用 7 = Refused(拒答)、9 = Don't know(不知道)表示缺失,但也有的变量用 77、7777 等编码,个别变量的 7 另有含义(如 DEMO_L 中种族变量的 7 表示 Other Race)。这些编码直接当数值算会污染结果,分析前必须逐个对照 codebook 清洗。
04 用对它:复杂抽样必须加权
NHANES 采用多阶段分层抽样(官方设计分四阶段:初级抽样单元→县内区段→住户→个人):老年人、拉美裔、亚裔等亚组被超比例抽中,使亚组有足够的样本量(各周期超抽样对象略有调整,亚裔自 2011-2012 周期起纳入超抽样)。代价是——如果把它当普通数据直接跑回归,方差估计就是错的,结论无法外推到美国全人群。这也是这类论文被审稿人质疑的头号原因。
规范做法是使用数据自带的权重(WTINT2YR 访谈权重 / WTMEC2YR 体检权重)、分层变量(SDMVSTRA)与初级抽样单元 PSU(SDMVPSU)做设计加权分析:R 用 survey 包,Stata 用 svy 系列;跨周期合并时,权重按"原权重 ÷ 周期数"调整(2001-2002 及以后周期适用;合并 1999-2002 时官方已直接提供 4 年权重)。在论文方法部分写清所用软件与加权选项,是这类文章的基本功。
05 做研究:五类经得起审稿的设计
NHANES 是横断面数据(每次调查只反映调查时点的"快照",不做长期随访),最自然的用法是"暴露-结局关联"(暴露指研究的因素,结局指健康结果)。常见且规范的五类研究设计:
- 患病危险因素分析:膳食模式、炎症指标、环境暴露与高血压、糖尿病、抑郁、NAFLD(非酒精性脂肪性肝病)等患病风险的加权回归
- 新指标与经典指标比较:如 TyG 指数(甘油三酯-葡萄糖指数)、ABSI(身体形态指数)、BRI(身体圆度指数)等新指标与传统指标对心血管代谢风险的预测力比较
- 共病与多结局探索:一个暴露对应多个结局(如代谢指标 × 抑郁 × 睡眠),形成一组选题
- 风险预测模型:基于体检与实验室变量构建患病预测模型(Logistic 回归,用于患病与否这类二分类结局;LASSO 回归,可自动筛选变量),用 ROC 曲线(区分患者与非患者的能力)、校准曲线、DCA(决策曲线分析)评估
- 跨周期趋势分析:合并多个周期,观察某指标的十余年变化趋势
同时要守住三条能力边界:横断面设计不能做因果推断,讨论部分别越界;变量定义由官方统一固定,暴露必须按官方问卷与检测方法操作;结论基于美国人群,外推要克制。写作时主动讲清这三条限制,反而是方法学成熟的加分项。
06 发论文:数据免费,门槛在选题
NHANES 数据免费,"拿到数据"从来不构成门槛——真正的门槛是选题查新与分析质量。同一批数据,叠加不同的暴露定义、亚组与方法设计,可以做出完全不同层次的论文;而套路化的"单变量 + 三结局"正越来越难过审。
我们辅导的常规路径:选题查新与差异化设计(1-2 周)→ 数据下载清洗与变量构造(2-4 周)→ 加权统计分析与敏感性分析(3-5 周,敏感性分析指改变口径或假设,检验结论是否稳健)→ STROBE(观察性研究报告规范)写作与投稿(5-8 周)。全程导师一对一示范与把关,分析与写作由你本人完成。
下一篇拆解聚焦 CHARLS(中国健康与养老追踪调查)——覆盖中国 45 岁以上中老年人、纵向追踪十余年——关注医嘉研科研资讯,九大临床公共数据库逐个讲透。