
到上一篇,论文的每一块结果你都亲手跑出来了:样本漏斗、Table 1、Table 2、Figure 2/3、Table 3。但复现到这里还没结束。最后一步是把数字变成结论,把差异写成一份诚实、可交付的报告。这一步做得好不好,决定了这份复现是"我自己跑着玩"还是"能给别人看的成果"。
这一篇做四件事:把 OR 翻译成临床语言、与论文的机制讨论对照、做完权重敏感性检验、把全部差异整理成一份复现报告,并把论文没做的事写成你未来的加分项。
一、把 OR 翻译成临床语言
复现出来的 OR 是 0.992(每 1 ng/mL)。这个数字对临床同事几乎无法传达——换算成人群能感知的尺度:
| 表达 | 计算 | 数字 |
|---|---|---|
| 每 1 ng/mL | OR | 0.992(odds 降低 0.8%) |
| 每 10 ng/mL | 0.992¹⁰ | 0.921(降低 7.9%) |
| 最高四分位 vs 最低四分位(M1) | Q4 的 OR | 0.508(odds 降低 49%) |
| 论文报告的四分位对比 | 论文 Q4 | 0.479(论文原文写"降低 52.1%") |
论文摘要里那句"最高四分位比最低四分位低 52.1%",才是这个研究最有传播力的数字——而它来自 Table 2 的四分位部分。这也解释了为什么论文在连续变量之外一定要做四分位:连续变量的 OR 用于检验趋势,四分位对比用于传达效应大小。
但有三条边界必须同时说清,否则容易过度解读:
- OR ≠ RR。OR(比值比)只有在结局罕见(<10%)时才近似等于 RR(风险比);本案例抑郁患病率约 12%,OR 会略微放大效应,严谨表述是"odds 降低 49%",而不是"风险降低 49%";
- 横断面 ≠ 因果。数据无法确定"维生素 D 低"与"抑郁"谁先发生。论文在结论里写得很规范:"our cross-sectional design precludes causal inference"——这句话不是客套,是这项研究设计的硬边界。
- 统计学显著 ≠ 临床意义。每 1 ng/mL 降低 0.8% 在临床上微不足道;有意义的是"缺乏/充足"之间的差距(Q1 的 11.9 ng/mL vs Q4 的 41.2 ng/mL 是量级差别)。
二、与论文讨论对照:机制解释能证明什么
论文 Discussion 用了很大篇幅解释"为什么 D3 保护、D2 反而有害",论证链条是:
- 来源不同:D3 主要来自日照与动物性食物,D2 主要来自植物与强化食品/补充剂;
- 代谢优势:D3 在提升与维持血清 25(OH)D 上比 D2 更有效;有研究提示 D2 补充甚至可能降低 25(OH)D3 水平;
- 受体层面:体外研究显示 1,25(OH)₂D3 激活维生素 D 受体(VDR)的效力强于 D2 的对应代谢物;
- 脑内机制:VDR 广泛分布于前额叶、海马、杏仁核等情绪相关脑区;维生素 D 参与血清素合成(调节 TPH2)、神经炎症调控与 BDNF 表达。
复现者的正确态度:这些机制解释不是我们的数据能证明的——我们手里的 3,863 人横断面数据只能支持"关联存在"这一个结论;机制部分依赖的是别人的实验与文献。写论文时,机制讨论要明确标注为"可能的解释"并引用来源,不能写成本研究的发现。
一个我们实测发现、论文没提的细节
翻开 D2 的绝对水平:分析样本里 维生素 D2 的加权均值只有 1.53 ng/mL(无抑郁组),而 D3 是 30.96 ng/mL——两者差 20 倍。也就是说:
- D3 是人群层面的主要形式,"每 1 ng/mL D3"是贴近现实的刻度;
- D2 在大多数人身上接近 0,"每 1 ng/mL D2 升高"对应的是少数服用补充剂或特殊膳食的人群——这个 OR=1.02 只在"从 0 到 1"这个小范围内有解释力,说成"D2 有害"容易被误读成"D2 摄入越多越糟"(而数据里根本没有高 D2 人群)。
这条是复现带来的额外发现:论文报告了 D2 的 OR 与 P 值,但没有提醒一句"D2 的人群分布极低、外推要谨慎"。你自己写论文时,一句"D2 水平在人群中普遍接近检测下限,该关联应谨慎解释"就能显著提升讨论的严谨性。
三、权重敏感性分析:换个权重,结论会不会变?
论文没写明用哪个权重,我们用三种口径各跑一遍全套模型(这是"未披露口径"最标准的应对方式):
| 口径 | Model 1 | Model 2 | Model 3 |
|---|---|---|---|
| WTPH2YR(采血权重,首选) | 0.982 (0.973, 0.991) | 0.984 (0.974, 0.995) | 0.992 (0.982, 1.002) |
| WTMEC2YR(MEC 体检权重,对照) | 0.982 (0.973, 0.991) | 0.985 (0.974, 0.996) | 0.992 (0.982, 1.002) |
| 不加权(错误示范) | — | — | 0.991 (0.983, 0.998) |
前两行说明:两种权重的结果几乎完全一致——论文没写明用哪个,对结论没有实质影响。这是我们可以给出的确定答复。
但第三行才是这一节的重点。 不加权时,点估计 0.991 看起来"差不多"(和 0.992 只差 0.001),但置信区间却明显变窄了(0.983–0.998,不含 1,即"显著")。为什么?
因为 NHANES 的设计效应:同一片区、同一层内的人不是相互独立的,实际信息量比"3,863 个独立个体"要少。忽略抽样设计会低估标准误。我们实测:设计校正后的标准误比未加权大约 33%,方差约 1.8 倍(deff ≈ 1.8),于是置信区间变宽、P 值变大——口径一换,"显著"就变成了"不显著"。
这就是"不加权的 NHANES 分析站不住"最硬的理由:不是说点估计一定偏(本例里几乎没偏),而是推断本身失真——你会把"证据不足"当成"证据充分",用更窄的置信区间和更小的 P 值去支持一个其实摇摆的结论。审稿人质疑的正是这个。
四、把"论文未披露口径"整理成诚实清单
复现过程中我们一共碰到四处差异,逐条列清(这张表是复现报告的核心):
| # | 差异点 | 论文状态 | 我们的处理 | 影响 |
|---|---|---|---|---|
| 1 | 四分位切点算法 | 未披露(也没给切点值) | 未加权分位数与加权分位数两种口径各跑一遍 | Q2–Q4 的 OR 无法逐位命中(0.832 vs 0.904);方向、单调性一致 |
| 2 | 交互检验方法 | 未披露(只给了 P 值) | regTermTest(Rao-Scott F,传 df = degf)与手算 Wald 双口径 | 结论一致(全部不显著);P 值数值不同(最小 0.0919 vs 0.2334) |
| 3 | 统计软件 | 只写 Empower,非 R | 用 R 复现全部流程 | 点估计完全对齐,推断量(CI/P)略有差异 |
| 4 | 方差与自由度处理 | 未披露 | 实测设计自由度 = 15(15 层 × 2 PSU) | 全调整模型(17 参数)超出限制:t 检验 P 值无解,改用正态近似并注明 |
处理这类差异的三条原则(可以直接搬到任何复现工作里):
- 点估计必须对齐——如果均值、比例、OR 对不上,说明数据或代码有问题,必须先解决,不能用"口径差异"搪塞;
- 推断量允许差异,但要定位原因——CI 与 P 值受方差估计方法影响,差异要指出"差在哪一步"(本例是标准误与自由度),而不是笼统说"软件不同";
- 全部写进报告——包括对自己不利的部分(例如 M3 的显著性我们和论文不一致)。复现的价值不在于"证明我全对",而在于把可复现与不可复现的部分划清界限。
五、论文没做的事:写进你的研究局限
复现最大的附加价值,是让你看见论文没做的事。下面这些都有实测支撑,直接可以变成你未来论文的"局限性"段落:
| 局限 | 我们的实测证据 | 怎么写 |
|---|---|---|
| 完整病例分析偏倚 | 被排除的 4,290 名成人收入中位数 2.17(纳入者 3.22)、非西裔白人占 50.9%(纳入者 65.2%)——排除不是随机的 | "分析人群来自完整病例,被排除者在社会经济地位与种族构成上系统性不同,可能使关联估计产生偏倚;未做多重插补或多重缺失建模" |
| 单周期设计的信息量上限 | 设计自由度仅 15,全调整模型 17 个参数 | "单周期 NHANES 的抽样自由度有限,全调整模型参数数量接近设计自由度上限,估计稳健性受限" |
| 小样本亚组精度 | 墨西哥裔 n=228,OR 的 CI 宽 0.080(白人组 0.021) | "部分亚组样本量较小、置信区间较宽,无法排除中等程度的效应差异" |
| 未预注册的分组切点 | 四分位与亚组切点均为事后决定,论文未披露算法 | "连续变量的分组切点未预先指定,可能影响剂量反应结果的可比性" |
| 测量与设计层面(论文已写) | 横断面、PHQ-9 自评、单次血样 | "横断面设计不能推断因果;PHQ-9 为自评量表;单次血清测量未反映长期暴露" |
写作模板(把上表合成一段,按你的研究改数字即可):
本研究存在以下局限:其一,采用完整病例分析,被排除者在收入水平与种族构成上与纳入者系统性不同(收入中位数 2.17 vs 3.22),可能引入选择偏倚;其二,单周期 NHANES 的设计自由度有限(15),全调整模型参数接近该上限;其三,部分亚组样本量较小(最小 n=228),置信区间较宽,不能排除中等程度的效应差异;其四,连续变量的分组切点未预先指定;其五,横断面设计不能推断因果,PHQ-9 为自评量表,且血清维生素 D 为单次测量。
注意:把局限写清楚不会削弱你的论文——反过来,它显示你知道自己的证据边界。真正会被审稿人抓的是"只写一句'横断面不能推断因果'"却对上面五条闭口不谈。
六、论文末尾那几段声明:伦理、数据可得性、利益冲突(投稿必写)
论文正文之后有几段"小字",初学者最容易忽略。但你自己投稿时,这些是硬性要求,一段都不能少。案例论文写得很规范,逐段拆给你看:
| 声明 | 论文原文(摘译) | 为什么必须写 / 你该怎么写 |
|---|---|---|
| Ethics statement(伦理声明) | "涉及人类的研究已获美国国家健康统计中心(NCHS)伦理审查委员会批准;研究依当地法规与机构要求开展;参与者提供了书面知情同意" | NHANES 是公开的去标识化数据,但伦理责任在原始调查方。所以你要写清"原始调查已获伦理批准、参与者已签署知情同意",而不是简单写"本研究无需伦理审批"(各期刊要求不同,以目标期刊为准) |
| Data availability statement(数据可得性声明) | "本研究分析的是公开可得数据集,可在 www.cdc.gov/nchs/nhanes 获取" | 用公开数据库研究,这一句几乎是模板;务必写出具体网址(有条件的还给出周期与文件清单) |
| Conflict of interest(利益冲突) | "作者声明不存在可能被视为潜在利益冲突的商业或财务关系" | 无论有无都要声明;有资助要写清资助方与研究设计/分析/发表的关系 |
| Author contributions(作者贡献) | 逐人列出(概念化、数据整理、软件、撰写初稿、审阅编辑等) | 国际期刊通用一套分工术语(CRediT,共 14 项),照着给每位作者勾选即可 |
| Generative AI statement(生成式 AI 声明) | "作者声明未使用生成式 AI 撰写本稿件" | 越来越多期刊(尤其 Frontiers 系)已强制要求;如果你用 AI 辅助润色,必须如实声明——隐瞒属于学术不端 |
给你的三段可直接改用的模板(把 NHANES 换成你用的数据库即可):
伦理声明:本研究使用 NHANES 公开数据(2021–2023 周期)。原始调查由美国国家健康统计中心(NCHS)伦理审查委员会批准,所有参与者均签署书面知情同意;本研究使用去标识化的公开数据,无需额外伦理审批。
数据可得性声明:本研究分析的数据集公开可得,来源:美国国家健康统计中心 NHANES(https://www.cdc.gov/nchs/nhanes/),本研究所用文件与变量清单见附录。
利益冲突声明:作者声明不存在可能被视为潜在利益冲突的商业或财务关系。
报告规范:STROBE 清单与表格规范
STROBE 是观察性研究(横断面、队列、病例对照)的国际报告规范,一张 22 条的清单,告诉你"一篇规范的观察性研究必须报告什么"。它的用法不是背诵,是当检查表用:
- 投稿前:拿 STROBE 逐条对照自己的稿子。纳入排除流程图有没有?缺失数据怎么处理的写了没?样本量依据在哪?偏倚讨论过吗?
- 读文献时:用同一份清单反查论文的完整性。这正是复现时做的事:论文的 Figure 1(流程图)✅ 写了、加权方法 ✅ 写了、权重具体用哪个 ❌ 没写、缺失数据的处理方式 ❌ 没写、完整病例分析的偏倚 ❌ 没讨论。用规范去查论文,比凭感觉说"这篇写得好不好"可靠得多。
表格规范(投稿时审稿人很在意):
| 规范 | 要求 |
|---|---|
| 三线表 | 学术论文的表格不画竖线、不加底色,只留顶线、表头线、底线三条横线。我们复现报告里的对照表是网页表格样式,投稿前要改成三线表 |
| 单位与量纲 | 每个变量标单位(ng/mL、岁、%),OR 明确"per 1 unit"的口径(第 08 篇第四节) |
| 有效数字 | 全文统一(OR 保留 2–3 位、P 值保留 2–4 位,P<0.001 就直接写 <0.001) |
| 表格自解释 | 表注写清 N、权重口径、模型调整了什么。不看正文也能读懂这张表 |
论文自己就是范例:Table 1 的表注写了"Means (95% CI) 表示连续变量,proportions (95% CI) 表示分类变量";Table 2 的表注写清了 Model 1/2/3 各调整了什么。这两句表注,就是判断一张表规不规范最快的标准。
七、复现报告怎么写
复现的成果不该只是一堆代码和数字,而是一份能交付的报告。我们用的结构(也是本系列配套《复现核对报告》的结构):
一、复现目标与技术路线(论文出处、数据周期、样本量、软件与版本)
二、数据与环境(下载的 8 个文件、校验结果、随机种子/版本号)
三、结果逐表对照(Figure 1 / Table 1 / Table 2 / Figure 2、3 / Table 3,逐格给论文值 vs 我们的值)
四、差异清单与归因(本篇第四节那张表;每条标注"未披露口径"还是"待排查")
五、附加验证(权重敏感性、完整病例偏倚分析等论文未做的检查)
六、结论与判定(复现成功/部分成功/失败,判定标准写清楚)
七、可复现性说明(脚本、运行日志、环境记录的位置)判定标准要事先写死,避免"自己给自己打分"。我们用的三条:
- 样本构建必须逐位一致(人数、均龄、事件数)——验证"是同一批人";
- 点估计偏差 ≤1%(均值/比例的绝对差,OR 的绝对差 ≤0.01);
- 方向、单调性与结论一致;推断量(CI/P)允许口径差异,但必须归因清楚。
三条全过 = 复现成功。按这个标准,本次判定是:复现成功(差异全部落在"论文未披露口径"这一类)。
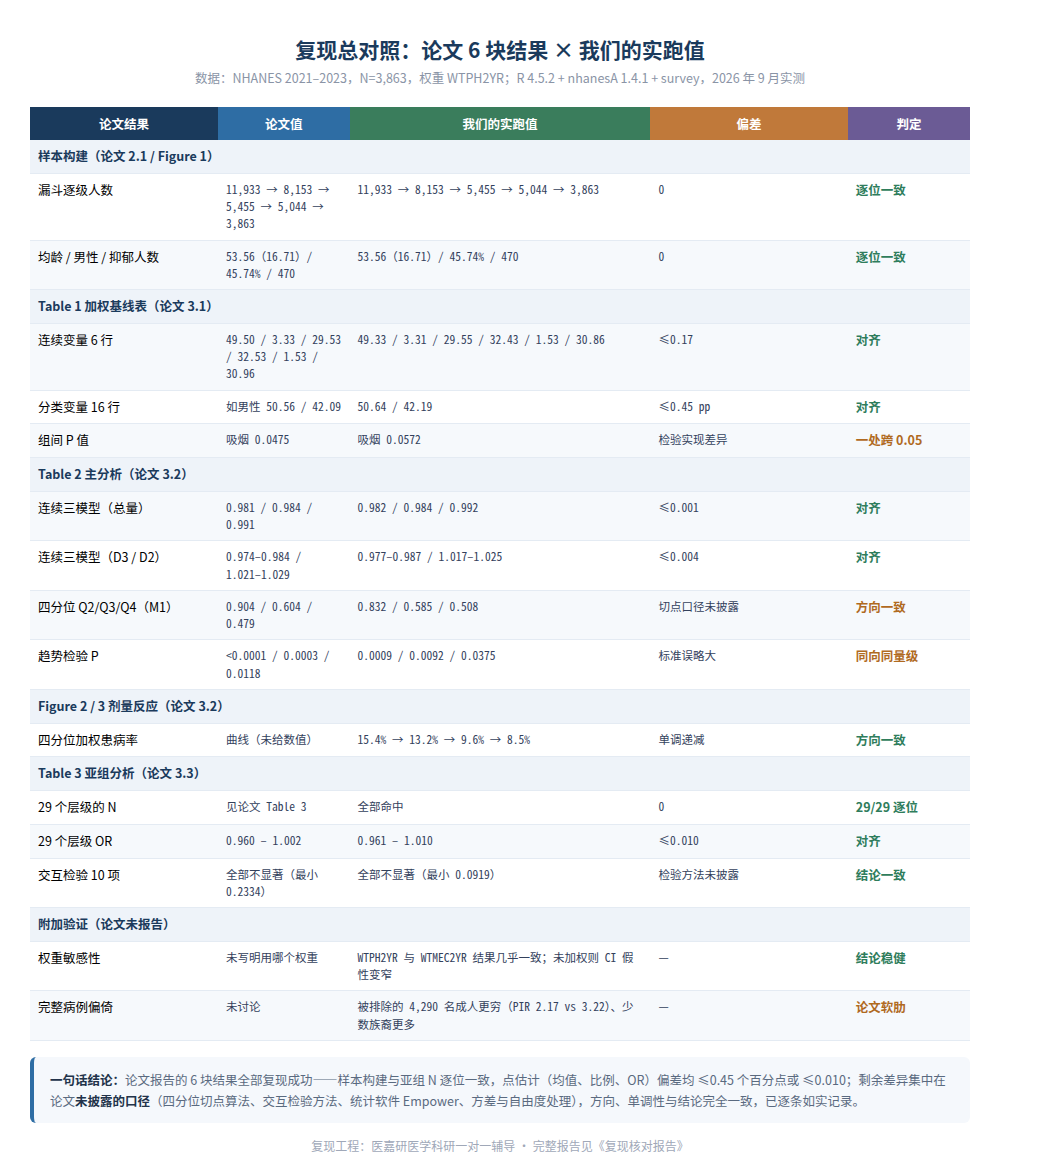
图1:全系列一页总账:论文的 6 块结果、我们的实跑值、偏差与判定。
八、全系列收官:你手里现在有什么
走完这 9 篇,你已经完成了一次完整的 NHANES 论文复现:
| 里程碑 | 内容 | 对应篇目 |
|---|---|---|
| M0 | 案例论文确定、复现路线排定、全程终点公告 | 第 01 篇 |
| M1 | 变量清单(每个变量在真实文件与 Doc 中核验) | 第 02 篇 |
| M2 | 环境就绪,八个数据文件下载并通过校验 | 第 04 篇 |
| M3 | 合并清洗到论文口径,样本漏斗 11,933 → 3,863 逐级吻合(Figure 1) | 第 06 篇 |
| M4 | 权重选好、Table 1 加权基线表复现 | 第 07 篇 |
| M5 | Table 2 三模型 + 四分位 + 剂量反应(Figure 2/3) | 第 08 篇 |
| M6 | Table 3 亚组分析 29 个层级 + 交互检验 | 第 09 篇 |
| M7 | 结果解读、权重敏感性、复现报告(本篇) | 第 10 篇 |
你带走的不只是"这篇论文的数字",而是三样可迁移的能力:
- 流程能力:从选题可行性 → 数据获取 → 合并清洗 → 加权描述 → 加权回归 → 亚组分析 → 报告,每一步都有判据、有代码、有验收;
- 判断能力:知道该用哪个权重、知道设计自由度会限制模型复杂度、知道 CI 宽到什么程度就不能下结论、知道"未披露口径"该怎么如实处理;
- 批判能力:能看出论文没做的事(完整病例偏倚、小样本亚组精度、D2 分布极低),而这些恰好是你自己做研究时的加分项。
下一步往哪走(按实用度排序):
- 多周期合并:把 2017–2018 与 2021–2023 叠起来(第 06 篇的 append + 权重换算),样本量与设计自由度同步提高——这是解决"全调整模型自由度不够"的正规解法,也能让你的选题覆盖面更大;
- 换自己的选题:拿第 02–03 篇的方法挑一个自己的问题,走一遍同样流程;变量清单、清洗口径、权重选择的方法全部可以复用;
- 加权生存分析:用 NDI 死亡率链接文件(第 04 篇讲过入口)做"基线暴露与长期死亡风险"的随访研究,这是 NHANES 里最像"队列研究"的一类设计;
- 缺失数据处理:尝试多重插补,检验第 06 篇那个"完整病例偏倚"会把结论带到哪里去。
最后一句:这个系列从头到尾只做了一件事——把"看起来会用"变成"确实跑通过、对得上数"。NHANES 的门槛从来不在"拿到数据",而在权重、方差、口径这些没人愿意细讲的地方;而正是这些地方,决定了你的结果能不能站住。
本篇常见坑
- 把 OR 当 RR 讲:结局不罕见时 OR 会放大效应,表述要说"odds"。
- 把机制解释写成本研究结论:Discussion 的机制部分依赖文献与实验,必须标注为"可能解释"并引用来源。
- 只报点估计、不看精度:同样的 OR,CI 宽 0.02 和宽 0.08 意味完全不同的证据强度。
- 不做权重敏感性就断言"结论稳健":论文未写明权重时,两种权重都跑一遍是基本动作(本例两种权重结果一致,但未加权会让 CI 假性变窄)。
- 差异不写进报告:复现报告的价值一半在"对上了",另一半在"哪里没对上、为什么"。
- 局限只写一句"横断面不能推断因果":完整病例偏倚、设计自由度、亚组精度、切点未预注册,都是应当写清的边界。
- 以为复现成功就等于能发表:复现验证的是流程与数字,创新性与临床意义才是发表的门槛。
- 漏写伦理/数据可得性/AI 使用声明:多数期刊已是硬性要求,投稿前对照目标期刊的作者指南逐条核对。
- 表格不做三线表、表注不写口径:审稿人无法脱离正文读懂表,是常见退修原因。
参考来源
- 案例论文:Front Nutr. 2025;12:1545443. PMID: 40497025(Table 1–3、Figure 1–3 原值取自 PMC 全文 XML)
- CDC/NCHS. NHANES Analytic Guidelines(权重、子人群分析、方差估计). https://wwwn.cdc.gov/nchs/nhanes/analyticguidelines.aspx
- Lumley T. survey: analysis of complex survey samples(设计效应与方差估计). https://cran.r-project.org/web/packages/survey/
- 本系列配套资产:《案例论文复现总脚本》(第 0–10 步完整代码)、《复现核对报告》(含 v1/v2 两轮核对与差异清单)、《案例论文复现规格书》(里程碑验收标准)
- STROBE Statement — 观察性研究报告规范(22 条清单). https://www.strobe-statement.org/
- 案例论文的伦理声明、数据可得性声明、利益冲突声明原文(摘译自上表):Front Nutr. 2025;12:1545443, PMC12150404
- 本篇权重敏感性、完整病例偏倚、设计自由度均为 2026 年 9 月 R 4.5.2 + survey 4.5 实跑结果