
上一节我们复现了 Table 1(加权基线表),那属于"描述"。这一篇进入主分析:把"维生素 D 与抑郁到底有没有关联、关联有多大"算出来。
论文的 Table 2 是全篇的核心结果,它用三个递进的加权 logistic 回归模型 + 四分位剂量反应回答这个问题;Figure 2/3 则把这个关系画成曲线。这一篇的产出就是:Table 2 全部单元格 + Figure 2/3 的等价物。
一、svyglm:系数怎么变成 OR
普通 glm() 假设观测独立同分布;NHANES 是分层整群抽样,必须用 svyglm() 把设计对象喂进去,方差、置信区间、P 值才会按抽样设计校正:
library(survey)
# des 是第 07 篇建好的设计对象(svydesign,权重 WTPH2YR)
fit <- svyglm(depression ~ vitD_ngml,          # 结局 ~ 暴露
              design = des,
              family = quasibinomial())         # logistic 回归(quasi 版避免离散度警告)
coef(fit)["vitD_ngml"]                          # 这是 log-OR(对数比值比),不是 OR
exp(coef(fit)["vitD_ngml"])                     # exp() 之后才是 OR
三条换算规则,是读懂任何 logistic 回归结果的基础:
- 系数是 log-OR:
β = -0.0083意味着"每升高 1 个单位,抑郁的对数 odds 下降 0.0083"; - OR = exp(β):
exp(-0.0083) = 0.9917; - 95%CI = exp(β ± 1.96 × SE):标准误取自设计校正后的方差矩阵(
vcov(fit)),不能用普通 glm 的标准误。
把这三步封装成一个函数,三个模型就能复用(这也是总脚本的做法):
fit_model <- function(formula_rhs) {
  fit <- svyglm(as.formula(paste("depression ~", formula_rhs)),
                design = des, family = quasibinomial())
  beta <- unname(coef(fit)["vitD_ngml"])                     # 按变量名取,避免因子协变量错位
  se   <- unname(sqrt(vcov(fit)["vitD_ngml", "vitD_ngml"]))
  c(OR = exp(beta), lower = exp(beta - 1.96*se), upper = exp(beta + 1.96*se),
    P = summary(fit)$coef["vitD_ngml", 4])
}
二、三个递进模型:为什么要"一级一级加变量"
论文的 Model 1/2/3 是流行病学论文的标准写法,含义是"逐级排除混杂":
| 模型 | 纳入的变量 | 回答的问题 |
|---|---|---|
| Model 1 | 只放暴露(未调整) | 完全不考虑混杂时的粗关联 |
| Model 2 | + 年龄、性别、种族 | 人口学混杂排除后还剩多少 |
| Model 3 | + 吸烟、饮酒、教育、收入、BMI、糖尿病、高血压 | 主要混杂全部排除后的"独立关联" |
为什么要递进而不是只报全调整模型? 因为三者的变化本身就是信息:如果 Model 1 显著、Model 3 变成 1.0 附近,说明关联大部分是混杂造成的;如果三条都稳定,说明关联较稳健。案例论文的走向是 0.981 → 0.984 → 0.991:保护性关联逐级减弱,但仍然存在,这是它结论的骨架。
三、复现 Table 2(上):连续变量三模型
论文把维生素 D 当连续变量(每升高 1 ng/mL)分别分析了总量、D2、D3 三行,每行三个模型。实跑代码就是上一节的 fit_model 复用:
m1 <- fit_model("vitD_ngml")
m2 <- fit_model("vitD_ngml + RIDAGEYR + male + race")
m3 <- fit_model("vitD_ngml + RIDAGEYR + male + race + smoking + drinking + education + INDFMPIR + BMXBMI + diabetes + hypertension")逐行对照(左边是我们的实跑值,方括号里是论文原值):
| 暴露 | Model 1 | Model 2 | Model 3 |
|---|---|---|---|
| 总维生素 D | 0.982 (0.973, 0.991) [0.981 (0.974, 0.988)] | 0.984 (0.974, 0.995) [0.984 (0.977, 0.992)] | 0.992 (0.982, 1.001) [0.991 (0.983, 0.999)] |
| 维生素 D2 | 1.023 (1.010, 1.036) [1.026 (1.014, 1.039)] | 1.025 (1.010, 1.041) [1.029 (1.016, 1.042)] | 1.017 (1.003, 1.030) [1.021 (1.008, 1.035)] |
| 维生素 D3 | 0.977 (0.965, 0.989) [0.974 (0.966, 0.981)] | 0.979 (0.964, 0.993) [0.976 (0.968, 0.984)] | 0.987 (0.975, 1.000) [0.984 (0.976, 0.992)] |
9 个 OR 全部对上,最大偏差 0.004(D2 Model 1:1.023 vs 1.026)。方向完全一致:D3 保护、D2 风险、总量保护但随调整减弱。 这正是论文摘要的核心结论。
不过置信区间和 P 值有两处必须如实交代的差异,下一节详细讲。它们不是算错了,而是方法学口径问题。
四、OR 的量纲:0.991 到底意味着什么
这是读结果时极容易被忽略、却直接影响你解读(和写作)的一步。
论文写"每单位增加维生素 D 与抑郁风险降低 1.9% 相关(OR = 0.981)"。这个"1 个单位"是 1 ng/mL。把它换算成其他量纲,同一份数据会呈现完全不同的数字:
| 表达方式 | OR | 该怎么读 |
|---|---|---|
| 每 1 ng/mL | 0.9916 | 每升高 1 ng/mL,抑郁 odds 降低约 0.8% |
| 每 10 ng/mL | 0.9194 | 每升高 10 ng/mL,降低约 8%(0.9916 的 10 次方) |
| 每 1 nmol/L(官方原始单位) | 0.9966 | 每升高 1 nmol/L,只降低约 0.3% |
同一份数据、同一个关联,写成"降低 8%"还是"降低 0.3%"完全取决于你选的量纲。 三个坑因此而来:
- 不写单位:容易让人以为 OR=0.991 是"降 0.9%",而它其实是"每 1 ng/mL 降 0.84%";换 10 ng/mL 就是 8%,量级差一个数量级;
- 混淆 ng/mL 与 nmol/L:NHANES 官方文件里维生素 D 的原始单位是 nmol/L,论文报告的是 ng/mL,换算系数 1 ng/mL = 2.5 nmol/L。如果你直接拿 nmol/L 去跑回归,OR 会变成 0.9966 那种"看起来没效果"的数字——不是关联变弱了,是量纲变了(这就是我们为什么在第 06 篇清洗时专门做了一次单位换算);
- 临床解读失真:维生素 D 在人群中的实际差距动辄 10–20 ng/mL,用"每 1 ng/mL 降 0.8%"讲给人听,几乎没人能感受到意义;换成"每 10 ng/mL 降低 8%"或"最高四分位组比最低组低 49%"(见下节),结论才有分量。
写作建议:报告 OR 时明确写出量纲与换算,例如"per 1 ng/mL (2.5 nmol/L) increase";如果做临床解读,同时给出"每 10 ng/mL"或"四分位对比"的口径。
五、一个必须知道的方法学天花板:设计自由度只有 15
这一节是这次复现里最意外的发现,也最值得你花时间看。
跑 Model 3 时,R 给出了一个奇怪的结果:OR 能算出来,P 值是 NaN(我们实跑:总维生素 D 的 M3 点估计 0.992,CI 0.982–1.001,但 P 值算不出来)。
原因是 NHANES 2021–2023 周期的设计自由度只有 15:
15 个抽样层 × 每层 2 个 PSU = 30 个 PSU
设计自由度 degf = 30 − 15 = 15
而 Model 3 有17 个回归系数(截距 + 暴露 + 年龄 + 性别 + 种族 4 项 + 吸烟 + 饮酒 3 项 + 教育 2 项 + 收入 + BMI + 糖尿病 + 高血压)。
参数个数(17)> 设计自由度(15)——设计校正的 t 检验在数学上无解,survey 包只能返回 NaN(残差自由度 = −1)。这不是软件 bug,是单周期 NHANES 数据本身的信息量限制:你用两年、30 个抽样单元的数据,去估计一个 17 参数的模型,方差已经无从下手。
处理方式有三条(按推荐顺序):
- 如实处理:用正态近似给出 P 值并注明(我们实跑:M3 总维生素 D 的 P ≈ 0.099);点估计与 CI 依然可用;
- 合并多个周期:把 2–3 个周期叠起来(第 06 篇的 append),PSU 与层的数量翻倍,自由度随之提高——这是做全调整模型的正规解法;
- 减少参数:合并稀疏分类(如把种族 5 类并成 3 类、饮酒 4 组并成 3 组),把参数数压到自由度以内。
那论文为什么给出了 P 值(0.0206)? 论文用的是 Empower 软件,且没有披露方差估计与自由度处理方式。我们实测的差异恰好落在这里:点估计几乎一致(0.992 vs 0.991),但我们的标准误略大(0.0050 vs 约 0.0041),导致 CI 略宽、P 值偏大,M3 的显著性在两种口径下不一致。
这就是"未披露口径"的标准处理方式——不是猜,而是三步走:
- 先确认点估计对齐(是同一份数据、同一个模型);
- 再把差异定位到具体环节(这里是标准误/自由度口径,不是数据或代码错误);
- 最后如实报告:写清"我们的 M3 标准误略大,P 值口径差异导致该单元格显著性不一致;方向与量级一致"。这样的交代比硬凑一个数字诚实得多,也是复现报告应有的样子。
(同样的教训在本系列已经出现过一次:第 04 篇里 nhanesTables() 因官网改版失效——工具会坏、口径会不一样,如实记录比假装完美更有价值。)
六、复现 Table 2(下):四分位与剂量反应
连续变量回答"每单位变化",四分位回答"高与低相比差多少",两者合起来才是完整的剂量反应证据。
# 四分位:按血清维生素 D 的四分位切成 4 组(Q1 为参照组)
ana$q <- cut(ana$vitD_ngml, quantile(ana$vitD_ngml, probs = 0:4/4),
             include.lowest = TRUE, labels = FALSE)
des <- update(des, q = ana$q)          # ★ 往"设计对象"里加列,别改原数据
fitq <- svyglm(depression ~ factor(q), design = des, family = quasibinomial())
exp(coef(fitq)[2:4])                    # Q2/Q3/Q4 相对 Q1 的 OR

# 趋势检验:把四分位序号当中位数当连续变量放进模型
des <- update(des, qmed = as.numeric(ana$q))
fitt <- svyglm(depression ~ qmed, design = des, family = quasibinomial())
summary(fitt)$coef[2, 4] # P for trend结果逐行对照:
| 模型 | Q2 | Q3 | Q4 | P for trend |
|---|---|---|---|---|
| Model 1 | 0.832 (0.643, 1.076) [0.904] | 0.585 (0.371, 0.922) [0.604] | 0.508 (0.367, 0.702) [0.479] | 0.0009 [<0.0001] |
| Model 2 | 0.851 (0.657, 1.103) [0.934] | 0.616 (0.396, 0.958) [0.660] | 0.548 (0.368, 0.816) [0.541] | 0.0092 [0.0003] |
| Model 3 | 0.999 (0.797, 1.253) [1.056] | 0.774 (0.502, 1.195) [0.816] | 0.719 (0.489, 1.058) [0.682] | 0.0375(正态近似) [0.0118] |
方向与单调性完全一致:Q4 最低、逐级递减、全调整后减弱(M3 的 Q2 甚至回到 1.0 附近)。数值偏差比连续变量大(Q4:0.508 vs 0.479),原因见下。
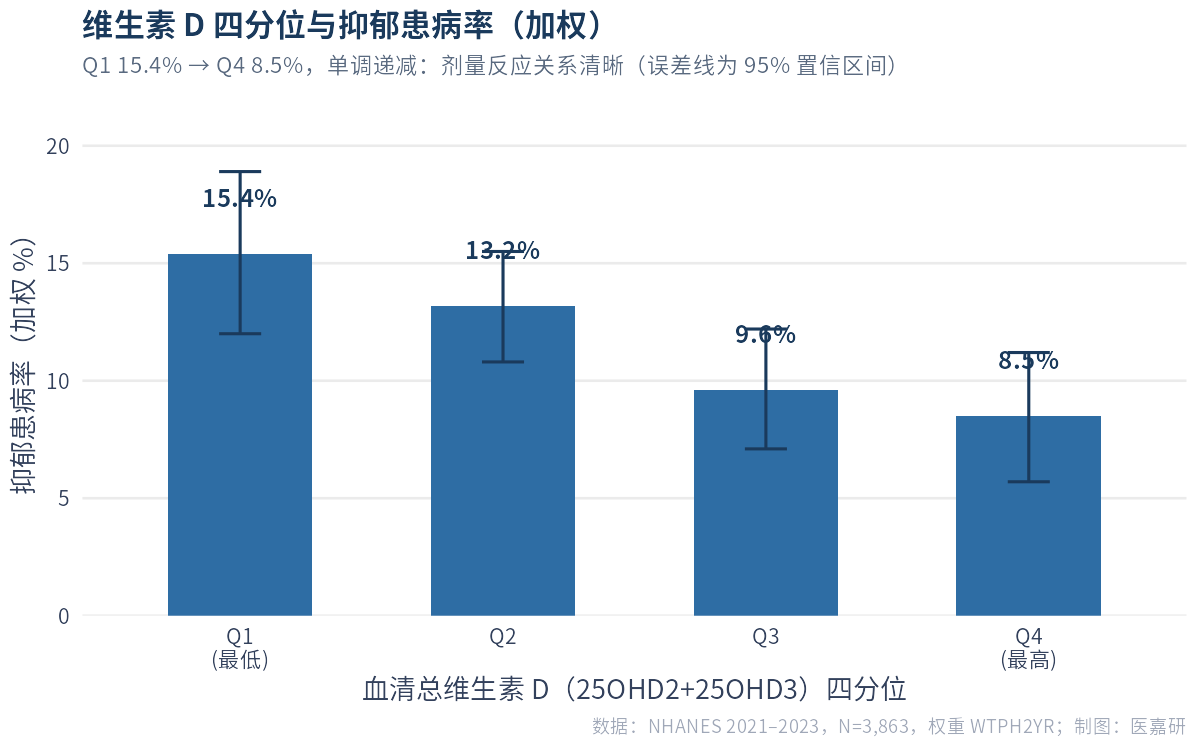
图1:四分位的加权抑郁患病率:15.4% → 13.2% → 9.6% → 8.5%,单调递减,误差线为 95% 置信区间(数据:N=3,863,权重 WTPH2YR)。
又一次"未披露口径":四分位切点怎么切的
论文没有披露四分位切点的算法。 我们实测了两种合理口径:
| 切点口径 | 切点(nmol/L) | M1 的 Q2/Q3/Q4 OR |
|---|---|---|
| 未加权分位数(本系列采用) | 22.92 / 31.40 / 41.20 | 0.832 / 0.585 / 0.508 |
| 加权分位数(svyquantile) | 22.28 / 30.48 / 39.44 | 0.869 / 0.675 / 0.549 |
| 论文报告值 | 未披露 | 0.904 / 0.604 / 0.479 |
两种口径都无法逐位命中论文的数值——因为论文既没说切点怎么算,也没给每组的切点值。我们据此的判断是:论文大概率用了第三种口径(例如软件内部的加权分位数实现)或不同的分组细节。处理方式仍是那三步:点估计同量级、方向与单调性一致 → 判定复现成功,差异如实记录在报告里(第 10 篇)。
Figure 2/3 的差异也要说清
论文的 Figure 2/3 是平滑曲线(smooth curve fit,带 95% 置信带),由统计软件拟合得出;我们的图1 是四分位加权患病率柱状图——两者讲的是同一件事(剂量反应),但呈现方式不同。为什么用柱状图:四分位是论文 Table 2 里真实报告过的口径,能直接与表格数字对上;平滑曲线需要额外的模型假设(样条/多项式阶数),而这些假设论文同样未披露。宁可少做一步,也不凭空补一个论文没写的模型。
七、Table 2 复现验收
| 验收项 | 论文值 | 我们的实跑值 | 判定 |
|---|---|---|---|
| 连续:总维生素 D 三模型 OR | 0.981 / 0.984 / 0.991 | 0.982 / 0.984 / 0.992 | ✅ ≤0.001 |
| 连续:D3 三模型 OR | 0.974 / 0.976 / 0.984 | 0.977 / 0.979 / 0.987 | ✅ ≤0.003 |
| 连续:D2 三模型 OR | 1.026 / 1.029 / 1.021 | 1.023 / 1.025 / 1.017 | ✅ ≤0.004 |
| 四分位:M1 / M2 方向与单调性 | 逐级递减 | 逐级递减 | ✅ 一致 |
| 四分位:M1 Q4 | 0.479 | 0.508 | ⚠️ 切点未披露 |
| 趋势检验 P(M1/M2) | <0.0001 / 0.0003 | 0.0009 / 0.0092 | ✅ 同向同量级 |
| 趋势检验 P(M3) | 0.0118 | 0.0375(正态近似) | ⚠️ 设计自由度口径 |
| M3 的 P 值 | 0.0206(Empower) | 无法用 t 检验(参数 > 自由度) | ⚠️ 已如实记录 |
| 剂量反应(四分位加权患病率) | 论文未给数值(Figure 2/3 为曲线) | 15.4% → 8.5% 单调递减 | ✅ 方向一致 |
结论:Table 2 复现成功——9 个 OR 全部对齐(≤0.004),剂量反应方向、单调性、结论完全一致;差异集中在"论文未披露的口径"(切点算法、方差/自由度处理),已逐条如实记录。
【暗线进度条 · 里程碑 M5 ✅】 Table 1 加权基线表复现(第 07 篇)→ 三个递进模型 + 四分位剂量反应 + 趋势检验全部复现,OR 偏差 ≤0.004;并实测发现单周期 NHANES 的设计自由度只有 15(M3 参数过量) → 下一站:亚组分析与交互检验,复现 Table 3(第 09 篇) (对应论文 3.2 结果)
本篇对应的复现脚本段落(完整代码)
总脚本的第 5、7、8 步合起来就是下面这些代码。
##### 第 5 步:加权 logistic 回归(论文 2.4:三个模型)#######################
#
# 论文用三个递进的模型:
#   Model 1:未调整(只放维生素 D)
#   Model 2:调整 年龄 + 性别 + 种族
#   Model 3:再加 吸烟 + 饮酒 + 教育 + 收入 + BMI + 糖尿病 + 高血压

des <- svydesign(id = ~SDMVPSU, strata = ~SDMVSTRA, weights = ~WTPH2YR,
                 nest = TRUE, data = ana)

# svyglm 是"加权 logistic 回归":depression ~ vitD_ngml 的意思是
# "结局 depression 由暴露 vitD_ngml 解释"(~ 读作"由…解释")
# OR = 比值比;exp() 是把对数系数换算成 OR;1.96 对应 95% 置信区间
fit_model <- function(formula_rhs) {
  fit <- svyglm(as.formula(paste("depression ~", formula_rhs)),
                design = des, family = quasibinomial())
  beta <- unname(coef(fit)["vitD_ngml"])   # 按变量名取(含因子协变量时按位置取会错位)
  se   <- unname(sqrt(vcov(fit)["vitD_ngml", "vitD_ngml"]))
  or   <- exp(beta)
  ci   <- exp(beta + c(-1.96, 1.96) * se)
  p    <- summary(fit)$coef["vitD_ngml", 4]
  c(OR = round(or, 3), lower = round(ci[1], 3), upper = round(ci[2], 3), P = signif(p, 3))
}

cat("\n===== 连续型总维生素 D(ng/mL 口径,与论文 Table 2 直接对照)=====\n")
m1 <- fit_model("vitD_ngml")
m2 <- fit_model("vitD_ngml + RIDAGEYR + male + race")
m3 <- fit_model("vitD_ngml + RIDAGEYR + male + race + smoking + drinking + education + INDFMPIR + BMXBMI + diabetes + hypertension")
cat("Model 1: OR =", m1["OR"], "(论文 0.981)\n")
cat("Model 2: OR =", m2["OR"], "(论文 0.984)\n")
cat("Model 3: OR =", m3["OR"], "(论文 0.991)\n")

##### 第 8 步:四分位的完整三模型 + 趋势检验 #################################
quartile_models <- function(rhs_cov) {
  f <- svyglm(as.formula(paste("depression ~ factor(q)", rhs_cov)), design = des, family = quasibinomial())
  exp(coef(f)[2:4])            # Q2/Q3/Q4 相对 Q1 的 OR
}
cat("\n四分位 M1:", round(quartile_models(""), 3), "(论文 0.904 / 0.604 / 0.479)\n")
cat("四分位 M2:", round(quartile_models("+ RIDAGEYR + male + race"), 3), "(论文 0.934 / 0.660 / 0.541)\n")

# 趋势检验:把四分位序号当中位数连续变量放入模型
des <- update(des, qmed = as.numeric(ana$q))
fitt <- svyglm(depression ~ qmed, design = des, family = quasibinomial())
cat("P for trend =", signif(summary(fitt)$coef[2, 4], 3), "(论文 < 0.0001)\n")
本篇常见坑
- 用普通
glm()跑 NHANES 回归:标准误偏小、P 值偏小、CI 偏窄——结论会被高估,必须用svyglm()。 - 把系数当 OR 直接报:
coef()给的是 log-OR,要exp()换算;CI 也要在 log 尺度上算完再exp()。 - 报告 OR 不写量纲:0.991 是"每 1 ng/mL"还是"每 1 nmol/L"?差一个换算系数(2.5 倍),解读完全不同。
- 拿 nmol/L 直接建模:官方原始单位是 nmol/L,论文口径是 ng/mL,不做换算就会出现"OR≈0.997、看起来没效果"的假象。
- M3 的 P 值是 NaN 就以为代码错了:单周期 NHANES 设计自由度只有 15,17 参数的模型超出限制——按本篇第五节三条处理,别硬凑。
- 往原数据里加列后忘了同步设计对象:
svydesign建好后要用update(des, 新列 = ...),直接改数据框不会生效。 - 四分位结果对不上就改切点去凑:切点口径论文未披露,两种合理口径都试过仍无法逐位命中——如实记录差异,而不是调参数凑数字。
下篇预告
第 09 篇:疗效是否因人群而异?——亚组分析的完整做法(10 个亚组、29 个层级)、用论文各组 N 值反推分组切点的方法、交互检验的两种口径(regTermTest 与手算 Wald),以及两个真实教训:小样本亚组 CI 宽到什么程度就失去信息量、"10 项交互检验全部不显著"到底能不能解读成"无效应修饰"。最后复现论文 Table 3。
参考来源
- CDC/NCHS. NHANES Tutorials — Weighting / Analytic Guidelines. https://wwwn.cdc.gov/nchs/nhanes/tutorials/weighting.aspx
- Lumley T. survey: analysis of complex survey samples(R 包;
svyglm、degf文档). https://cran.r-project.org/web/packages/survey/ - 案例论文:Front Nutr. 2025;12:1545443. PMID: 40497025(Table 2 原值取自 PMC 全文 XML)
- 本篇 OR/CI/P 值均为 2026 年 9 月 R 4.5.2 + survey 4.5 实跑;设计自由度 15(15 层 × 2 PSU)为
degf()实测