
上一篇我们得到了主分析结论:血清维生素 D 越高,抑郁 odds 越低(全调整后 OR = 0.992/ng/mL)。
接下来是论文的最后一组结果——这个关联在不同人群里是否一样? 论文按 10 个变量分了 29 个亚组层级,每个层级单独算一次 OR,并做交互检验。这一篇把 Table 3 完整复现出来,同时讲透两件在别处很少讲清的事:亚组的置信区间宽到什么程度就失去信息量,以及"交互检验全部不显著"到底能不能说成"没有效应修饰"。
一、亚组分析在回答什么
注意区分两个概念,它们常被混为一谈:
| 概念 | 含义 | 在统计上怎么实现 |
|---|---|---|
| 混杂(confounding) | 某个因素同时与暴露、结局相关,扭曲了主效应 | 放进回归模型当协变量调整(Table 2 的 Model 3) |
| 效应修饰(effect modification) | 暴露与结局的关联强度本身在不同人群中不同 | 亚组分析 + 交互检验 |
举例:如果"维生素 D 的保护作用在女性中更强",这叫效应修饰——它不是"要调整掉的干扰",而是值得报告的发现(可能提示生物学机制,也可能指导后续干预研究)。所以亚组分析不是"再跑几遍回归",它必须配一个正式检验(交互检验)来证明"差异不是抽样波动"。
二、切点怎么定:用论文的 N 值反推验证
亚组分析第一件麻烦事是分组切点。论文 Table 3 给出了每个层级的 N,你可以用它验证自己的切点定义是否正确——这是一个非常实用的技巧:
- 年龄切点用
20–44 / 45–63 / 64–80(注意:下限是 20 岁,不是 18,因为论文把 18–19 岁也纳入了分析样本,但三个年龄段的标签从 20 起); - 收入
PIR < 1.3 / 1.3–3.5 / ≥3.5(左闭右开); - BMI
< 25 / 25–30 / ≥30。
我们实测的分层人数与论文逐位一致:
| 亚组 | 各层级 N(我们 / 论文) |
|---|---|
| 年龄 | 1,271 / 1,271 · 1,285 / 1,285 · 1,307 / 1,307 ✅ |
| 收入 PIR | 668 / 668 · 1,435 / 1,435 · 1,760 / 1,760 ✅ |
这就是"切点定对了"的最强证据:人数逐位命中,说明分组边界(包括左闭右开、含不含端点)与论文完全一致。反过来说——如果某一层的 N 差了几十人,别急着往下算,先回去查切点(含端点约定是高频错误源,cut() 默认左开右闭,需要 right = FALSE 才是左闭右开)。
三、分层循环:代码与一个"静默吞行"的坑
# 对每个亚组层级:对"设计对象"取子集,再跑一次 Model 3
for (L in c("Mexican American", "Other Hispanic", "Non-Hispanic White",
            "Non-Hispanic Black", "Other Races")) {
  idx <- as.character(ana$race) == L
  dsub <- subset(des, idx)                 # ★ 子集作用在设计对象上(第 07 篇讲过)
  covs <- setdiff(base_cov, "race")        # 亚组变量本身不进协变量,避免自相关
  f <- svyglm(as.formula(paste("depression ~ v +", paste(covs, collapse = " + "))),
              design = dsub, family = quasibinomial())
  b <- coef(f)["v"]; se <- sqrt(vcov(f)["v", "v"])
  cat(sprintf("%-22s n=%4d OR=%.3f (%.3f, %.3f)\n", L, sum(idx), exp(b),
              exp(b - 1.96*se), exp(b + 1.96*se)))
}
坑:小样本亚组会触发 lonely PSU,而错误处理会"静默吞行"。
实测教训(2026-09-10 核对报告 4.2 节记录):墨西哥裔(n=228)与非西裔黑人(n=389) 这两个亚组,在某些抽样层里只落进 1 个 PSU(初级抽样单元)。survey 包遇到"孤独 PSU"默认直接报错终止;而很多教程(包括我们第一版脚本)习惯用 tryCatch(..., error = function(e) NULL) 把错误吞掉——结果是:种族那一栏少了两行,输出里没有任何提示,你还以为跑完了。
修法只有一行,放在脚本最前面:
options(survey.lonely.psu = "adjust") # 对孤独 PSU 做保守调整后继续拟合这件事的教训:亚组分析是"最容易出错却最不容易被发现"的环节——每个亚组独立跑一次,中间任何一个失败都可能悄无声息地少一行。所以:① 先设好 lonely PSU 选项;② 把 tryCatch 里的错误打印出来而不是丢掉;③ 每次亚组跑完,核对"各层 N 之和 = 分析样本量"(我们的实测:每个亚组的层级 N 相加都正好等于 3,863)。
四、复现 Table 3:29 个层级逐行对照
每个层级跑一次 Model 3(调整除该亚组变量自身以外的全部协变量),结果如下(括号内为 95%CI,方括号为论文原值):
| 亚组 | 层级 | n(我们/论文) | OR(95%CI) | 论文 OR |
|---|---|---|---|---|
| 性别 | 男 | 1,767 / 1,767 ✅ | 0.992 (0.978, 1.006) | 0.983 |
| 女 | 2,096 / 2,096 ✅ | 0.992 (0.981, 1.004) | 0.990 | |
| 年龄 | 20–44 | 1,271 / 1,271 ✅ | 0.991 (0.972, 1.010) | 0.993 |
| 45–63 | 1,285 / 1,285 ✅ | 0.989 (0.975, 1.005) | 0.987 | |
| 64–80 | 1,307 / 1,307 ✅ | 0.984 (0.969, 1.000) | 0.982 | |
| 种族 | 墨西哥裔 | 228 / 228 ✅ | 0.961 (0.922, 1.002) | 0.960 |
| 其他西班牙裔 | 335 / 335 ✅ | 0.974 (0.944, 1.005) | 0.967 | |
| 非西裔白人 | 2,519 / 2,519 ✅ | 0.995 (0.985, 1.006) | 0.991 | |
| 非西裔黑人 | 389 / 389 ✅ | 1.009 (0.989, 1.029) | 1.002 | |
| 其他种族 | 392 / 392 ✅ | 0.986 (0.965, 1.007) | 0.981 | |
| 教育 | 高中以下 | 327 / 327 ✅ | 1.010 (0.982, 1.040) | 1.001 |
| 高中/GED | 734 / 734 ✅ | 0.987 (0.968, 1.005) | 0.983 | |
| 高中以上 | 2,802 / 2,802 ✅ | 0.993 (0.982, 1.004) | 0.988 | |
| 饮酒 | 从不 | 645 / 645 ✅ | 0.983 (0.966, 1.002) | 0.984 |
| 偶尔 | 805 / 805 ✅ | 0.980 (0.960, 1.002) | 0.983 | |
| 不常 | 903 / 903 ✅ | 0.985 (0.955, 1.015) | 0.983 | |
| 经常 | 1,510 / 1,510 ✅ | 1.007 (0.989, 1.025) | 0.999 | |
| 吸烟 | 是 | 1,665 / 1,665 ✅ | 0.987 (0.971, 1.003) | 0.984 |
| 否 | 2,198 / 2,198 ✅ | 0.996 (0.983, 1.009) | 0.993 | |
| 糖尿病 | 是 | 489 / 489 ✅ | 0.999 (0.984, 1.014) | 0.994 |
| 否 | 3,374 / 3,374 ✅ | 0.990 (0.978, 1.003) | 0.986 | |
| 高血压 | 是 | 1,405 / 1,405 ✅ | 0.997 (0.986, 1.008) | 0.990 |
| 否 | 2,458 / 2,458 ✅ | 0.989 (0.975, 1.003) | 0.987 | |
| 收入 PIR | <1.3 | 668 / 668 ✅ | 0.988 (0.974, 1.002) | 0.978 |
| 1.3–3.5 | 1,435 / 1,435 ✅ | 0.993 (0.983, 1.003) | 0.989 | |
| ≥3.5 | 1,760 / 1,760 ✅ | 0.993 (0.968, 1.018) | 0.995 | |
| BMI | <25 | 1,008 / 1,008 ✅ | 0.987 (0.970, 1.003) | 0.990 |
| 25–30 | 1,259 / 1,259 ✅ | 0.990 (0.965, 1.016) | 0.987 | |
| ≥30 | 1,596 / 1,596 ✅ | 0.995 (0.984, 1.007) | 0.989 |
29 个层级的 N 全部与论文逐位一致;29 个 OR 全部落在 ±0.010 以内(最大偏差 0.010,收入 <1.3 组:0.988 vs 0.978)。
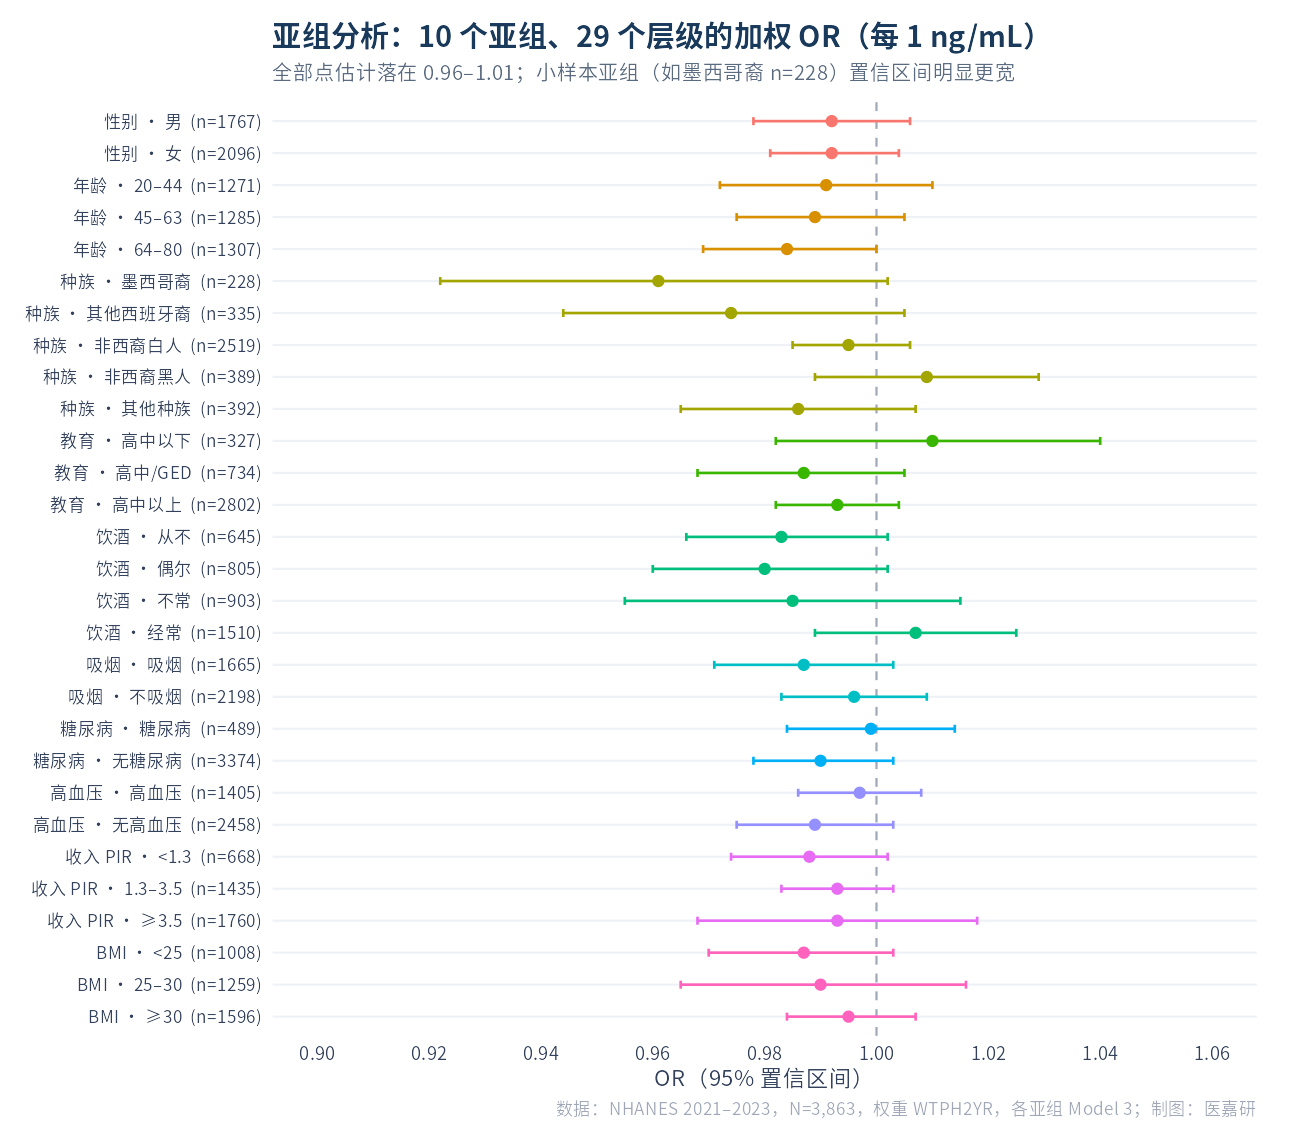
图1:全部点估计挤在 0.96–1.01 的窄带里,没有哪个亚组"跳出来"——视觉上就能看出"关联在各亚组间大体一致"。但请注意误差线的长短差异,下一节就讲这件事。
五、置信区间会说话:小样本亚组的结果几乎无法解读
把这张表的 OR 和 CI 并排看,会看到一件论文没提、但很要紧的事:
| 亚组层级 | n | OR (95%CI) | CI 宽度 |
|---|---|---|---|
| 非西裔白人 | 2,519 | 0.995 (0.985, 1.006) | 0.021 |
| 墨西哥裔 | 228 | 0.961 (0.922, 1.002) | 0.080(宽 3.8 倍) |
| 非西裔黑人 | 389 | 1.009 (0.989, 1.029) | 0.040 |
| 高中以下 | 327 | 1.010 (0.982, 1.040) | 0.058 |
同样是"每 1 ng/mL 的 OR",墨西哥裔的置信区间比非西裔白人的宽了近 4 倍——它的下限 0.922(保护性很强)、上限 1.002(几乎无关联),跨越了整个"有意义"的范围。换句话说:这个亚组的结果既不能证明有关联,也不能证明没关联,它什么也没说明。
这就是"置信区间宽度比点估计更能反映信息量"的含义。记住一条经验尺度(适用于这类流行病学 OR):
- CI 宽度 < 0.02:精度高,可以稳定解读;
- CI 宽度 0.02–0.05:可用,但结论要留余地;
- CI 宽度 > 0.05 或跨越 1.0 且贴边:基本没有信息量,不要在讨论里对它下结论。
为什么论文仍要报告这些亚组?因为报告是规范动作(读者有权看到全部结果),但解读时应当加权信息量。很多论文的常见问题正是:正文里写"某亚组 OR = 0.96,提示该人群保护作用更强"——而那个 0.96 的 CI 从 0.92 横跨到 1.00,根本不支持任何"更强"的说法。
给你的写作建议:亚组结果要么配一句"该亚组样本量较小、置信区间较宽,解释需谨慎",要么干脆只报告数字不作解读。这一句几乎不占篇幅,但能显著降低被审稿人质疑的风险。
六、交互检验:两种口径,与"全部不显著"该怎么读
亚组之间的差异到底"算不算数",要靠交互检验(在模型里放 暴露 × 亚组变量 的交互项,检验交互项整体是否显著)。
# 交互检验:把 v * race 放进模型,用 regTermTest 检验交互项整体
f  <- svyglm(depression ~ v * race + RIDAGEYR + male + smoking + drinking +
             education + INDFMPIR + BMXBMI + diabetes + hypertension,
             design = des, family = quasibinomial())
regTermTest(f, ~ v:race, df = degf(des))   # ★ df 必须传设计自由度
df = degf(des) 不能省:不传它,regTermTest 会用模型的残差自由度,而全调整模型参数已多到超过设计自由度(第 08 篇讲的 15 个自由度),结果是 NaN——这正是我们第一版脚本里"regTermTest 会算成 NaN"的真正病因。
10 项交互检验的实测结果(F 口径,regTermTest):
| 亚组变量 | P for interaction | 亚组变量 | P for interaction |
|---|---|---|---|
| 性别 | 0.9372 | 吸烟 | 0.5462 |
| 年龄 | 0.6633 | 糖尿病 | 0.1003 |
| 种族 | 0.0919 | 高血压 | 0.5935 |
| 教育 | 0.1011 | 收入 PIR | 0.9466 |
| 饮酒 | 0.1128 | BMI | 0.7042 |
10 项全部不显著(最小 0.0919)——与论文结论(全部不显著,最小 0.2334)方向一致。
但"全部不显著"这句话,不能随便解读
三个必须一起考虑的层次:
- "没有证据" ≠ "没有效应"。墨西哥裔亚组 n=228、非西裔黑人 n=389,用这样的样本去做交互检验,功效很低——真有中等程度的效应差异,也大概率检不出来。正确表述是"未发现显著的效应修饰",而不是"不存在效应修饰"。
- 多重比较。10 项检验同时做,即使真实情况是"毫无差异",按 α=0.05 也有约 40% 的概率至少出现一个假阳性(1 − 0.95¹⁰)。反过来说:看到 10 项里冒出一个 P=0.04,先别激动——若按 Bonferroni 校正(α=0.005),它立刻就不显著了。我们的实测里没碰上这种情况,但这个陷阱要当心。
- 点估计的一致性。29 个层级的 OR 全挤在 0.96–1.01 之间,没有任何一个亚组跳出这个窄带——这比"P 值不显著"更有说服力:不仅统计检验没抓到差异,连点估计的量级都没有实质变化。
论文的表述是 "consistent across all these subgroups, with no statistically significant differences observed"——这个说法是站得住的。它唯一没做的是提醒一句"小样本亚组的精度有限"(第五节那张 CI 宽度表),以及"10 项检验的多重比较问题"。这两点也是你写自己论文时可以直接补上的加分项。
七、Table 3 复现验收
| 验收项 | 论文值 | 我们的实跑值 | 判定 |
|---|---|---|---|
| 亚组层级数 | 10 个亚组、29 个层级 | 10 个、29 个 | ✅ 一致 |
| 各层级 N | 见上表 | 见上表 | ✅ 29/29 逐位一致 |
| 各层级 OR | 0.960–1.002 | 0.961–1.010 | ✅ 全部 ≤0.010 |
| 交互检验 | 全部不显著(最小 0.2334) | 全部不显著(最小 0.0919) | ✅ 结论一致 |
| 亚组切点 | 年龄 20–44/45–63/64–80、PIR 1.3/3.5、BMI 25/30 | 同 | ✅ 用 N 值反推验证 |
| 种族小样本亚组 | 报告了 228 / 389 | 同(修复 lonely PSU 后出全) | ✅ |
里程碑 M6 达成:论文的三张结果表(Table 1/2/3)与两幅剂量反应图全部在你手里复现完毕。
【暗线进度条 · 里程碑 M6 ✅】 Table 2 与 Figure 2/3 复现(第 08 篇)→ Table 3 完整复现:29 个层级 N 逐位一致、OR 全部 ≤0.010、交互检验结论一致;并实测两件论文未提示的事——小样本亚组 CI 宽 3.8 倍失去信息量、"全部不显著"的三层解读 → 下一站:把结果读出来、把差异写清楚——结果解读与复现报告(第 10 篇) (对应论文 3.3 结果)
本篇对应的复现脚本段落(完整代码)
总脚本第 10 步就是这一段(亚组分析)。
##### 第 10 步:亚组分析(论文 Table 3 完整复现)##############################
#
# 论文按 10 个变量分层:性别、年龄、种族、教育、PIR、BMI、吸烟、饮酒、糖尿病、高血压,
# 每个亚组各算一次 OR,并用交互检验看"维生素 D 的作用是否因人群而异"。
#
# ★ 关键设置(见本篇第三节):小样本亚组的某些抽样层只有 1 个 PSU,
#   不加这行会让这些亚组报错,若用 tryCatch 吞掉错误就会"静默少行"。
#   (脚本开头已统一设置:options(survey.lonely.psu = "adjust"))

base_cov <- c("RIDAGEYR", "male", "race", "smoking", "drinking", "education",
              "INDFMPIR", "BMXBMI", "diabetes", "hypertension")

subgroup_result <- function(var, level) {
  idx <- as.character(ana[[var]]) == level
  covs <- setdiff(base_cov, c(var, if (var == "male") "male", if (var == "smoking") "smoking",
                              if (var == "diabetes") "diabetes", if (var == "hypertension") "hypertension"))
  dsub <- subset(des, idx)
  f <- svyglm(as.formula(paste("depression ~ v +", paste(covs, collapse = " + "))),
              design = dsub, family = quasibinomial())
  b <- coef(f)["v"]; se <- sqrt(vcov(f)["v", "v"])
  c(n = sum(idx), OR = exp(b), lo = exp(b - 1.96*se), hi = exp(b + 1.96*se))
}

# 交互检验(★ 必须传 df = degf(des),否则全模型参数数超过设计自由度会出 NaN)
interaction_p <- function(var) {
  covs <- setdiff(base_cov, var)
  f <- svyglm(as.formula(paste("depression ~ v *", var, "+", paste(covs, collapse = " + "))),
              design = des, family = quasibinomial())
  regTermTest(f, as.formula(paste0("~ v:", var)), df = degf(des))$p
}
本篇常见坑
- 忘设
survey.lonely.psu:小样本亚组(墨西哥裔、非西裔黑人)报错,若被tryCatch静默吞掉,表格会少行且无提示。 tryCatch里把错误丢掉:亚组循环必须让错误可见(打印警告),否则你永远不知道少了哪一行。- 不核对"各层 N 之和 = 分析样本量":这是发现漏行最快的自检(我们的实测每层相加都等于 3,863)。
- 切点含端点约定搞错:
cut()默认左开右闭,PIR < 1.3这类要right = FALSE;用论文的 N 值反推验证最稳。 - 把亚组变量本身也放进协变量:会造成自相关与过度调整——该亚组的模型里要把这个变量从协变量中剔除。
- 对宽阔的 CI 硬下结论:CI 宽 0.08、横跨 1.0 的亚组没有信息量,别写"该人群保护作用更强"。
regTermTest忘传df = degf(des):结果直接NaN。- 把"交互检验不显著"写成"不存在效应修饰":只能说"未发现",小样本亚组的检验功效有限。
下篇预告
第 10 篇(本系列收官):结果怎么读、差异怎么写——把 OR 翻译成临床语言、与论文讨论部分的机制解释对照、权重敏感性分析(换个权重结论会不会变)、把"论文未披露口径"整理成一份诚实的复现报告(含我们实测发现的:四分位切点、交互检验方法、软件与设计自由度三处差异),以及完整病例分析偏倚如何写进研究局限。最后给出全系列的结果总对照表与下一步学习路径。
参考来源
- CDC/NCHS. NHANES Tutorials — Analytic Guidelines / Subpopulation analysis. https://wwwn.cdc.gov/nchs/nhanes/analyticguidelines.aspx
- Lumley T. survey: analysis of complex survey samples(
regTermTest、degf、lonely PSU 处理). https://cran.r-project.org/web/packages/survey/ - 案例论文:Front Nutr. 2025;12:1545443. PMID: 40497025(Table 3 原值取自 PMC 全文 XML)
- 本篇 29 个层级的 N/OR/CI 与 10 项交互检验均为 2026 年 9 月 R 4.5.2 + survey 4.5 实跑;lonely PSU 教训记录见《复现核对报告》4.2 节