
一位内分泌科的同行曾和我聊起他的困境:手头的课题需要"有代表性的成年人血糖数据",自己收病例,一年也攒不了几百例,还全是单中心的——审稿人一句"外推性存疑"就能把他拒掉。
我给他推荐了一个美国数据库:样本经过全国抽样设计、体检在标准化移动体检车上完成、实验室检测有严格质控,而且绝大多数数据公开、免费下载(少数敏感变量需向美国 CDC 的数据中心 RDC 付费申请,第 03 篇会讲怎么识别)。这个数据库叫 NHANES。
不过我要先把丑话说在前面:靠 NHANES"随便挖挖就能发文章"的时代已经过去了。这个系列不教你怎么"薅羊毛",而是教你如何把这个数据库用对、用规范,这是当下唯一可持续的竞争力。
这个系列怎么教:我们不打算把 NHANES 拆成一堆孤立的知识点讲,而是带着你完整复现一篇真实发表的 NHANES 论文——从选题自查、下载数据、合并清洗,到加权描述、加权回归、亚组分析,最后把自己的结果与论文的每一张表逐格对照。知识在复现的过程中逐一讲清,做到最后,你手里既有"会用"的能力,也有一份与论文数字逐级对上的复现结果。
作为开篇,这一篇解决三个问题:NHANES 是什么、它的数据凭什么能代表全美国、以及它适合回答什么样的研究问题。
一、NHANES 是什么:60 余年的全国健康监测
NHANES(National Health and Nutrition Examination Survey,美国国家健康与营养检查调查)由美国疾控中心(CDC)下属的国家健康统计中心(NCHS)主持,是美国评估国民健康与营养状况的核心调查,也是美国唯一覆盖全年龄段、同时包含健康检查、实验室检测和膳食访谈的全国性健康调查。
它的数据实实在在地改变过公共卫生史:1970 年代,NHANES 首次提供了美国人群血铅超标的确凿证据,直接推动了汽油无铅化;儿科医生诊室里张贴的儿童生长曲线,正是用 NHANES 的体格测量数据绘制的;谷物中铁和叶酸的强化政策、未诊断高血压和糖尿病的全国性监测,也都建立在 NHANES 数据之上。了解这段历史有助于理解:这个数据库的分量不是靠发文量堆出来的。
它并不是一开始就是今天的样子(见图1):前身是 1959 年启动的健康检查调查(NHES);1971–1975 年的 NHANES I 首次把"营养"纳入核心内容;经历了 II 期、III 期之后,1999 年起转为连续调查——每年现场调查,每 2 年合并为一个数据周期公开(1999–2000、2001–2002……)。目前最新公开的是 2021–2023 周期。
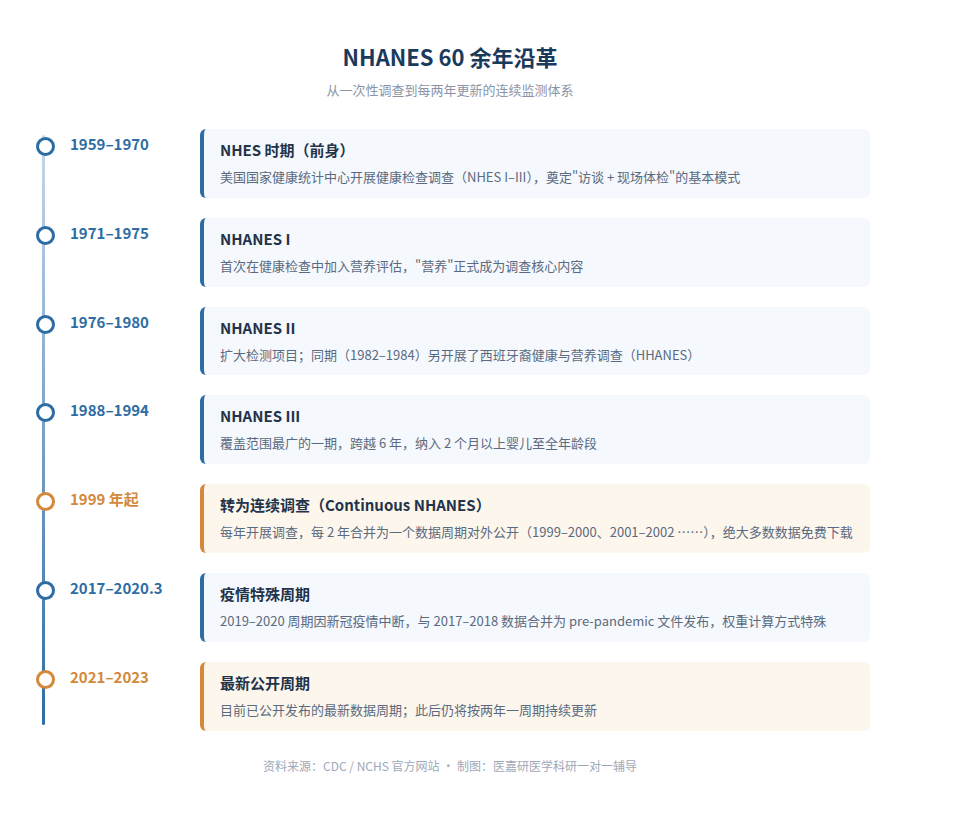
图1:这里只需要记住一件事:从 1999 年起,NHANES 是"两年一周期、持续更新"的,这是后续所有数据操作(选周期、合并周期)的前提。另需注意,2017 年至 2020 年 3 月的数据被合并为"疫情前"(pre-pandemic)特殊周期发布,文件结构与权重规则与众不同,第 02 篇讲周期命名时会专门讲到。
二、抽样设计:几千到一万多人,凭什么代表全美国
"全国代表性"是 NHANES 最值钱的地方,也是最容易被囫囵吞枣的地方。它不靠样本量大,而靠多阶段分层抽样的设计(见图2)。
每个两年周期,NHANES 从全国抽出的受访者不过几千到一万多人——规模随周期略有浮动,相对全美国几亿人口只是沧海一粟。它凭什么代表全国?靠的不是人多,而是抽法:每年现场调查,分四个阶段逐级抽取受访者:第一阶段从全国 3000 多个县中分层抽取约 15 个县(主要抽样单元 PSU);第二阶段在入选县内抽取街区/片区;第三阶段在片区内按住户清单抽取家庭户;第四阶段在住户内按规则抽取个人。
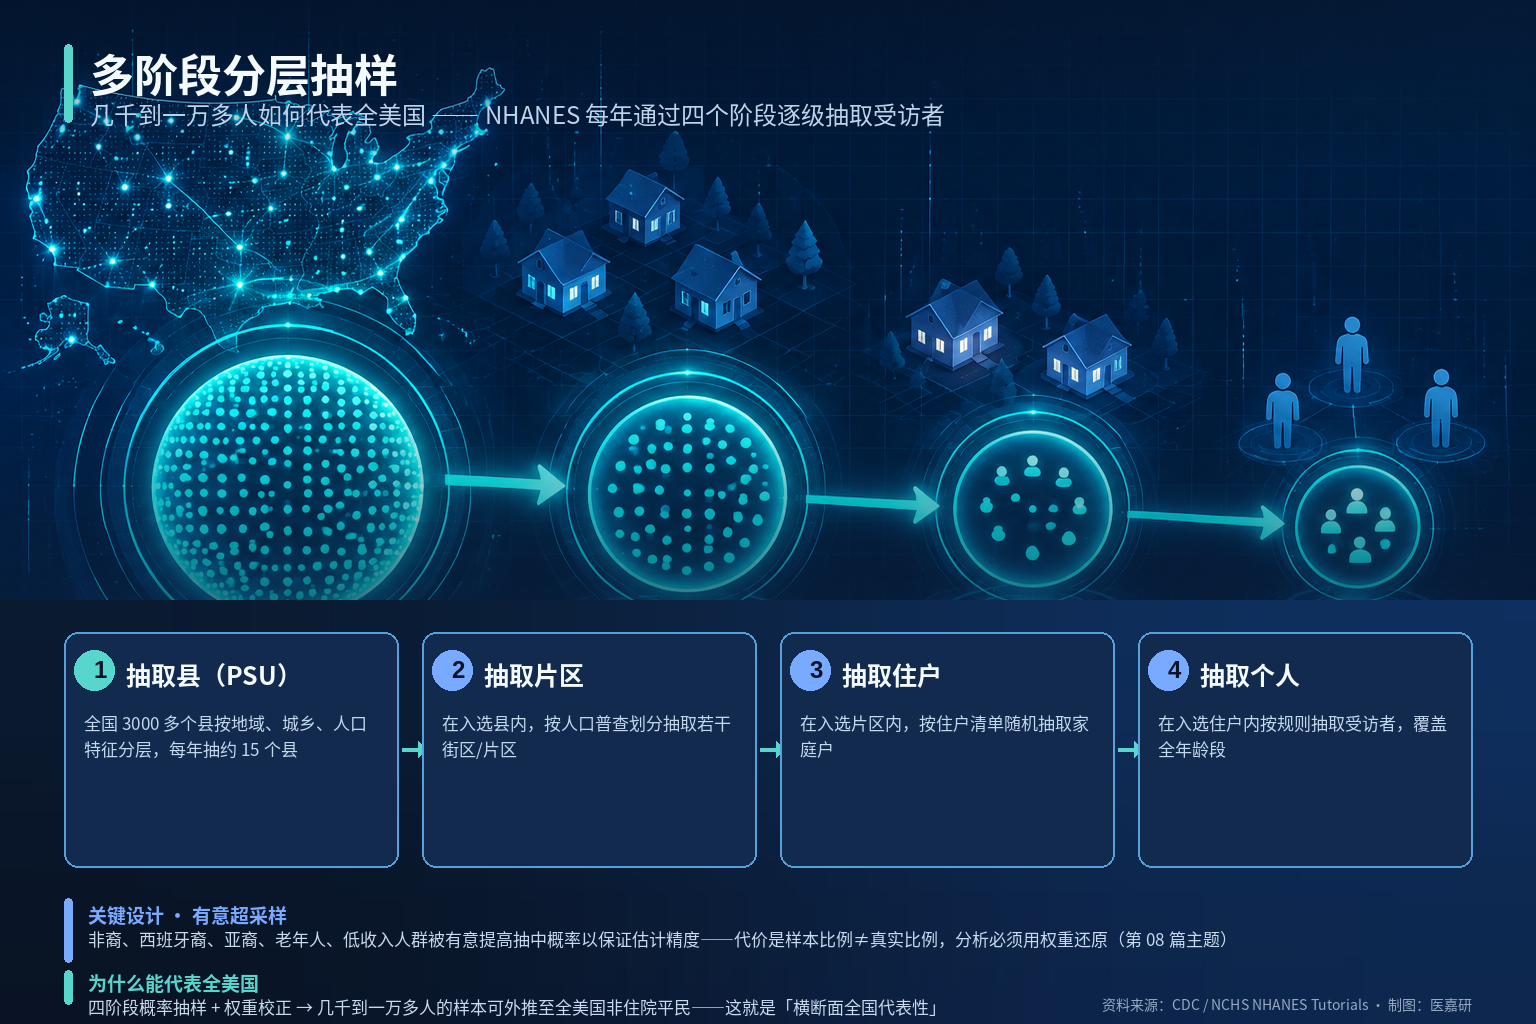
图2:四阶段概率抽样的含义是:每个美国非住院平民都有一个已知且非零的被抽中概率——这就是"代表性"的数学基础。
图中还有两个要点值得停下来理解:
其一,有意超采样。 NHANES 多数周期会有意提高特定人群的抽中概率——历史周期主要面向非裔、西班牙裔、亚裔、老年人、低收入人群(各周期超采对象不同,如 2011 年起超采亚裔),目的是让这些"小人群"的估计足够精确;而 2021–2023 疫情周期取消了种族/收入超采,改为全部抽取 0–19 岁和 60 岁及以上的家庭成员。但不管哪种设计,代价都是样本里的人群比例≠真实人群比例。
所以分析时必须用"权重"把比例还原回去。 权重是什么?一句话:每个受访者都带一个"代表系数",表示他这一票背后代表多少个没被抽到的美国人——被超采的人群,系数小;被少抽的人群,系数大。算全国患病率、均值、关联时按系数加权,结果才代表全美国而非"这几千个受访者"。这是 NHANES 最重要的概念,本篇先建立这个直觉,第 07 篇会结合案例论文把它讲透并直接产出论文的第一张结果表。
其二,质量控制。 体检不在各医院分散进行,而是集中到标准化的 MEC 移动体检车上完成,实验室检测有统一质控流程。这保证了不同地区、不同年份的数据可比。
三、两个现场、五类文件:数据的"出生地"
每位受访者经历两个环节(见图3):先是家庭访谈(人口学、疾病史、用药、生活方式问卷),再被邀请到 MEC 移动体检车完成标准化体检、血尿样本实验室检测和第一次 24 小时膳食回顾(第二次回顾通常在 3–10 天后通过电话随访完成)。
所有数据最终整理为五类公开文件:Demographics(人口学)、Questionnaire(问卷)、Examination(体检)、Laboratory(实验室)、Dietary(膳食),每个周期合计数千个变量,覆盖内分泌、营养、心血管、肾脏、精神心理、口腔等几乎所有临床方向——第 03 篇的选题自查会教你把自己的研究方向映射到具体变量上。
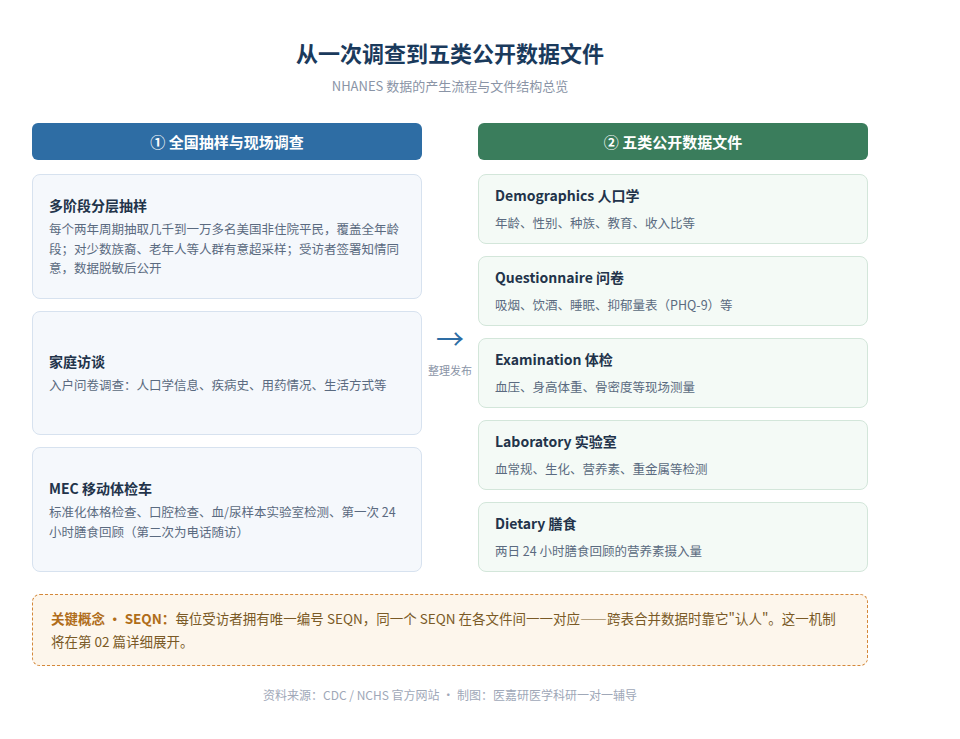
图3:这一阶段只需建立"文件地图"的直觉:变量按产生方式分属不同文件,同一个受访者靠唯一编号 SEQN 跨表对应。具体结构下一篇展开。
四、关键认知:NHANES 是横断面调查
这是入门阶段最容易被忽视、却最影响研究设计的一点:每个周期的 NHANES 都是横断面的——同一时点测量暴露与结局。
它适合回答:某暴露因素与某健康结局在人群中的关联(如维生素 D 水平与抑郁的关联)、疾病/危险因素的患病率估计、人群水平的时间趋势描述。
它不适合回答:因果推断("A 导致 B"在横断面数据中无法确证时序)、疾病发生风险的前瞻性预测、干预效果评价。若选题天然要求因果或时序,需要考虑别的数据源,或通过 NDI 链接的死亡率随访数据获得部分结局信息(第 04 篇会讲获取方式)。案例论文自己在结论里也明确写了"横断面设计无法推断因果"——这是规范写法,第 10 篇会专门拆解这句话该怎么写、为什么必须写。
先想清楚"NHANES 能不能回答我的问题",再动手下载数据——这也是我们把"选题可行性自查"安排在第 03 篇、而不是上来就教下载的原因。
五、发文现状:数据在涨,门槛也在涨
用 PubMed 检索式 ("National Health and Nutrition Examination Survey"[Title/Abstract]) OR (NHANES[Title/Abstract]) 实测(检索日期:2026 年,可在文末链接复现):标题或摘要中提及 NHANES(全称或缩写)的文献累计约 3.6 万篇;年度发文量从 2021 年的 1944 篇,增长到 2023 年的 3127 篇、2024 年的 5201 篇、2025 年的 6800 余篇。
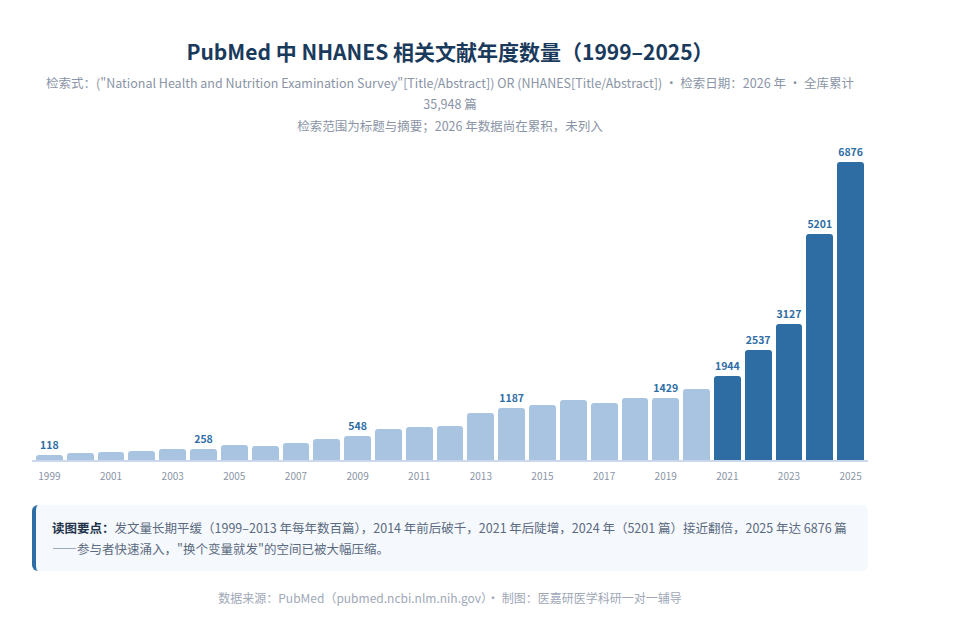
图4:数据为 PubMed 实测,检索式与日期都标在图上,你可以照着复现。
数字背后是明确的信号:参与者越来越多,简单换变量、套路化分析的文章越来越难通过审稿。不加权、不做复杂抽样校正、选题缺乏临床意义——这些是 NHANES 稿件被拒的最常见原因。本系列的立场是:与其追逐发文速度,不如把抽样、权重、方差这些"麻烦"的基本功练扎实。
六、本系列怎么学:完整复现一篇真实论文
为为避免"看的时候都懂、用的时候全忘",整个系列设了一条暗线:完整复现一篇真实发表的、使用 NHANES 公开数据的论文。从第 02 篇起,每一篇的实操——查变量、下载、合并、清洗、加权描述、加权回归、亚组分析——全部围绕这篇论文展开:走到第 06 篇,你会亲手把数据合并清洗到与论文完全一致的 3,863 人;走到第 09 篇,论文的每一张表、每一幅图你都自己跑出来过。
先把终点说清楚,这样每一篇你都知道自己在走向哪里。这篇论文一共报告了 6 块结果,我们的目标是一块不落地复现,并且每一块都有原文数字可以逐格核对:
| 论文结果 | 内容 | 复现它的教程篇目 |
|---|---|---|
| Figure 1 | 样本筛选流程图:11,933 → 3,863 的逐级排除 | 第 06 篇 |
| Table 1 | 加权基线特征表:按有无抑郁分组,连续变量加权均值、分类变量加权百分比、组间 P 值 | 第 07 篇 |
| Table 2 | 主分析:三个递进模型的 OR,含连续型(总量/D2/D3)与四分位剂量反应、趋势检验 | 第 08 篇 |
| Figure 2、Figure 3 | 剂量反应曲线:维生素 D 水平与抑郁患病率的平滑关系(含 95% 置信带) | 第 08 篇 |
| Table 3 | 亚组分析:10 个亚组的 OR 与交互检验 P 值 | 第 09 篇 |
| Discussion / Conclusion | 结果解读、机制讨论、研究局限(含横断面设计的因果边界) | 第 10 篇 |
论文的每一节,都对应教程的一篇(见图5):全套 10 篇走完,等于把这篇论文从数据来源到结论讨论完整走过一遍。
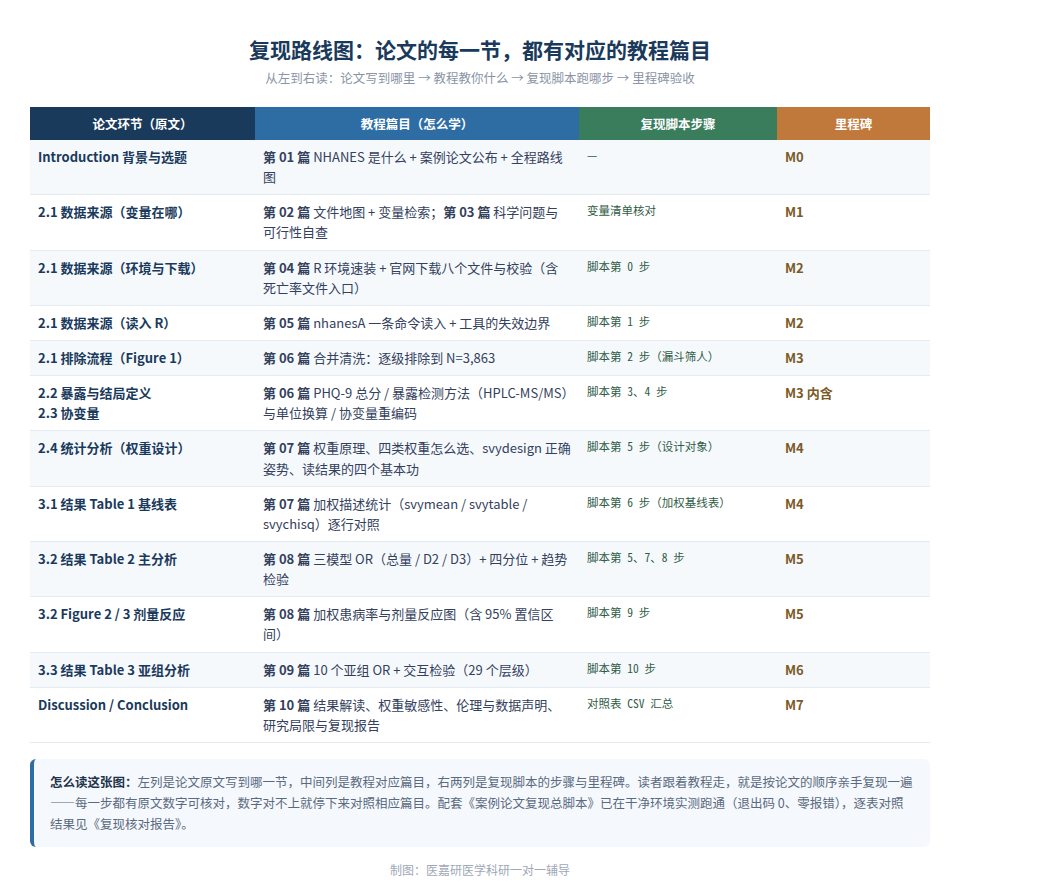
图5:这张表是全系列的"总地图":左列是论文写到哪一节,中间列是教程教你什么,右列是复现脚本跑哪一步与里程碑验收。
整个复现工程另有两份配套资产:一份《案例论文复现规格书》,列明每一步的验收标准(里程碑 M0–M7),每篇做完都对照验收;一份完整可运行的复现总脚本(案例论文复现总脚本.R,约 500 行,逐行中文注释),按论文方法学章节分 10 步,零基础可直接整段运行,每一步都会打印"该看到的数字"供你核对。这份脚本已在干净环境实测跑通(退出码 0、零报错零告警),与原文逐表对照的结果见《复现核对报告》。
本系列选定的案例论文:
| 项目 | 信息 |
|---|---|
| 中文标题 | 美国成人维生素 D 与抑郁患病率的关联:基于 NHANES 2021–2023 的横断面分析 |
| 英文标题 | Association of vitamin D with depression prevalence in U.S. adults: a cross-sectional analysis from NHANES 2021 to 2023 |
| 期刊 | Frontiers in Nutrition(SCIE 开放获取期刊,近年影响因子约 4–5 分(2026 年 9 月查询,近年有波动)) |
| 发表年份 | 2025 年 |
| 数据 | NHANES 2021–2023 周期(目前最新公开周期),全部公开数据 |
| 样本 | 3,863 名美国成年人 |
| 暴露 | 血清维生素 D(25-羟维生素 D2 / D3,实验室检测) |
| 结局 | PHQ-9 抑郁量表评分 ≥10 分判定为有抑郁症状 |
| 分析方法 | 多因素加权 logistic 回归,三模型递进(未调整 → 调整人口学 → 全调整,含 BMI/吸烟/饮酒/高血压/糖尿病),并做四分位剂量反应与 10 个亚组分析 |
| 获取方式 | PubMed PMID: 40497025;PMC 开放获取全文 |
为什么选它:变量少(暴露、结局、协变量合计不超过 10 个)、方法常规(加权 logistic 回归、亚组分析都是流行病学标准动作)、用的是最新公开周期、全文开放获取,方便逐格对照。需要声明:复现的目的是掌握规范流程,不代表复现成功即可发表。
结合本篇内容可以看到,这篇论文用到了三类数据文件:Demographics(年龄、性别、种族等协变量)、Questionnaire(PHQ-9 抑郁量表)、Laboratory(血清维生素 D 检测);因为暴露来自体检车的实验室检测,权重上要用到专门的采血权重(而非普通访谈权重)——这些术语现在看不懂没关系,下一篇先把"文件地图"讲透。
【暗线进度条 · 复现里程碑 M0】 案例论文已确定(Front Nutr 2025,维生素 D × 抑郁),全程 6 块结果的复现路线已排定 → 下一站 M1:列出案例论文的完整变量清单(第 02 篇)。全系列里程碑 M0–M7 见《案例论文复现规格书》
本篇常见坑
- 把 NHANES 当普通病例数据用:忽视抽样设计和权重,直接按简单随机样本分析——方法学硬伤,审稿人一票否决。
- 以为"全国代表性"是白来的:代表性来自"概率抽样 + 权重校正"的组合,只做抽样不加权,超采样人群的失真不会被自动修正。
- 以为横断面能做因果:在讨论中把"关联"写成"导致/预防",是被拒稿的高频原因。
- 上来就囤数据:不先确认目标变量在哪些周期存在、样本量够不够,下载了一堆用不上的文件。
- 只做数据准备,不走到结果:把"数据集构建完"当成终点。数据准备得再干净,最后没有可解释的结果,等于工程做了一半就收工——所以本系列的结果篇(第 07–10 篇)与准备篇同样重要。
下篇预告
第 02 篇:一个人对应多少张表?看懂 NHANES 的"文件地图"——五大类数据文件、SEQN 唯一标识、变量名前缀暗号、周期命名规则(含疫情特殊周期的 P_ 前缀),并列出案例论文的完整变量清单。
参考来源
- CDC/NCHS. NHANES Tutorials. https://wwwn.cdc.gov/nchs/NHANES/tutorials/default.aspx
- CDC/NCHS. NHANES Tutorials — Sample Design. https://wwwn.cdc.gov/nchs/nhanes/tutorials/SampleDesign.aspx
- CDC/NCHS. About NHANES. https://www.cdc.gov/nchs/nhanes/about/index.html
- CDC/NCHS. What NHANES Data Have Achieved. https://www.cdc.gov/nchs/nhanes/publications/data-accomplishments.html
- PubMed 检索(可复现):https://pubmed.ncbi.nlm.nih.gov/?term=%28%22National+Health+and+Nutrition+Examination+Survey%22%5BTitle%2FAbstract%5D%29+OR+%28NHANES%5BTitle%2FAbstract%5D%29
- 案例论文:Front Nutr. 2025;12:1545443. PMID: 40497025. https://pubmed.ncbi.nlm.nih.gov/40497025/