
先打一个比方。NHANES 的公开数据就像一个大型病历档案室,但它的归档方式和医院不太一样:
- 档案按"内容类别"分成几个大库——体检报告、化验单、问卷表、拍片、膳食记录……这就是"组件(Component)";
- 每个大库里又有几十个册子——化验单库里挨着"血常规"、"生化全套"、"维生素D检验"……每一册就是一个"数据文件(Data File)";
- 每个册子里是很多行卡片,每张卡片是一个人——一行即一个受访者,竖着对应的每一列是一个变量;
- 所有卡片都用同一个"档案编号"(SEQN)互相认领,这样"体温"在体检册、"血糖"在化验册,拼起来仍是同一个人。
这篇就是带你把这个档案室从总大门一路走到具体某个变量的说明书。
一、"五类组件"≠"五个文件":先纠正一个最大的误会
第 01 篇说数据分五类:Demographics、Questionnaire、Examination、Laboratory、Dietary。但初学者最容易误会成"NHANES 一共 5 个文件"——大错。五类只是"分类",每一类下面都挂着几十个具体文件。
以我们案例用到的 Laboratory(实验室)组件为例,2021–2023 周期这一组件下就有 32 个数据文件:
AGP_L,ALB_CR_L,BCHE_L,BIOPRO_L,CBC_L,COT_L,FAR_L,FASTQX_L,FERTIN_L,FFMR_L,FOLATE_L,FOLFMS_L,GHB_L,GLU_L,HDL_L,HEPA_L,HEPBD_L,HEPB_S_L,HEPC_L,HEPE_L,HSCRP_L,IHGEM_L,INS_L,PBCD_L,PFAS_L,TCHOL_L,TFR_L,TRIGLY_L,TST_L,UCPREG_L,VID_L,VOCWB_L
一眼可见:CBC_L 是血常规、GLU_L 和 TCHOL_L 是血糖和总胆固醇、TST_L 是睾酮、VID_L 是维生素 D……每个文件各管一组变量。我们的 Vid 变量就在 VID_L 里。
所以正确路径是:先确定你的变量属于哪个组件 → 再定位到组件下的具体文件 → 再在文件里找变量。官网的"Data"页面的核心用法就是按组件(Component)浏览、再按周期(Cycle)筛选,帮你一步步锁定文件。
二、先看一章真实的"病历卡":文件长什么样
光说概念没用,我们把 DEMO_L(人口学文件)的前几行真实数据调出来,逐列讲解(已做技术脱敏处理,只保留与案例相关的列):
| SEQN | RIAGENDR | RIDAGEYR | RIDRETH3 | DMDEDUC2 | INDFMPIR | RIDEXPRG |
|---|---|---|---|---|---|---|
| 130378 | 1 | 43 | 6 | 5 | 5.00 | — |
| 130379 | 1 | 66 | 3 | 5 | 5.00 | — |
| 130380 | 2 | 44 | 2 | 3 | 1.41 | 2 |
| 130381 | 2 | 5 | 7 | — | 1.53 | — |
| 130382 | 1 | 2 | 3 | — | 3.60 | — |
这一章表里藏着新手自我检查的"读表能力"考试题,逐列看:
- SEQN:档案编号,130378、130379……每人唯一,跨文件合并全靠它。
- RIAGENDR(性别):1=男、2=女。数据里性别总人数 1 男 5,575、女 6,358,比例合理。
- RIDAGEYR(年龄):43、66、5、2……按岁计,覆盖全年龄段——这就是"各年龄都抽"的证据。
- RIDRETH3(种族):这是编码,需要对照 Doc。本文档定义:1=墨西哥裔、2=其他西班牙裔、3=非西班牙裔白人、4=非西班牙裔黑人、6=非西班牙裔亚裔、7=其他/多种族。数据里白人最多(6,217)、亚裔最少(681)。
- DMDEDUC2(教育):前两行是 5(大学及以上)。但注意 130381(5 岁)和 130382(2 岁)这两行是 —(缺失)——因为 DMDEDUC2 只对 20 岁以上成人采集。不是数据丢了,是这个人本就不该有答案。
- INDFMPIR(家庭收入贫困比):5.00、1.41、3.60……这是个比值,"5.00"其实是封顶值(官方编码规则:≥5.00 一律记为 5)。做连续变量时要记得它在上限截断。
- RIDEXPRG(妊娠状态):只有 130380 是 2(未孕),男性和幼儿行是缺失——因为孕期状态只对育龄女性有意义。
看懂上面这段,你就掌握了 NHANES 读表的三条铁律:① 值要用 Doc 对照才懂;② 缺失分"该有而没有"和"本就不该有"两种;③ 数字背后常有暗规则(封顶、截断、只对某类人采集)。 这三条贯穿整个系列,尤其是第 06 篇的合并后清洗环节。
三、变量名的前缀暗号:看到开头就知道出身
NHANES 变量名的前缀直接暴露出身,记住几条规律就能"望文生义":
| 前缀 | 含义 | 举例 |
|---|---|---|
| RID | 人口学访谈变量 | RIDAGEYR 年龄、RIAGENDR 性别 |
| IND | 收入相关 | INDFMPIR 家庭收入贫困比 |
| DMD | 人口学补充 | DMDEDUC2 教育程度 |
| DPQ | 抑郁筛查问卷(PHQ-9) | DPQ010–DPQ090 |
| LBX | 实验室检测值 | LBXVIDMS 血清总维生素 D |
| LBD | 实验室检测的注释/质控码 | LBDVIDLC 检测限标记 |
| WT | 权重 | WTMEC2YR、WTPH2YR |
| SDM | 抽样设计变量 | SDMVSTRA、SDMVPSU |
| BPX / BMX | 体检类(血压 / 体格测量) | BPXSY1 收缩压、BMXBMI 体质指数 |
比如 LBXVIDMS:LBX=实验室检测,VID=Vitamin D,MS=质谱法——不用查也能猜个八九不离十。这套前缀全库通用,是你日后选题检索变量时最实用的导航。
四、SEQN 与"每张表人数不一样":样本漏斗
有了前缀和读表基础,回到最关键的合并逻辑。每个文件的每一行对应一个受访者,由 SEQN 唯一标识。但不同文件包含的人数并不相同——因为"有没有这份数据"取决于受访者是否走到那个环节。
我们用 R 把 2021–2023 三个真实文件逐一数过:
| 文件 | 内容 | 行数 | 为什么 |
|---|---|---|---|
| DEMO_L | 人口学 | 11,933 | 全部受访者 |
| VID_L | 血清维生素 D | 8,727 | 限 1 岁以上且有合格血样者(儿童约 33% 未抽血) |
| DPQ_L | PHQ-9 抑郁量表 | 6,337 | 公开文件仅 18 岁以上(12–17 岁属受限数据,需 RDC 申请) |
做交集,数字一级级收窄(图1,每级都是实机核验的真实数字):11,933 全部 → 18 岁以上成人 8,153 → 成人中有维生素 D 结果 5,824 → PHQ-9 九项完整 5,455 → 三者交集 5,044。
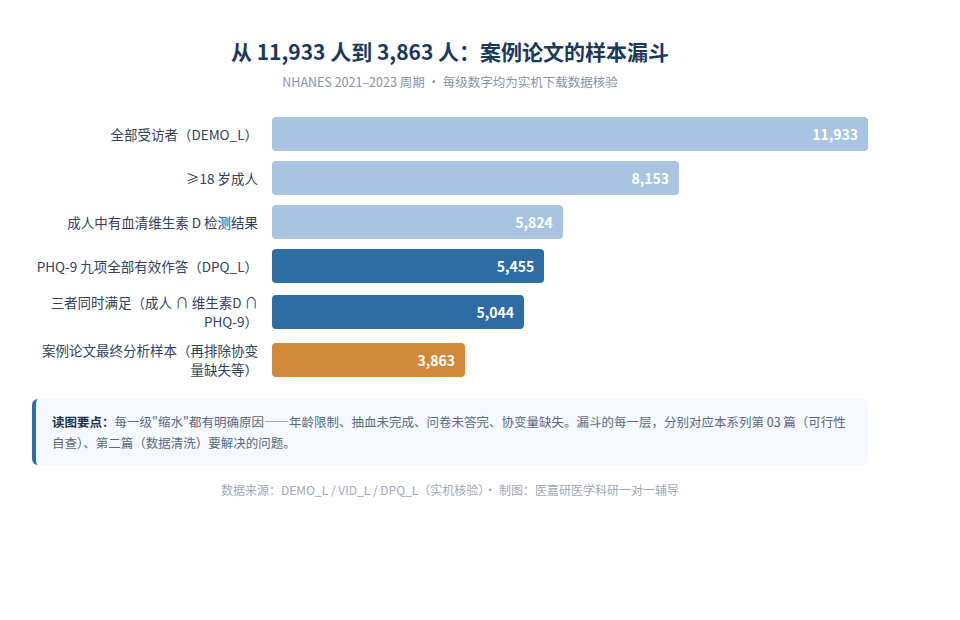
图1:案例论文最终分析样本是 3,863 人,比 5,044 再少一截,因为还要排除协变量缺失等(第 06 篇逐层还原)。记住:在 NHANES 里,"合并后的样本量"永远小于"任何一个单独文件的人数"。
五、文件名的字母暗号:周期命名规则
文件名 = 主题缩写 + 周期后缀。后缀字母从 B 起按周期递增(见图2)。两个特例必须记住:疫情周期用 P_ 前缀(如 P_DEMO,权重规则特殊);最新周期 2021–2023 用 _L(跳过 _K)。下载认准后缀,避免把不同周期张冠李戴。
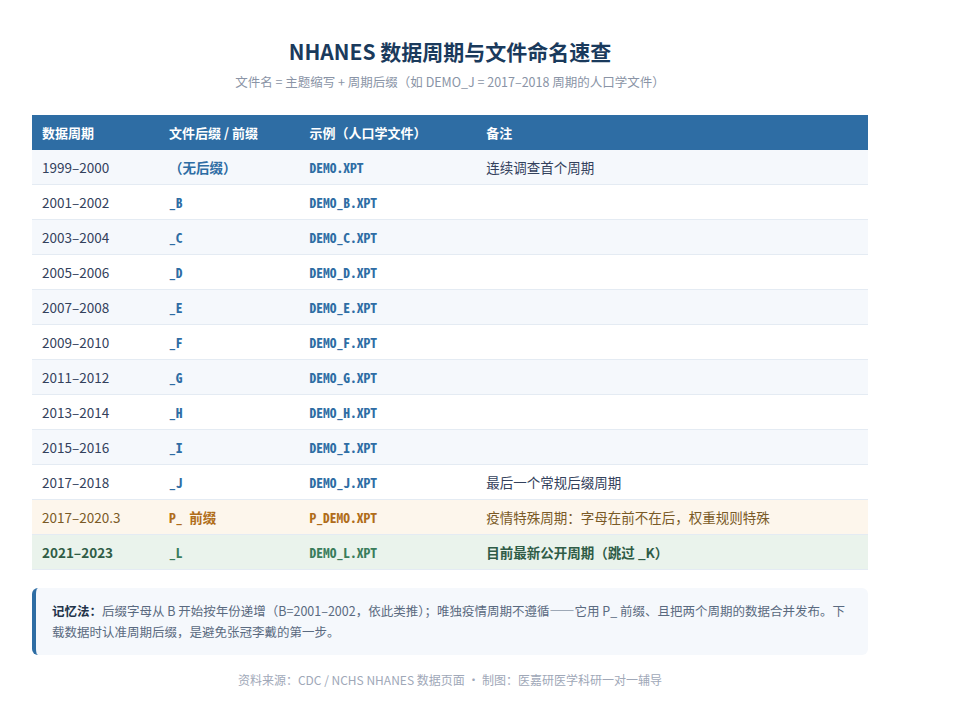
图2:
六、Doc 文档解剖:每个变量的"说明书"
每个数据文件配一个同名 Doc 文档,固定四段:Component Description(用途)→ Eligible Sample(谁有资格进入)→ Analytic Notes(分析注意事项、权重警告)→ Codebook(逐变量编码手册)。
用 VID_L 官方 Doc 我们能查到(全部真实):
- LBXVIDMS 编码手册:SAS 标签"25OHD2+25OHD3 (nmol/L)"、适用人群 1–150 岁、实测范围 7.97–424 nmol/L、7,307 人有值、1,420 缺失;
- 注释变量成对出现:每个 LBX 配一个 LBD 注释码,
LBDVIDLC=1表示低于检测下限,此时检测值填 LLOD/√2 替代值——是否处理这批人,方法里要写清; - 权重警告(Analytic Notes):官方明确写明血液检测存在人群差异无应答,并给出原始引文:"约 67% 的 1–17 岁儿童接受 MEC 检查并经采血提供了血样,而 18 岁以上成人约为 95%"(我们用数据实算为 66.8% 和 95.1%,几乎一致),因此本周期专门提供采血权重 WTPH2YR——凡是分析血液检测变量,官方都推荐使用它。这正是我们维生素 D 分析该用的权重(第 07 篇详解并实际使用)。
新手的通病是只看变量名猜含义、不看 Doc。 再如 DPQ_L 的 Doc:PHQ-9 每题 0–3 分、总分 0–27、官方判读界值;编码 7=拒答、9=不知道——加总前必须剔除,否则垃圾值混入总分。
七、案例论文变量清单(全部实机核验)
| 角色 | 变量名 | 所在文件 | 含义(经 Doc 核验) |
|---|---|---|---|
| 身份标识 | SEQN | 所有文件 | 唯一编号,合并主键 |
| 暴露 | LBXVIDMS | VID_L | 血清总 25-羟维生素 D(nmol/L) |
| 暴露分量 | LBXVD2MS / LBXVD3MS | VID_L | 25-羟维生素 D2 / D3 |
| 结局 | DPQ010–DPQ090 | DPQ_L | PHQ-9 九项 0–3 分,求和 ≥10 判抑郁;剔除编码 7/9 |
| 协变量 | RIDAGEYR / RIAGENDR / RIDRETH3 | DEMO_L | 年龄 / 性别 / 种族 |
| 协变量 | INDFMPIR / DMDEDUC2 | DEMO_L | 家庭收入贫困比(上限 5 截断)/ 教育(20+) |
| 权重 | WTPH2YR | VID_L | 采血权重(官方推荐用于血液分析) |
| 抽样设计 | SDMVSTRA / SDMVPSU | DEMO_L | 分层 / PSU,方差估计用 |
补充登记:论文的最终模型还调整了 BMI、吸烟、饮酒、高血压、糖尿病——分别藏在 BMX_L(BMXBMI)、SMQ_L(SMQ020)、ALQ_L(ALQ121)、BPQ_L(BPQ020)、DIQ_L(DIQ010) 五个文件里(文件均已实测存在)。它们在第 06 篇合并后清洗时正式取用,完整对照见《案例论文复现规格书》。
表格里最后两行,是初学者最容易忽略、却最不能忽略的——它们不是"数据",而是"设计信息":
| 看到这类列 | 它是什么 | 为什么不能当普通变量 |
|---|---|---|
WT 开头(如 WTMEC2YR、WTPH2YR) | 权重:这个人代表多少个没被抽到的美国人 | 把它当普通数值算平均,等于把全国代表性扔掉;它的用法是"交给分析函数",不是"参与运算" |
SDMVPSU、SDMVSTRA | 抽样结构:这个人属于哪个抽样单元(PSU)、哪一层(Strata) | 方差、置信区间、P 值全靠这两列才算得对;忽略它们会系统性低估标准误,把"不确定"算成"很确定" |
打开 DEMO_L 你会看到好几列 WT 开头的变量——它们不是重复,而是对应调查的不同环节(入户访谈 / 体检车 / 采血)。"我这个研究该用哪一个"是每个 NHANES 新手都要过的一关,第 07 篇会用案例论文把这张判断表讲透,并当场用它产出论文的第一张结果表(Table 1)。现在只要建立一个印象:看到 WT 和 SDMV 开头的列,知道它们是设计信息,先别动。
清单就是后续所有实操的"采购单":第 04 篇按它下载,第 05 篇按它读入,第 06 篇按它合并,第 07–09 篇按它做加权分析与结果复现。
【暗线进度条 · 里程碑 M1 ✅】 案例论文已确定 → M1 变量清单已列出,且每个变量都在真实文件和 Doc 中核验(含 Model 3 协变量的五个补充文件登记)→ 下一站 M2 前哨:判断"研究问题能不能用 NHANES 做"(第 03 篇) (对应论文 2.1 数据来源:变量定位)
本篇常见坑
- 以为五类组件=五个文件:实为每组件下几十个文件,先按组件+周期定位再找变量。
- 不看值编码:RIAGENDR 的 1/2、RIDRETH3 的六分类、7/9 拒答码,不查 Doc 必然算错。
- 把"本就不该有"当缺失:教育只采 20 岁以上、孕期状态只对育龄女性——这类"结构性缺失"要区分对待。
- 数值暗规则不知情:INDFMPIR 封顶为 5、检测下限替代值,直接当普通连续变量处理会引入偏倚。
- 以为每张表人数相同 / 下错周期后缀:合并后不可比、对不上人。
下篇预告
第 03 篇:先别急着下载——你的研究问题 NHANES 到底能不能回答?教你用官网检索目标变量、初估样本量、识别受限数据(如 12–17 岁抑郁数据属 RDC 受限),用案例论文变量清单完整走一遍自查。
参考来源
- CDC/NCHS. NHANES 2021–2023 数据页(按组件/周期浏览). https://wwwn.cdc.gov/nchs/nhanes/search/datapage.aspx
- CDC/NCHS. Doc 文档:DEMO_L / DPQ_L / VID_L. 同上数据页
- CDC/NCHS. NHANES Tutorials. https://wwwn.cdc.gov/nchs/nhanes/tutorials/default.aspx
- 案例论文:Front Nutr. 2025;12:1545443. PMID: 40497025. https://pubmed.ncbi.nlm.nih.gov/40497025/
- 本篇所有样本量、变量名、编码、频数均为实机核验(DEMO_L / DPQ_L / VID_L 三文件 + 对应 Doc)