
第 02 篇我们读懂了文件地图,很多人的第一反应就是:冲进官网把数据全部下载。先停一下。 下载之前,还有一道决定成败的工序:先确认"你这个选题到底能不能用 NHANES 做成"。用一句大白话:改选题比改数据容易得多,所以该做的判断要放在动手之前。
这一篇我们用案例论文做完整示范,跑完三层自查(见图1)。
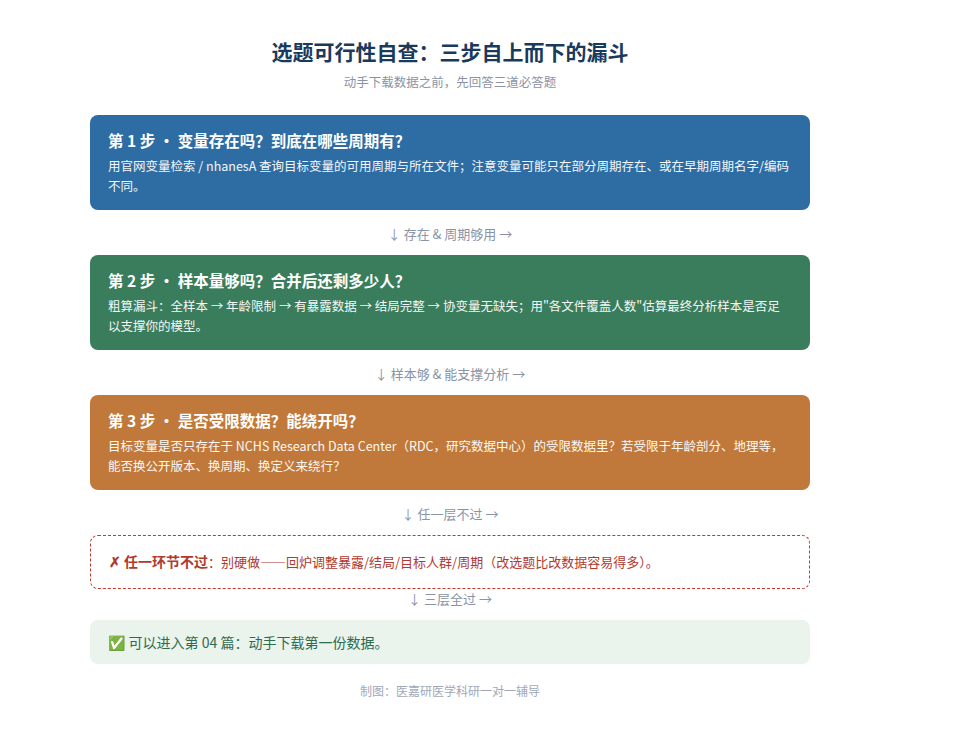
图1:三层递进:变量是否存在 → 样本量够不够 → 是否受限数据。一层不过就回炉调整,别硬做。
目标声明
本篇做完,你将能:① 读懂一篇论文到底要回答什么科学问题(以及它凭什么值得做);② 把一篇 NHANES 论文拆成可执行的清单(六要素 + 六块结果);② 独立判断任意 NHANES 选题的三层可行性;③ 用官网鼠标操作(不开软件也能做)查变量可用周期;④ 用"样本漏斗"粗算分析样本量;⑤ 识别并绕开受限数据。
两类读者都能跟:没装任何软件的纯新手,走"官网鼠标版";已经会 R 的同学,我们用 R 包 nhanesA 再演示一遍更快的自动化做法。两种路径结论一致。
开始前,先把本篇要用到的几个名词一次讲清(新手向术语速查):
| 术语 | 通俗解释 |
|---|---|
| 周期 | 一次连续调查的数据批次,一般以两年为一档(如 2021–2023 周期;疫情特殊周期例外,第 01、02 篇讲过) |
| 变量 | 一张表里的一列,代表一个测量项目(如"年龄") |
| 协变量 | 除暴露和结局外,分析里要纳入控制的其他变量(如年龄、收入) |
| 暴露 / 结局 | "看它会不会导致某结果"的那个因素叫暴露(维生素 D),被影响的那个结果叫结局(抑郁) |
| 患病率 | 有某个特征的人在人群中的比例(本篇指抑郁人群占比) |
| 多周期合并 | 把几个两年周期拼在一起做分析,以增大样本量 |
| 受限数据(RDC) | 因隐私只对有权限的研究者开放、需申请的数据 |
| Doc 文档 | 每个数据文件自带的"使用说明书"(第 02 篇讲过) |
先读 Introduction:这篇论文到底要回答什么问题
读文献的第一个错误姿势是:直接从 Methods 抄变量、从 Results 抄数字,跳过 Introduction。这样你复现得再准,也答不出一个最基本的问题——它为什么要做这个研究?它的发现新在哪里? 而这两点,恰恰决定了一篇论文能不能发表,也决定你该不该拿它当模板。
论文的 Introduction 永远遵循同一套三段式逻辑:① 这个问题重要 → ② 别人已经知道什么、还缺什么(研究空白 gap)→ ③ 所以我要做什么。我们把案例论文的 Introduction 拆给你看:
第一段 · 为什么重要:抑郁是全球重大精神卫生负担,影响数亿人;近年研究关注营养素的作用,维生素 D 因其受体广泛分布于脑区而备受关注(可能与情绪调节、神经炎症、BDNF 等通路相关)。
第二段 · 已有的证据是矛盾的(这是全文最有价值的一段):既往研究结果相互冲突:一部分支持"维生素 D 越高、抑郁风险越低",另一部分却报告"没有关联"。2019–2024 年的多项 meta 分析结论也不一致(在临床抑郁人群中补充维生素 D 有效,在无抑郁的普通人群中效果微弱)。
第三段 · 矛盾的原因 + 研究空白:论文提出的解释是:既往研究大多把维生素 D 当作一个整体来看(总 25(OH)D),把 D2 与 D3 混在一起。而这两种形式在来源(D3 主要来自日照与动物性食物,D2 主要来自植物与强化食品/补充剂)、代谢(25(OH)D2 半衰期明显更短;D3 提升血清 25(OH)D 的效率更高;补充 D2 甚至可能降低 25(OH)D3 水平)与受体激活效力(1,25(OH)₂D3 强于 D2 的对应代谢物)上都有实质差异。把它们合并分析,可能恰好相互抵消,掩盖真实关系。 论文原文的 gap 表述是:大规模人群研究中关于 D2/D3 差异化作用的知识仍很有限,既往研究多聚焦总维生素 D 而忽略异构体差异。
→ 所以这篇论文的研究问题就是:在具有全国代表性的美国成人样本中,血清 D2 与 D3 分别与抑郁患病率有何关联?
这个"三段式"给你三个直接可用的东西:
- 判断一个选题值不值得做:如果"研究空白"说不清(别人早做过了),或"矛盾原因"给不出合理解释,这个选题就危险;
- 读懂你自己的结果该怎么写:论文的结论之所以有分量,不是因为 OR 显著,而是因为它回应了自己在 Introduction 里提出的矛盾(D3 保护、D2 反向——恰好解释了既往"混在一起看"为什么得到矛盾结果);
- 复现时知道"哪一块是核心":这篇论文的核心结果不是总维生素 D 那条(OR 0.991,很弱),而是 D2 与 D3 的方向相反(0.984 vs 1.021)——这才是它区别于既往文献的地方。复现时如果只对上总量那一行,等于没抓住重点。
一句话对照:Introduction 提出"混着看会掩盖差异",Results 就该给出"D2 与 D3 方向相反"——这就是一篇论文的首尾呼应,也是复现时最该验证的地方(我们会在第 08 篇复现 Table 2 时专门核对这一点)。
第 0 步 · 先读懂论文:把一篇 NHANES 论文拆成"六要素 + 六块结果"
做复现也好,自己选题也好,第一步都不是打开软件,而是把论文读成一份清单。NHANES 论文都遵循 IMRaD 结构(Introduction 引言 / Methods 方法 / Results 结果 / Discussion 讨论),其中真正需要你逐字读的是 Methods——它决定了你要下载什么、怎么算;Results 则决定了你最终要产出什么。
从 Methods 抽六要素(这六条就是你的"工程量清单"):
| 要素 | 论文里长什么样 | 抽出来干什么用 |
|---|---|---|
| ① 数据来源与周期 | "data collected from the 2021 to 2023 cycles of NHANES" | 决定下载哪个周期、用哪个周期的文件 |
| ② 研究人群与排除标准 | "adults 18 years and older with comprehensive records of…" | 决定样本漏斗的每一级(第 06 篇逐级复现) |
| ③ 暴露定义 | "serum vitamin D levels… total was defined as the sum of 25OHD3 and 25OHD2" | 决定取哪些变量、要不要做单位换算或相加 |
| ④ 结局定义 | "PHQ-9… score of 10 or above" | 决定九项怎么加总、切点取多少、拒答怎么处理 |
| ⑤ 协变量清单 | 人口学 / 社会经济 / 生活方式 / 健康相关四组 | 决定还要下载哪几个文件 |
| ⑥ 统计方法 | "three logistic regression models… weight adjustments" | 决定用哪个权重、跑几个模型、要不要做亚组 |
从 Results 找六块结果(这就是你复现的终点,也是本系列第 06–10 篇的产出):
| 结果块 | 论文里叫什么 | 复现它的教程篇目 |
|---|---|---|
| 样本流程图 | Figure 1 | 第 06 篇 |
| 基线特征表 | Table 1 | 第 07 篇 |
| 主分析关联表 | Table 2 | 第 08 篇 |
| 剂量反应曲线 | Figure 2、Figure 3 | 第 08 篇 |
| 亚组分析表 | Table 3 | 第 09 篇 |
| 结果解读与局限 | Discussion / Conclusion | 第 10 篇 |
读 Methods 时最该做的一件事:找出论文"没写清"的地方。 规范论文也常有信息缺口。案例论文就有三处:四分位切点怎么算的没说、交互检验用的什么方法没说、统计软件只写了"Empower"(不是 R)。这三处正是复现时最容易卡住、也最容易"想当然填一个值"的地方。遇到未披露口径,正确做法不是猜,而是把两种合理做法都跑一遍、如实报告差异——这套处理方式第 08、10 篇会专门讲,它是复现教学里最接近科研诚信的那一课。
判断可行性,靠的就是这份清单:六要素里任何一个在 NHANES 里找不到对应变量,选题就得调整;六块结果里任何一块你的数据撑不起来(比如结局事件太少),也得回头改设计。下面三步,就是把这份清单逐条落地核实。
第 1 步 · 变量存在吗?在哪几个周期有?
方法:查变量有两种做法——不开软件、用官网鼠标点(新手首选,下面给全步骤),或用 R 包 nhanesA 一行代码(更快、可复现,进阶可选)。两种都能回答"某个变量出现在哪些数据文件/周期"。
官网鼠标版(无需装任何软件):
- 打开 NHANES 官网的 Variable List 页面(参考来源里的链接);
- 在检索框输入变量名,比如
LBXVIDMS,回车; - 搜索结果会逐条列出匹配该变量名的数据文件及其所属周期(例如能查到
LBXVIDMS出现在VID_E、VID_L等文件); - 对你要用的每个变量(暴露、结局、每个协变量)各查一遍,记录下来。
进阶版(一行代码,需装 R 与 nhanesA):对同一条目的查询,写
# 复制进 RStudio 直接运行:查一个变量出现在哪些周期的哪些文件
# 第一次运行先装包(见第 04 篇),之后每次运行只需 library() 加载
library(nhanesA)

# 查维生素 D 变量 LBXVIDMS 在哪些周期可用
nhanesSearchVarName(varname = "LBXVIDMS", ystart = 1999, ystop = 2023)
# 输出: VID_E, VID_F, VID_G, VID_H, VID_I, VID_J, VID_L(2007-08 到 2021-23 各常规周期都有)
运行后返回 VID_E, VID_F, VID_G, VID_H, VID_I, VID_J, VID_L——即从 2007–2008 到 2021–2023 的各常规周期都有。注意结果里没有 P_VID:因为我们实测确认,2017–2020.3 这个疫情特殊周期没有发布维生素 D 检测数据(官网该文件返回 404)。其余变量用同样命令跑一遍,就是下面这张表(实机查询结果)。官网鼠标版查到的是同一批官方数据,两种途径结果可互相印证;只是鼠标版要一个个点,慢一些。
| 变量 | 实测可用的数据文件/周期 | 结论 |
|---|---|---|
| LBXVIDMS 血清总维生素 D | VID_E(2007-08)…VID_L(2021-23) | 2007 年起各常规周期均有(P_ 疫情周期除外),含最新周期 ✅ |
| DPQ010(PHQ-9 首项) | DPQ_D(2005-06)…DPQ_L、P_DPQ | 2005 年起均有 ✅ |
| RIDAGEYR 年龄 | DEMO(1999-00)…DEMO_L、P_DEMO | 全周期都有 ✅ |
| INDFMPIR 收入贫困比 | DEMO(1999-00)…DEMO_L、P_DEMO | 全周期都有 ✅ |
| RIDRETH3 种族(六分类) | DEMO_G(2011-12)起 + P_DEMO 等 | ⚠️ 仅 2011 年起有 |
三个重要发现:
- 案例论文的所有变量在 2021–2023 周期都可用 → 第 1 步通过。
- RIDRETH3 是个"周期陷阱":这个包含独立"非西班牙裔亚裔"类别的六分类种族变量只从 2011–2012(G 周期)开始出现。此前的周期用的是更早期的种族编码方案(如 RIDRETH1,把亚裔并入"其他/多种族"),分类口径不同。所以如果你想把 2011 年之前与之后的周期一起做"多周期合并",种族这个协变量就不能简单地套用 RIDRETH3——合并周期前必查变量可用范围与分类口径,这是最容易踩的暗坑。
- 维生素 D 的检测"口径"随周期可能不同:我们实测比较了 2007–2008(VID_E)与 2017–2018(VID_J)两个周期,同一个变量的值域就有明显差别(VID_E 总 25-羟维生素 D 约 5.4–213 nmol/L,VID_J 约 10–422 nmol/L)。这究竟源于检测方法修订、还是不同周期人群本身的差异,要打开各周期 Doc 的"Laboratory Methodology"段落才能定论——所以跨周期合并暴露变量前,务必逐一核对"检测方法学"与"单位/值域"是否可比,不能想当然地直接把数字拼在一起。
自查清单第 1 步:☑ 变量存在 ☑ 目标周期有 ☑ 跨周期合并时定义可比。
第 2 步 · 样本量够吗?合并后还剩多少人?
变量存在只说明"有数据",还得看"够不够"。用第 02 篇的样本漏斗思想,我们在下载任何数据前就能用各文件的"覆盖人数"估算最终分析样本。对 2021–2023 周期就是这套真实数字:
11,933 全部受访者(DEMO_L)
  → 8,153  ≥18 岁成人(案例限定成人)
  → 5,824  成人中有血清维生素 D 结果
  → 5,455  PHQ-9 九项完整(DPQ_L)
  → 5,044  三者交集(成人 ∩ 维生素D ∩ PHQ-9)
→ 3,863 案例论文最终分析样本(再排协变量缺失等)怎么判断"够不够":没有绝对标尺,但可以对照下面几条:
- 与已发表论文比:案例论文最终用了 3,863 人,说明这个暴露-结局组合在这个周期是可行的;你也想走通类似设计,就至少要有"几千人量级"。
- 够支撑你的模型:经验上,每个纳入模型的参数至少需要 10–20 例结局。这句对新手有点抽象,翻译成大白话就是:你准备放进模型里多少个变量(年龄、性别、种族、收入……),就要准备多少倍的"出现过结局的人数"做储备金——比如模型里放 10 个变量,结局(抑郁)人数最好有 100–200 例以上,否则估计不稳。我们先把结局的真实底数算清楚:在 2021–2023 周期、PHQ-9 完整作答的 ≥18 岁成人里,判定为有抑郁症状(总分 ≥10)的占 13.3%(5455 人中 723 例,未加权口径,实机数据计算)——按 3,863 人分析样本实测有 470 例结局(12.2%),储备金远超几百例的需求,加十几个协变量的 logistic 回归绰绰有余。
- 留意"只有更小人群才有数据"的变量:比如某些实验室检测只在血液亚组、或只对某个年龄段采集,漏斗会收得很狠——粗算前先看各文件 Eligible Sample。
自查清单第 2 步:☑ 合并后估算样本量与已发表同类研究量级相近 ☑ 足够支撑计划模型 ☑ 结局事件数充足。
第 3 步 · 是否受限数据?能绕开吗?
NHANES 里并非所有数据都公开。一部分因隐私原因只放在 RDC(Research Data Center,研究数据中心):研究者需提交申请、审批、甚至前往安全环境分析,门槛和周期都高。
识别受限的两个常见来源:
- 年龄剖分:同一指标,公开文件只给一部分年龄段。我们的 DPQ_L 就是典型——公开文件只有 18 岁以上,而 12–17 岁青少年的抑郁数据只存在于 RDC 受限文件。
- 地理/细小亚组:涉及州、县等地理标识或个人敏感字段的,多为受限。
案例论文需要避坑:它限定 18 岁以上成人,恰好落在 DPQ_L 的公开范围内——不需要碰 RDC,第 3 步通过。
绕行思路(如果目标是受限的):
- 换目标人群:青少年抑郁受限于 RDC → 改为只做≥18 岁。
- 换公开近似变量:受限的往往是细分、敏感或带地理标识的字段,公开版常有更粗或近似的替代。举个真实例子——NHANES 公开数据的年龄在 80 岁封顶(80 岁及以上合并成"80+"一档,我们实测 2021–2023 周期里恰好 525 人落在这一档);如果你需要逐岁的精确年龄,那部分就只能走受限数据,这时可以退一步用"80+合并"的公开字段。
- 换周期:个别周期是公开的、另一些是受限的,查清再选。
- 实在绕不开 ≠ 不能做,而是要把"RDC 申请"排进项目周期,成本高很多,一般入门不推荐先碰。
自查清单第 3 步:☑ 目标变量在公开版可得 ☑ 无需 RDC 申请。
案例论文可行性总核对表
把三层结果整理成一张可复用清单(也是本篇配套资产):
| # | 自查项 | 案例论文结论 |
|---|---|---|
| 1 | 暴露变量可用周期 | LBXVIDMS:VID_E…VID_L(2007 起,P_ 疫情周期除外)✅ |
| 2 | 结局变量可用周期 | DPQ010:DPQ_D…DPQ_L、P_DPQ(2005 起)✅ |
| 3 | 协变量可用周期 | 年龄/收入全周期;种族仅 2011 起 ⚠️ 但不影响 2021–23 ✅ |
| 4 | 目标周期数据齐全 | 2021–2023 五项全在 ✅ |
| 5 | 跨周期定义可比 | 单周期研究,无此问题 ✅ |
| 6 | 分析样本量粗估 | ≥18 成人交集 5,044,论文 3,863 ✅ |
| 7 | 结局事件数 | 抑郁患病率实算 13.3%(≥18 岁完整作答者);按 3,863 人分析样本实测 470 例(12.2%),足够 ✅ |
| 8 | 是否受限数据 | 公开版即可,无需 RDC ✅ |
| 9 | 是否需额外外部数据 | 无(纯 NHANES)✅ |
| 10 | 研究设计可答 | 横断面关联,属 NHANES 能力范围 ✅ |
【暗线进度条 · 前置关卡 ✅】 论文六要素六结果已拆解、变量清单已定位(第 02 篇,M1)→ 三层可行性自查全部通过 → 下一站:装好 R 环境并下载第一份数据(第 04 篇),再用 nhanesA 让机器替你读取(第 05 篇)。可行性核对表已固化进《案例论文复现规格书》第 5 节 (对应论文 2.1 前置:可行性确认)
一点重要的冷静话:本篇让你确认的是"这个选题在数据层面做得成",不等于"做出结果就一定能发表"。三层全过只说明"数据拿得到、人也够、不是受限坑",距离一篇站得住的高质量论文,还差"干净的数据处理、正确的统计方法、站得住的问题设定"这三样,后面几篇就是带你逐个补齐。先把期望摆正,后面才不失望。
想看更多方向? 本篇教你"自己的选题能不能做"。如果你还没想好做什么,或想知道自己的科室/方向在 NHANES 里有哪些数据可用,见本篇配套附录《NHANES 能做哪些研究?——按科室/方向速查》:内分泌、心血管、肾脏、消化、精神心理、呼吸、口腔、妇儿、公共卫生等十几个方向,每个方向都标了用哪些文件、怎么做(全部以官方文件清单实测核对)。
本篇常见坑
- 不查变量可用周期直接合并多周期:明明某个变量只从某一年开始,硬合并导致大片缺失(RIDRETH3 就是现成例子)。
- 不管 RDC 就设计青少年/地理级选题:数据其实拿不到,白忙一场。
- 不看文件 Eligible Sample 就估样本量:以为"整库几万人",其实某个关键变量的文件只覆盖一部分人。
- 结局太罕见还不粗算事件数:logistic 回归里结局只有几十例,置信区间宽到没法谈意义。
下篇预告
第 04 篇:装好环境、把数据下载到手。开头 10 分钟速装 R 与必备包(附常见报错速查),接着手把手走官网下载八个文件与配套 Doc、下载后必验的三件事,以及很多人不知道的死亡率数据(NDI Linked Mortality)专门入口;第 05 篇:用 nhanesA 一条命令把同样的数据读进 R,并讲清工具失效时怎么兜底、「手动 vs 自动」该怎么选。
参考来源
- CDC/NCHS. NHANES Variable List(官网变量检索). https://wwwn.cdc.gov/nchs/nhanes/search/variablelist.aspx
- nhanesA R 包文档. https://cran.r-project.org/web/packages/nhanesA/
- CDC/NCHS. Restricted Data (RDC). https://www.cdc.gov/rdc/
- 案例论文:Front Nutr. 2025;12:1545443. PMID: 40497025.
- 本篇"变量可用周期"由 nhanesA 实机查询得出(nhanesSearchVarName,1999–2023)