
前三篇我们把"这个选题能不能做"确认完毕(第 03 篇),现在终于动手。数据获取有两条路:手动下载(这一篇)和代码自动获取(下一篇)。两条都要会:手动那遍让你理解"数据从哪来、长什么样",而且工具失灵时它是唯一的退路。
本篇的目标:10 分钟装好分析环境,然后把案例论文需要的八个数据文件全部下载并校验通过。
开篇 10 分钟:装好 R 与必备包
先回答一个常见问题:数据下来之后用 Excel 打开不行吗?不行——.XPT 是给统计软件读的格式,Excel 打不开;而且后面要做的加权分析,Excel 也干不了。所以要装统计工具。
要装两样免费软件:R(真正干活的引擎)和 RStudio(让你舒服地使用引擎的驾驶舱)。必须先装 R、后装 RStudio——驾驶舱要找到发动机才能点火,顺序反了 RStudio 打不开就会报错。
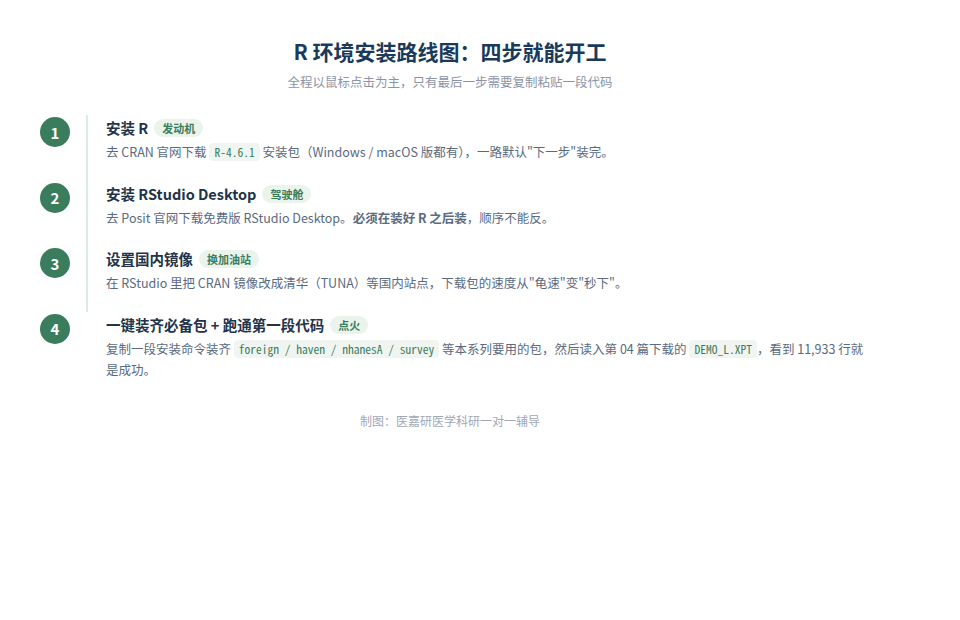
图1:四步:装 R → 装 RStudio → 换国内镜像 → 装包并跑通第一段代码。
第 1 步 · 装 R(发动机):打开 CRAN 官网(地址见参考来源[1]),按自己的系统点 Download R for Windows 或 macOS;Windows 用户进 base 后点最上方链接下载安装包(2026 年 9 月实测当前版本 R-4.6.1);双击一路默认"下一步",不建议改安装路径(中文路径个别情况会引发问题)。macOS 下载 .pkg 双击安装;若提示"无法验证开发者",右键安装包选"打开"放行。
第 2 步 · 装 RStudio Desktop(驾驶舱):打开 Posit 官网下载页(参考来源[2]),下载系统对应的 RStudio Desktop 免费版,同样一路默认安装。装完打开,左下角能看到带 > 的输入区,那叫 Console(控制台),> 就是"我准备好了,请下指令"的提示符。
第 3 步 · 换国内镜像(把"龟速"变"秒下"):R 装包默认走国外主站,国内常慢到超时。鼠标版:RStudio 菜单 Tools → Global Options → Packages → Change → 选 China → Tsinghua (TUNA) → OK。代码版:
# 复制进 RStudio 直接运行:换国内镜像
options(repos = c(CRAN = "https://mirrors.tuna.tsinghua.edu.cn/CRAN/"))
第 4 步 · 一键装齐必备包:
install.packages(c("foreign",   # 读下载的 .XPT 数据文件(本篇第二节用)
                   "haven",     # 读数据文件的另一种更现代的方式
                   "nhanesA",   # NHANES 专用工具:搜索/下载/读入一条龙(本篇第五节)
                   "survey",    # 复杂抽样加权分析(第 07–09 篇的主角)
                   "dplyr",     # 数据清洗与处理(第 06 篇起用)
                   "ggplot2"))  # 画图
整段粘进 Console 回车,屏幕会滚动大量红字——只要最后没有 non-zero exit status 之类报错,就是在正常干活(首次约 5–15 分钟)。装完自检:
# 复制进 RStudio 直接运行:检查六个包是否都装上了
installed.packages()[c("foreign","haven","nhanesA","survey","dplyr","ggplot2"), "Version"]
能打印出六个版本号,环境就绪。热身一句:
# 复制进 RStudio 直接运行:环境热身(最短代码)
cat("Hello NHANES! 我的 R 环境已经就绪\n")常见报错速查(完整版见配套资产 常见报错速查表.csv):
| 报错/症状 | 原因 | 解法 |
|---|---|---|
there is no package called 'xxx' | 包没装成功或拼错 | 重跑第 4 步;检查拼写 |
install.packages 卡住 / cannot open URL | 国外源太慢 | 按第 3 步换清华镜像 |
read.xport 报 cannot open the connection | 工作目录不对 | 菜单 Session → Set Working Directory → Choose Directory,选中数据所在文件夹 |
| macOS 装完打不开 | 系统安全拦截 | 右键 → 打开;或系统设置放行 |
| 装包提示需要更新的 R | R 版本过老 | 回第 1 步装最新版 |
【暗线进度条 · 环境就绪 ✅】 R 与必备包已装好、第一段代码跑通 → 下一站:把案例论文的八个数据文件下载到手(本篇第二节) (工具准备,对应全部实操环节的前置)
一、官网手动下载:保姆级路径
动手前先立个规矩:NHANES 数据虽免费公开,但受联邦保密法保护,官方《数据使用协议》(Data User Agreement,参考来源[2])写明四条核心义务——只能用于统计分析与报告;不得试图识别任何个人或机构;不得把数据与其他可识别身份数据做链接;不得研究"如何再识别"的方法。协议原文写明,故意泄露可识别信息属 E 级重罪,最高可判 5 年监禁或 25 万美元罚款。发布论文前通读一遍,是数据使用者的基本素养。
第 1 步 · 进入数据检索页。 打开 NHANES 的 Data 页面(参考来源[1]),会看到按组件分类的入口:Demographics / Questionnaire / Examination / Laboratory / Dietary,进入后可再按周期(Cycle)筛选。
第 2 步 · 定位文件。 以案例论文为例:选 Laboratory 组件 + August 2021–August 2023 周期,进入后就是文件列表页(图3)。每一行是一个数据文件,列头为 Data File Name / Doc File / Data File / Date Published。
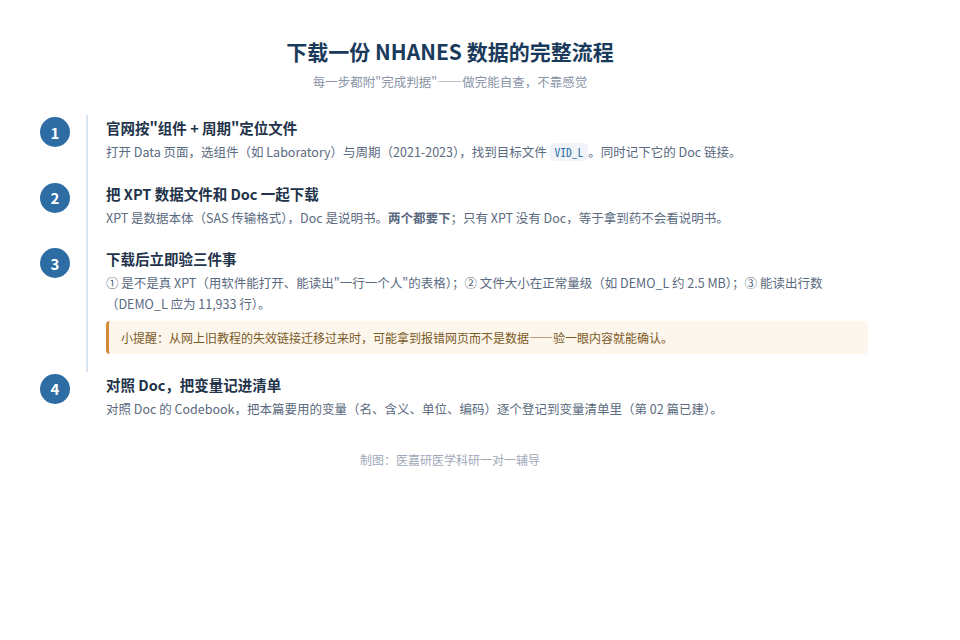
图2:四步流程,每步附"完成判据"。
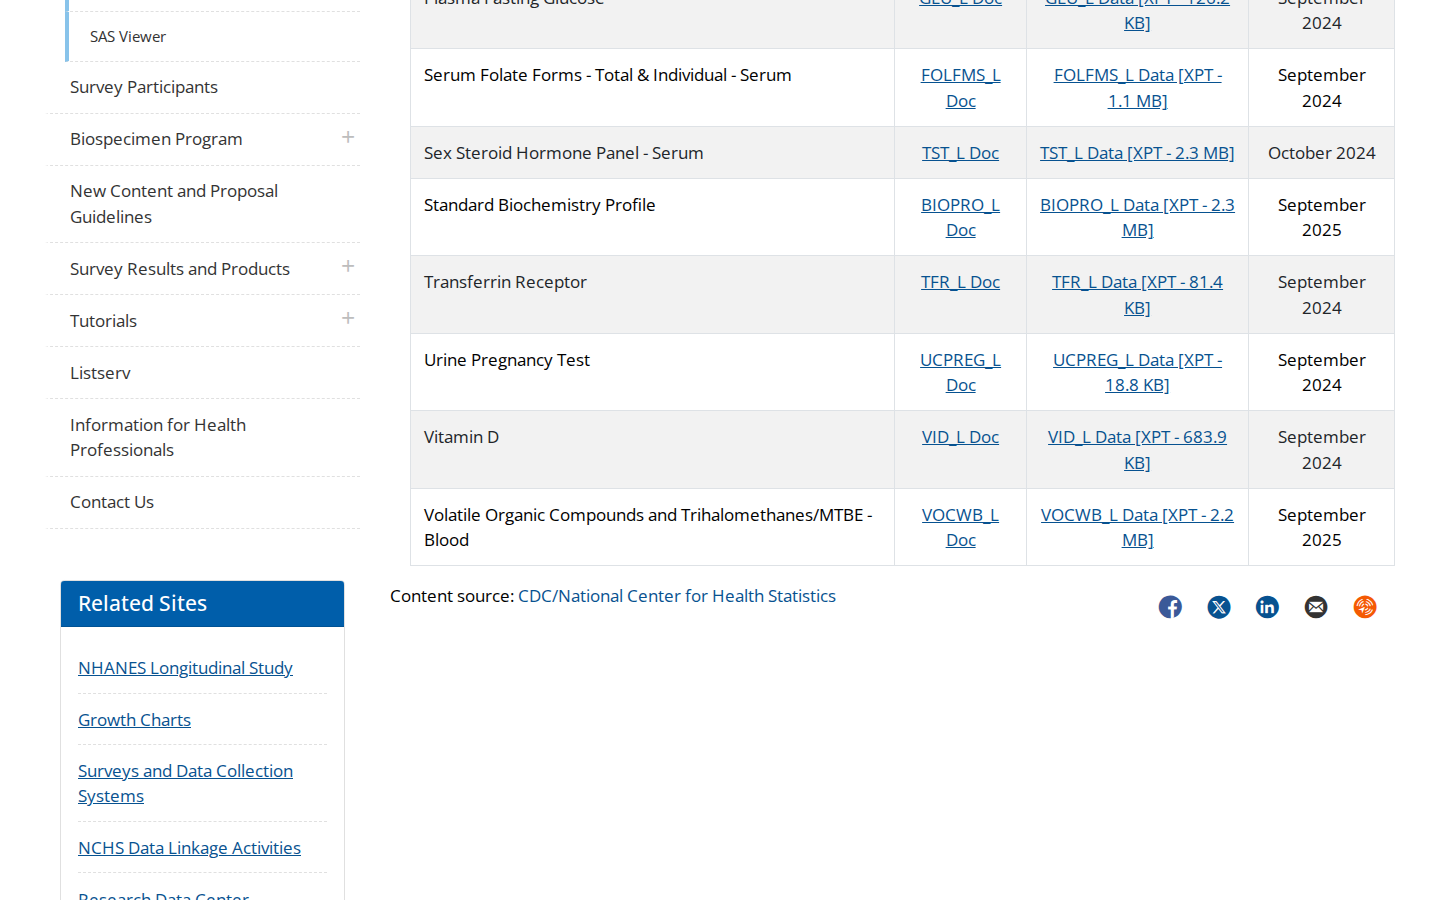
图3:官网真实页面:左侧是站点导航,中间表格每行一个数据文件,Doc File / Data File 两列各带下载链接和文件大小标注。找到 Vitamin D 行(VID_L)——注意 Data 列写着 XPT - 683.9 KB,这就是官方标注的数据文件大小。

图4:VID_L 行四要素:文件主题(Vitamin D)、PDF 版说明书(Doc)、数据文件(Data,标注 683.9 KB)、发布日期(September 2024)。
第 3 步 · 两个都下载。 很多人只下 XPT 不下 Doc——等于拿到药不看说明书。Doc 有 PDF 版(官网行内直接给)和网页版(把数据网址的 .XPT 换成 .htm 即得,内容一致),任选其一。XPT 是统计分析软件 SAS 用来"搬数据"的通用格式,你可以把它理解成数据界的 PDF:R、Python、SPSS 都能直接打开读,不用装 SAS。
小习惯建议:新建一个文件夹(如 NHANES_2021-2023),把本次下载的 XPT 和 Doc 都放进去。后面合并数据(第 06 篇)时,文件散落在"下载"文件夹里会找得很痛苦。
当前数据文件的真实地址规律(2026 年 9 月实测有效),把网址拆成四段看就懂了:
| 网址分段 | 这段是什么 |
|---|---|
https://wwwn.cdc.gov | CDC 官网的服务器地址 |
/Nchs/Data/Nhanes/Public/ | NCHS 官方公开数据的存放路径(固定不变) |
2021/ | 周期的起始年份(2021–2023 周期就放在 2021 目录下) |
DataFiles/DEMO_L.XPT | 固定目录 + 文件名 |
完整拼起来就是:
https://wwwn.cdc.gov/Nchs/Data/Nhanes/Public/2021/DataFiles/DEMO_L.XPT注意那段 2021 不是文件发布年份——VID_L 的 Doc 明确写着首发于 2024 年 9 月,却放在 2021 目录里。把最后的 DEMO_L.XPT 换成任意文件名(如 VID_L.XPT、DPQ_L.XPT),就能直接批量下载;把 .XPT 换成 .htm 得到对应 Doc 说明书。
顺带说明:网上流传的老教程里还能见到一种旧地址格式:
https://wwwn.cdc.gov/Nchs/Nhanes/2021-2023/DEMO_L.XPT ← 旧路径,已失效这个路径已经不提供数据了,照抄会拿不到文件。跟着本篇的官网路径走就不会遇到;万一从旧代码迁移过来,换成本节开头的新版地址即可。
二、下载后验三件事(每件都有完成判据)
还不会用 R?有一个零软件校验法:用记事本(Windows 自带)直接打开下载的 .XPT 文件——真数据第一行应该是 HEADER RECORD 开头的一串字符(这是 XPT 格式的固定"文件头",实测 DEMO_L.XPT 就是如此);如果看到的是网页代码(<!DOCTYPE html> 开头),说明拿到的不是数据。看完关掉别保存即可,不会损坏文件。
会 R 的同学用代码校验更完整:
# 复制进 RStudio 直接运行:校验下载的 DEMO_L.XPT 是不是真数据
library(foreign)                      # 读 XPT 的包
demo <- read.xport("DEMO_L.XPT")      # 读入(路径按你下载的位置改;demo 是我们给数据起的名字)
nrow(demo)                            # 数一数多少行,应为 11933
names(demo) # 看有哪些列,前几列应为 SEQN, SDDSRVYR, RIDSTATR, RIAGENDR ...校验清单(三个动作全过才算下载成功):
- 验格式:能被软件读开、读出来是"一行一个人"的表格,而不是网页文本;
- 验大小:实测 2021–2023 周期三个文件:DEMO_L 约 2.5 MB、VID_L 约 0.7 MB、DPQ_L 约 0.56 MB。只有几十 KB 的"数据文件",基本可以断定不是数据;
- 验行数:行数应与官方 Doc 频数表的总人数一致——实测 DEMO_L = 11,933 行、VID_L = 8,727 行、DPQ_L = 6,337 行(与第 02、03 篇的数字完全咬合)。
三关全过,这份文件才算真正到手。这个习惯要保留到自动化下载:nhanes() 读进来的数据同样要验行数。
三、很多人不知道的数据金矿:死亡率链接文件(NDI)
NHANES 只回答"你现在健康吗",还有一类研究要问"后来的结局如何"——比如"基线抑郁的人十年内死亡风险高多少?"。这需要把 NHANES 受访者与国家死亡索引(NDI,National Death Index)做链接:链接之后,每个人后来"什么时候去世、死因是什么"就补上了——相当于给横断面调查补上了每个人的结局信息。
专门入口(2026 年 9 月实测有效):
- 项目主页:NCHS 的 National Death Index 链接数据页(参考来源[3]),有方法学说明与引用要求;
- 公共版数据文件:放在 NCHS 的 FTP 上——FTP 可以理解成 CDC 官方的一个"公开网盘",浏览器打开就能看到文件目录、逐个点击下载:
https://ftp.cdc.gov/pub/Health_Statistics/NCHS/datalinkage/linked_mortality/; - 官方还提供 R / SAS / Stata 三种读取程序(就在 FTP 目录里,如
R_ReadInProgramAllSurveys.R)。
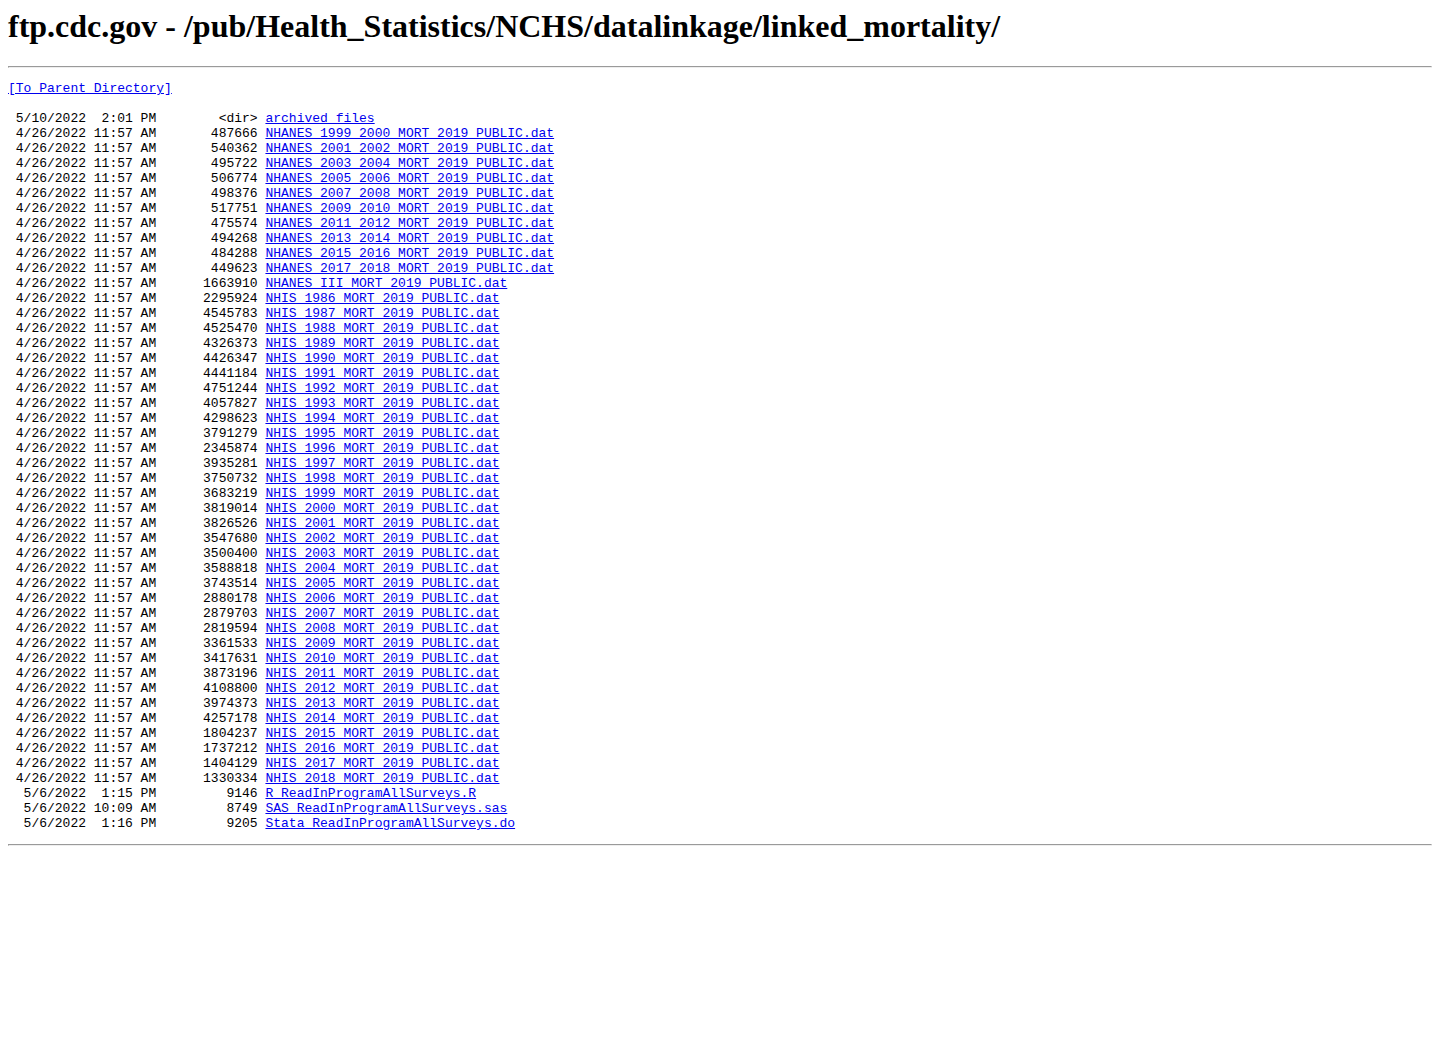
图5:FTP 目录的真实长相:每个周期一个 .dat 文件,文件名里含周期年份和随访截止年份(MORT_2019),日期和字节大小都摆在文件名后面;目录底部就是官方提供的 R / SAS / Stata 读取程序。
实测这个目录里长什么样(2026 年 9 月):
- 文件名规律:
NHANES_1999_2000_MORT_2019_PUBLIC.dat——前段是 NHANES 周期,2019表示死亡信息追踪到 2019 年 12 月 31 日(随访=调查结束后继续追踪记录),PUBLIC表示公共版; - 公共版覆盖范围:NHANES 1999–2018 的每个周期 + NHANES III,每周期一个文件;
- 格式:.dat 固定宽度文本(不是 Excel 也不是 CSV),列结构要靠官方读取程序解析——自己瞎猜列宽必错;
- 一个大坑,官方页面明说了:公共版为保护隐私,对部分记录的随访时间和死因做了"合成值"替换(是否存活这个状态本身不变)——做敏感性分析或引用官方受限版结果时要记得这一点;
- 两个版本的边界:官方最新整体追踪已做到 2022 年 12 月 31 日,但那一批目前只提供受限版(含 2017–2020.3 疫情周期);公共版停留在 2019 版链接,只覆盖 NHANES 1999–2018 + NHANES III。准确说法是"公共版暂无最新周期",而不是"永远没有"。
回到案例论文:它研究"维生素 D 与抑郁的关联"(横断面),不需要死亡率数据。但你的下一个选题很可能用到它,所以先把这个金矿的位置记下。
案例论文数据文件清单(配套资产)
按第 02 篇的变量清单,把案例论文需要的文件全部下载并校验完毕:
| 文件 | 内容 | 实测大小 | 实测行数 | 用到什么 |
|---|---|---|---|---|
| DEMO_L.XPT | 人口学 | 约 2.5 MB | 11,933 | 年龄/性别/种族/收入/教育 + 权重 |
| VID_L.XPT | 维生素 D | 约 0.7 MB | 8,727 | 暴露变量 + 采血权重 |
| DPQ_L.XPT | PHQ-9 | 约 0.56 MB | 6,337 | 结局变量 |
| BMX_L.XPT | 体格测量 | 约 1.6 MB | 8,860 | Model3 协变量 BMI |
| SMQ_L.XPT | 吸烟问卷 | 约 0.65 MB | 9,015 | Model3 协变量 吸烟 |
| ALQ_L.XPT | 饮酒问卷 | 约 0.46 MB | 6,337 | Model3 协变量 饮酒频率 |
| BPQ_L.XPT | 血压相关问卷 | 约 0.41 MB | 8,501 | Model3 协变量 高血压 |
| DIQ_L.XPT | 糖尿病问卷 | 约 0.85 MB | 11,744 | Model3 协变量 糖尿病 |
八份文件 + 对应 Doc 全部到手且校验通过。后五份是 Model 3 协变量文件,论文 Model 3 调整的 BMI/吸烟/饮酒/高血压/糖尿病都在里面,第 06 篇合并清洗时会用到。清单已整理为 CSV(配套资产),下载时照着打勾即可。
【暗线进度条 · 里程碑 M2 ✅】 环境就绪 → 案例论文全部八个数据文件(3 个核心 + 5 个协变量)已下载并通过校验,自动化读取也已掌握 → 下一站 M3:按 SEQN 合并成一份分析数据集,并逐级复现论文的样本漏斗(第 06 篇) (对应论文 2.1:数据获取)
本篇对应的复现脚本段落(完整代码)
总脚本开头那几行(第 0 步)就是下面这段,一字未改。第 1 步(下载八个文件)在第 05 篇。
##### 第 0 步:第一次使用——先安装工具包(只需装一次)########################
#
# 如果你是第一次用 R:先把下面 4 行前面的 # 删掉,整段复制到 RStudio 的 Console
# 按回车运行。装过一次以后就不用再装(下次直接跳过这段,从 library() 开始)。
#
# options(repos = c(CRAN = "https://mirrors.tuna.tsinghua.edu.cn/CRAN/"))  # 国内镜像,下载快
# install.packages(c("nhanesA", "survey", "ggplot2"))   # 安装本脚本要用的三个包
#   # nhanesA:下载和读取 NHANES 数据;survey:复杂抽样的加权分析;ggplot2:画图
#
# 装完检查:能打印出版本号就说明装好了
# packageVersion("nhanesA"); packageVersion("survey")

# 每次运行脚本都要先加载这两个包(library = 把装好的工具拿出来用):
library(nhanesA)
library(survey)

# ★ 关键设置(2026-09-10 核对报告 4.2 节的教训):小样本亚组(如墨西哥裔 N=228、
#   NH 黑人 N=389)的某些抽样层里只有 1 个 PSU(初级抽样单元),survey 包默认
#   直接报错终止——不加这行,第 8 步的这两个亚组会被 tryCatch"静默吞掉",
#   结果表里少两行且没有任何提示。adjust 是对孤独 PSU 做保守调整后继续拟合。
options(survey.lonely.psu = "adjust")

# 说明:本脚本用 nhanes() 直接在线下载数据,需要联网;如果你已手动下载过八个
# .XPT 文件,也可以改用 read.xport() 读本地文件(本篇第一节讲过两种方式)。
## 本篇常见坑

1. **只下 XPT 不下 Doc**:变量编码、单位、缺失值规则全在 Doc 里,没有它后面寸步难行。
2. **不校验行数**:文件缺了一半都不知道,分析结论随之报废。
3. **把 .dat 当 CSV 打开**:死亡率文件是固定宽度格式,乱猜列宽会把数据读成天书,用官方读取程序。
4. **在公共版 FTP 里找疫情周期**:公共版死亡率数据只覆盖 1999–2018,疫情周期目前只在受限版里。
5. **先装 RStudio 后装 R**:驾驶舱找不到发动机,打不开——按"先 R 后 RStudio"重装。
6. **装包看满屏红字就慌**:红字多数是下载进度,只有明确的 `Error` / `non-zero exit status` 才是失败。
7. **只在 Console 里敲命令不保存**:本篇命令请存进 .R 脚本文件(File → New File → R Script),下篇直接复用。

## 下篇预告

**第 05 篇**:让机器替你干活——用 `nhanesA` 包一条命令把同样的数据读进 R:四个核心能力(下载读入、查编码、翻译编码、跨周期检索)、哪些功能已在官网改版后失效、工具坏了怎么兜底,以及"手动 vs 自动"到底怎么选。

## 参考来源

1. CDC/NCHS. NHANES 数据检索页. https://wwwn.cdc.gov/nchs/nhanes/search/datapage.aspx
2. CDC/NCHS. Data User Agreement(数据使用协议). https://www.cdc.gov/nchs/policy/data-user-agreement.html
3. CDC/NCHS. National Death Index 链接数据页. https://www.cdc.gov/nchs/linked-data/mortality-files/
4. CDC/NCHS. 公共版死亡率数据 FTP. https://ftp.cdc.gov/pub/Health_Statistics/NCHS/datalinkage/linked_mortality/
5. CRAN(R 官方发行站). https://cran.r-project.org/
6. Posit:RStudio Desktop 下载页. https://posit.co/download/rstudio-desktop/
7. 清华大学 TUNA 镜像(CRAN). https://mirrors.tuna.tsinghua.edu.cn/CRAN/
8. 本篇所有下载路径、文件大小、行数、FTP 目录内容、协议条款均为 2026 年 9 月实机核验;R 当前最新版 4.6.1(CRAN,2026-09),本系列代码实测通过于 R 4.5.2