
上一篇我们手动下载了八个文件,你大概已经体会到:每次都要打开网页、找到链接、点下载、再校验——一个周期三五个文件还行,要是做多周期合并,动辄十几个文件,手点就太笨了。
这一篇介绍 NHANES 圈最常用的 R 工具包 nhanesA:搜索变量、下载文件、查说明书,都能一条命令搞定。但它还有一个更重要的隐藏任务:诚实地告诉你,这个工具箱里哪些功能已经坏了——以及坏了怎么办。
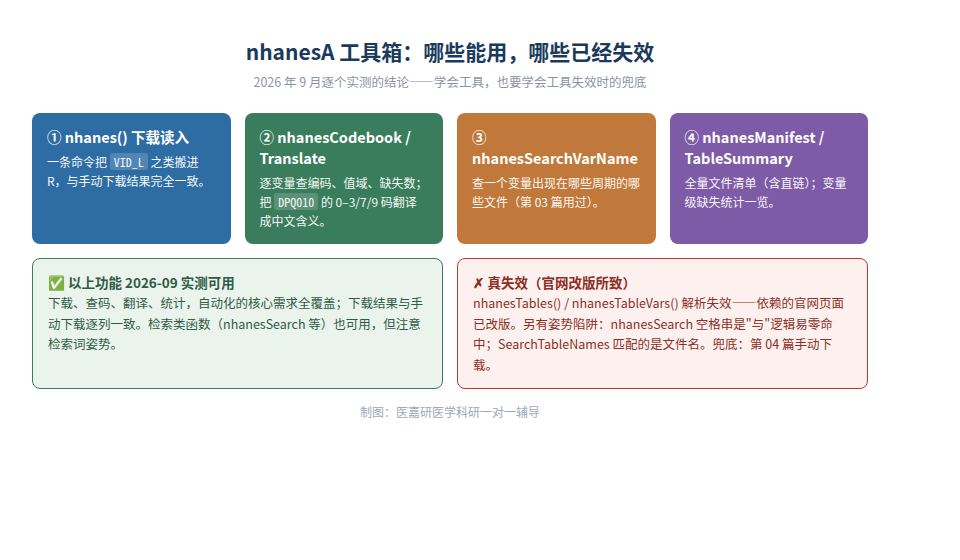
图1:上半部分是实测可用的四类功能,下半部分是两个已失效功能与兜底方案。
一、能力① nhanes():一条命令下载并读入
这是使用频率最高的函数,一句话完成"下载 + 读入":
# 复制进 RStudio 直接运行:一条命令下载并读入 VID_L
library(nhanesA)           # 先加载包(第 04 篇装过)
vid <- nhanes("VID_L")     # 自动拼地址、下载、读入,一步到位
dim(vid) # 8727 10 —— 与第 04 篇手动下载完全一致成功判据:dim() 返回 8727 10(8,727 行、10 列),与上一篇手动下载并校验过的文件逐列一致(我们实测对比过 identical() 判定相同)。
它默默替你做对了三件事:拼对新版地址(上一篇讲过的 /Public/周期起始年/ 规律)、按官方格式解析 XPT、把数据存成 R 的数据框。上一篇你理解了"文件从哪来",这一篇只是把重复劳动交给机器。
两个常用开关(实测有效):
nhanes("VID_L", includelabels = TRUE)——给每个变量附上官方标签(如 LBXVIDMS 的标签是 "25OHD2+25OHD3 (nmol/L)"),列一多也不怕认错;nhanes("DPQ_L", translated = FALSE)——关闭自动翻译。nhanes() 默认会把问卷编码翻译成文字(DPQ010 变成 "Not at all" 等),做总分计算前还得映射回数字;加这个参数直接拿到底层数字编码(实测同一人显示Not at allvs0)。第 06 篇合并清洗时会再次用到这个开关,总脚本里也是这么写的。
同一份数据用 nhanes() 读进来,也可以用来快速验证手动下载的结果:
demo <- nhanes("DEMO_L") # 应得到 11933 行、27 列二、能力② nhanesCodebook() / nhanesTranslate():把 Doc 搬进 R
第 02 篇反复强调"要看 Doc",nhanesA 把 Doc 也搬进了 R:
# 查变量编码(直接打印会先看到 5 段元信息,编码表在最后一个元素里)
cb <- nhanesCodebook("VID_L", "LBXVIDMS")
cb$LBXVIDMS
实测输出(直接告诉你值域、有效数、缺失数):
  Code or Value   Value Description  Count  Cumulative
1  7.97 to 424   Range of Values   7307        7307
2  .             Missing           1420        8727
——8,727 人中 7,307 人有维生素 D 结果、1,420 人缺失,与第 02/03 篇数字完全咬合。再看结局变量的编码翻译:
nhanesTranslate("DPQ_L", "DPQ010")实测把 PHQ-9 首题编码逐条翻译:0=Not at all、1=Several days、2=More than half the days、3=Nearly every day、7=Refused、9=Don't know——7 和 9 必须剔除这条规则,第 02 篇讲的坑在这里得到了工具层面的支撑。
三、能力③④:变量跨周期检索与文件清单
nhanesSearchVarName("LBXVIDMS", ystart = 1999, ystop = 2023)
# 返回 VID_E, VID_F, VID_G, VID_H, VID_I, VID_J, VID_L
第 03 篇可行性自查用的就是它。另外两个顺手的工具:
nhanesManifest()拿到全部公开文件清单(实测 1,601 个文件),含 Doc 网址、数据网址、所属周期、发布日期——想做"批量下载某周期全部文件"的进阶操作,清单就在这里;nhanesTableSummary("VID_L")一张表列出每个变量的总观测数与缺失数(列名nobs_data/na_data,有效数 = 两者相减;实测 LBXVIDMS 为 8,727 观测 / 1,420 缺失),清洗前先看一眼,心里就有数。
四、工具会"坏":哪些功能已失效、怎么兜底
nhanesA 的工作原理是模拟人去访问 CDC 官网:你发一条命令,它替你打开对应网页、把表格解析出来。所以 CDC 官网一改版,nhanesA 的部分功能就会失灵——不是你装错了,也不是 R 出问题了。这恰恰说明:工具是加速器,不是命脉——本篇第一节教的手动下载,就是你永远兜底的底气。
实测(nhanesA 1.4.1,2026 年 9 月)真正失效的是两个解析类函数:
| 函数 | 实测状态 | 你的兜底方案 |
|---|---|---|
nhanesTables() 列某组件某周期的全部文件 | 返回 "No tables found" | 官网文件列表页(图3 那张截图的页面),或 nhanesManifest() 按周期筛(Years 列,如筛出 2021–2023 的 79 个文件;清单无"组件"列,组件需按文件名前缀判断) |
nhanesTableVars() 列某文件的全部变量 | 报错 "Table not present" | 读 Doc 网页版(.htm),或 nhanesCodebook() 逐个查 |
另有两个函数不是坏了,而是使用姿势有讲究——这是工具使用中最容易冤枉它的地方:
| 函数 | 实测行为 | 真相与正确用法 |
|---|---|---|
nhanesSearch("vitamin d", ...) | 返回 "No matches found" | 不是坏了。空格分隔的多词是"与"逻辑;实测单词 "vitamin" 返回 17 行(含 LBXVIDMS),向量 c("vitamin","d") 是"或"逻辑返回 998 行。官方描述里维生素 D 写作 "25OHD2+25OHD3",没有独立单词 "d",所以 AND 检索零命中是真实结果。用单词或向量,别用空格串 |
nhanesSearchTableNames("vitamin") | 返回 NULL | 也不是坏了。它匹配的是数据文件名(如 VID_L、DPQ_L),不是主题词。实测 nhanesSearchTableNames("VID") 能正确返回 VID_B…VID_L 全系文件 |
判别"工具坏了"的方法:先换个检索词、换种参数再试一次;如果换姿势还是空,而 nhanes() 下载正常——那多半是官网改版导致解析失效,换官网手动路径即可,数据本身永远在官网端。
五、手动 vs 自动:怎么选?
- 入门期(现在):优先手动下载走一遍,理解地址规律与文件构成;
- 日常分析:用
nhanes()自动下载,nhanesCodebook()/nhanesTranslate()查编码,效率优先; - 工具失灵时:回到官网手动路径,你永远有兜底。
两条路都走过的分析者,才不会被任何一次官网改版困住。
本篇对应的复现脚本段落(完整代码)
总脚本第 1 步就是这段代码,可以直接对照。
第 1 步:下载并读入八个文件(论文 2.1:数据来源)########################
cycle_suffix <- "L" # L = 2021–2023 周期 cycle_years <- "2021–2023" # 论文用的就是这个周期 cat("本次下载的数据周期:", cycle_years, "(后缀 _", cycle_suffix, ")\n")
demo <- nhanes(paste0("DEMO_", cycle_suffix), translated = FALSE) # 人口学:年龄/性别/种族/收入/教育/权重 vid <- nhanes(paste0("VID_", cycle_suffix), translated = FALSE) # 实验室:血清维生素 D dpq <- nhanes(paste0("DPQ_", cycle_suffix), translated = FALSE) # 问卷:PHQ-9 抑郁量表 bmx <- nhanes(paste0("BMX_", cycle_suffix), translated = FALSE) # 体检:BMI smq <- nhanes(paste0("SMQ_", cycle_suffix), translated = FALSE) # 问卷:吸烟 alq <- nhanes(paste0("ALQ_", cycle_suffix), translated = FALSE) # 问卷:饮酒频率 bpq <- nhanes(paste0("BPQ_", cycle_suffix), translated = FALSE) # 问卷:高血压史 diq <- nhanes(paste0("DIQ_", cycle_suffix), translated = FALSE) # 问卷:糖尿病史
cat("下载自查:", nrow(demo), nrow(vid), nrow(dpq), nrow(bmx), nrow(smq), nrow(alq), nrow(bpq), nrow(diq), "\n")
## 本篇常见坑

1. **工具报错就怀疑自己装错了**:先分辨"报错"还是"返回空"——前者查代码,后者先换姿势重试(如换检索词),再查官网是否改版。
2. **`nhanes()` 下载的文件不做校验**:自动下载也要验行数(如 VID_L 应为 8,727 行),习惯与手动下载一致。
3. **把 `nhanesSearch()` 零命中当"变量不存在"**:先换单词/向量检索词(空格串是"与"逻辑,很容易零命中),仍无结果再用官网检索确认。
4. **把 `nhanesSearchTableNames()` 的 NULL 当函数坏了**:它匹配的是**文件名**不是主题词,"vitamin"查不到、"VID"能查到。
5. **`nhanes()` 忘了 `translated = FALSE`**:问卷编码会被译成文字,后面算总分时全是坑。

## 下篇预告

**第 06 篇**:把八个文件拼成一份分析数据集——merge 按 SEQN 横向拼表、append 跨周期纵向叠行、逐级复现论文的样本漏斗(11,933 → 3,863),并实测揭开论文没讲的一件事:**被排除的 8,070 人是谁,完整病例分析的代价有多大。**

## 参考来源

1. nhanesA 包文档(CRAN). https://cran.r-project.org/web/packages/nhanesA/
2. CDC/NCHS. NHANES 数据检索页. https://wwwn.cdc.gov/nchs/nhanes/search/datapage.aspx
3. 本篇函数行为均实测于 nhanesA 1.4.1 + R 4.5.2(2026 年 9 月),失效函数记录基于对官网页面结构变化的核对