
到上一篇为止,数据获取的"两条路"(手动 + 自动)都通了。现在做真正有成就感的一步:把散落的数据拼成一份能直接建模的分析数据集。这一篇讲两种拼法,方向完全不同:
- Merge(横向拼):同一个人加列,把 DEMO_L、VID_L、DPQ_L 按 SEQN 拼成宽表,本篇主线;
- Append(纵向叠):不同的人加行,把两个周期的数据上下摞起来扩样本,本篇第六节专门讲它的坑。
做完后,第 02 篇讲过的样本漏斗会被你的代码完整复现。数字对不上数字的教程不可信,本篇让它们全部对上。
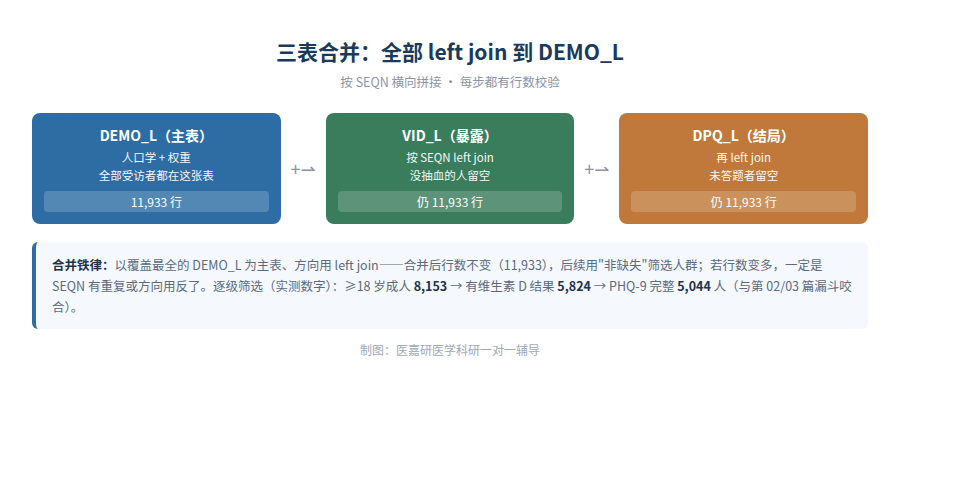
图1:以 DEMO_L 为主表做两次 left join,行数始终 11,933;最终筛出 5,044 人。
一、动手前先想清楚三个问题
① 谁当主表? 覆盖最全的那张——DEMO_L(全部 11,933 个受访者都在)。主表定方向:所有其他表都往它身上"贴"。
② 用什么方向? left join(保留主表全部行)。用 inner join(只留交集)也常有人教,但新手用 inner join 极易在"样本怎么变少"上糊涂;left join + 事后按"非缺失"筛选,每一步人数都可解释。
③ 贴上去之前查什么? 查 SEQN 有没有重复。重复键做合并会让行数暴增(一个人被贴多次)。实测三个文件重复 SEQN 均为 0,可以放心合并。
二、完整代码(本篇主脚本)
library(foreign)   # 或 library(nhanesA) 用 nhanes() 读

# ---- 1. 读入三个文件(路径按你自己的存放位置改)----
demo <- read.xport("DEMO_L.XPT")
vid  <- read.xport("VID_L.XPT")
dpq  <- read.xport("DPQ_L.XPT")

# ---- 2. 合并前检查:SEQN 无重复 ----
stopifnot(!any(duplicated(demo$SEQN)),
          !any(duplicated(vid$SEQN)),
          !any(duplicated(dpq$SEQN)))

# ---- 3. 只留需要的列(案例论文变量清单,见第 02 篇)----
items <- paste0("DPQ0", 1:9, "0")   # DPQ010 ~ DPQ090
d <- demo[, c("SEQN","RIDAGEYR","RIAGENDR","RIDRETH3",
              "INDFMPIR","DMDEDUC2","WTMEC2YR","SDMVSTRA","SDMVPSU")]
v <- vid [, c("SEQN","LBXVIDMS","LBXVD2MS","LBXVD3MS","WTPH2YR")]
p <- dpq [, c("SEQN", items)]

# ---- 4. 两次 left join ----
m <- merge(d, v, by = "SEQN", all.x = TRUE)
m <- merge(m, p, by = "SEQN", all.x = TRUE)
stopifnot(nrow(m) == nrow(demo))    # 合并后行数必须仍是 11,933

# ---- 5. 筛出分析人群(逐级核对,与第 02/03 篇漏斗一致)----
adults <- m$RIDAGEYR >= 18
vd_ok  <- !is.na(m$LBXVIDMS)
phq_ok <- apply(m[, items], 1, function(r) all(r %in% 0:3))
cat("成人:", sum(adults),
    "| 成人∩有维生素D:", sum(adults & vd_ok),
    "| 三者交集:", sum(adults & vd_ok & phq_ok), "\n")
三、实测结果与两个必讲的新手坑
实测输出(本篇代码真实运行):
成人: 8153 | 成人∩有维生素D: 5824 | 三者交集: 50445,044 ——与第 02、03 篇的漏斗数字完全咬合。案例论文的 3,863 是在此之上再排除协变量缺失等(差 1,181 人),这一步就是本篇第四节的清洗。
坑 1:nhanes() 会把编码自动翻译成文本。 这是实测踩到的真实问题:用 nhanes() 读 DPQ_L,DPQ010 的取值不是 0/1/2/3,而是 "Not at all" / "Several days" 这样的文字(nhanesA 好心做了翻译)。直接 rowSums() 会全部报错或成 NA。解法有二:
library(nhanesA)   # 先加载包
# 解法一(治本):读取时直接关闭翻译(第 05 篇讲过的开关)
dpq <- nhanes("DPQ_L", translated = FALSE)   # 拿到的就是数字编码 0/1/2/3

# 解法二(补救,承接本篇主脚本的 items 与 p):已读成文字的,映射回数字
map <- c("Not at all" = 0, "Several days" = 1,
         "More than half the days" = 2, "Nearly every day" = 3)
for (cl in items) p[[cl]] <- as.numeric(map[as.character(p[[cl]])])
映射后重跑,"PHQ-9 九项完整"实测 5,455 人,与第 03 篇一致(我们还逐人比对过:映射后的编码与 read.xport 直读的数字编码完全相同)。同一种数据,两条读取路径拿到的东西形态不同——这就是"自动下载也要校验"的原因。
坑 2:算总分之前必须先确认"九项全是 0–3"。 第 02 篇讲过 7=拒答、9=不知道,混进总分会污染结局。本篇代码的 phq_ok 就是把这条规则写成了代码:九项全落在 0–3 才算"完整作答"。
四、合并之后紧接着清洗:从 5,044 到 3,863(分析前的必经步骤)
注意顺序:合并之后、分析之前,必须先把人筛干净。清洗永远在建模前面。本篇的宽表(11,933 行)是"未清洗版";要复现论文,还得按论文 Figure 1 的排除口径把协变量文件并入、逐级筛到 3,863 人:
# (承接本篇主脚本:在合并好的 m 上继续)再并入 5 个协变量文件(BMX/SMQ/ALQ/BPQ/DIQ,第 04 篇已下载),然后按论文口径筛:
# BMI/收入/教育 非缺失;吸烟 SMQ020∈{1,2};饮酒 ALQ121∈0:10;高血压 BPQ020∈{1,2};糖尿病 DIQ010∈{1,2,3}
实测输出(与论文 Figure 1 流程图逐级一致):
11,933 → 成人 8,153 → PHQ-9 完整 5,455 → 有维生素 D 5,044 → 协变量全完整 3,863 ✅一个反直觉点(《复现规格书》已破解):论文把"从不饮酒者"(ALQ111=2,饮酒频率 ALQ121 自然缺失)也按缺失剔除。这就是严格 complete-case 的含义:只要分析用到的变量里有任何一个缺,整个人就不进模型。清洗的每一级人数都要能对上论文流程图,对不上就回头查(这是清洗环节的核心自检逻辑)。
暴露是怎么测出来的:HPLC-MS/MS
清洗到这里,暴露变量 LBXVIDMS 已经在你的数据集里了。但这里有一个绕不开的问题:这个数字是怎么测出来的? 论文 2.2 写得很清楚,我们把要点抄在下面:
| 论文原文要点 | 含义 |
|---|---|
| 暴露为血清 25-羟基维生素 D3(25OHD3)与 D2(25OHD2) | 测的是循环中的主要代谢物,不是维生素 D 本身 |
| 用 HPLC-MS/MS(高效液相色谱-串联质谱)定量 | 这是 CDC 实验室采用的参考方法;论文特别说明选它是因为"灵敏度与精密度高、能有效降低代谢物之间的交叉反应",从而保证定量准确 |
| 总维生素 D = 25OHD3 + 25OHD2 | 论文里"总维生素 D"是一个计算得来的变量,不是单独测的 |
| 结果以 ng/mL 报告 | 官方数据文件是 nmol/L,所以要做 ÷2.5 换算(前面讲过) |
为什么这一句非写不可? 三个原因:
- 测量方法决定变量能否跨研究比较。同样是"血清维生素 D",免疫法和质谱法测出来的值会有系统差异。论文不写检测方法,审稿人就无法判断你的结果能不能和既往文献比,而这恰好是这篇论文 Introduction 讨论"既往结果为什么矛盾"时会碰到的;
- 方法学部分有四样固定要素:检测平台、检测机构、单位与换算、低于检测限怎么处理。少写一样,方法描述就算不完整。关于最后一项,NHANES 在 Doc 里给了专门的处理规则:每个 LBX 变量配一个
LBD注释码(如LBDVIDLC),标注该值是否低于检测下限;低于下限时官方用LLOD/√2作为替代值填入。是否接受这批替代值、要不要做敏感性分析,属于你要在方法里写清的决定(第 02 篇讲 Doc 时提过这条规则); - 复现报告要能证明"同一批人、同一套测量"。我们最终样本的均龄 53.56 岁与论文逐位一致,说明人群切得一样;暴露变量又统一换算成 ng/mL,说明测量值可以直接比。两件事都核实过,复现结论才站得住。
给你的写作模板(把上表填成一句话即可):
血清 25(OH)D2 与 25(OH)D3 采用高效液相色谱-串联质谱法(HPLC-MS/MS)测定;总维生素 D 定义为两者之和;结果以 ng/mL 表示(原始数据单位为 nmol/L,按 1 ng/mL = 2.5 nmol/L 换算);低于检测限的样本按官方规则以 LLOD/√2 替代。
复现路线提示:对照《案例论文复现规格书》,本篇合并 + 清洗完成后达成里程碑 M2(宽表)+ M3(分析样本 N=3,863)——数据集就绪。第 07 篇理解权重并立刻用它产出论文 Table 1,第 08、09 篇再把 Table 2、Figure 2/3 与 Table 3 逐张复现。
五、被排除的 8,070 人:完整病例分析的代价
漏斗走完了,但有一件事论文没讲、你必须知道:从 11,933 到 3,863,一共排除了 8,070 人,占 67.6%。这些人不是"随机"消失的。
四道关卡的排除量:未成年 3,780 人 + 抑郁数据缺失 2,698 人 + 维生素 D 缺失 411 人 + 协变量缺失 1,181 人。
5.1 把被排除的人"画"出来:一次实测对比
我们在脚本里加了这几行(你可以直接复现),把"全体成人 / 被排除的成人 / 最终分析样本"三组人的画像并排算出来:
# 承接本篇主脚本:m 是 11,933 行宽表,s1/s3/s4 分别是成人、过前三关、最终纳入的逻辑向量
prof <- function(d, lab) cat(sprintf("%-12s N=%5d | 年龄 %5.2f | 男性 %4.1f%% | 非西裔白人 %4.1f%% | PIR中位数 %4.2f | 高中以下 %4.1f%%\n",
  lab, nrow(d), mean(d$RIDAGEYR), 100*mean(d$RIAGENDR == 1), 100*mean(d$RIDRETH3 == 3),
  median(d$INDFMPIR, na.rm = TRUE), 100*mean(d$DMDEDUC2 == 1, na.rm = TRUE)))

prof(m[s1, ],        "全体成人")      # 8,153
prof(m[s1 & !s4, ],  "被排除的成人")  # 4,290
prof(m[s4, ],        "最终分析样本")  # 3,863
实测输出(2026 年 9 月,未加权口径):
| 人群 | N | 平均年龄 | 男性 | 非西裔白人 | 收入 PIR 中位数 | 高中以下 |
|---|---|---|---|---|---|---|
| 全体成人 | 8,153 | 52.14 | 44.9% | 57.7% | 2.75 | 4.8% |
| 被排除的成人 | 4,290 | 50.87 | 44.1% | 50.9% | 2.17 | 7.3% |
| 最终分析样本 | 3,863 | 53.56 | 45.7% | 65.2% | 3.22 | 2.2% |
成人里有一半以上(52.6%)被排除,而留下来的人系统性地更老、更白、更富、受教育程度更高。 顺带一个佐证:我们最终样本的平均年龄 53.56 岁,与论文正文报告的 53.56 岁逐位一致——说明我们和论文切出的是同一批人,上面这个偏移不是我们算错了,而是这套排除口径本身的固有后果。
5.2 卡在哪一关?缺失构成拆开看
最后那 1,181 人是"过了前三关、倒在协变量上"的,他们的缺失构成(可重叠,故合计大于 1,181):
| 缺失的协变量 | 人数 | 占 1,181 人 |
|---|---|---|
| 收入 PIR | 595 | 50.4% |
| 饮酒频率 | 513 | 43.4% |
| 教育 | 207 | 17.5% |
| BMI | 39 | 3.3% |
| 吸烟 / 高血压 / 糖尿病 | 9 / 2 / 1 | < 1% |
收入是最大的漏斗。 而这 1,181 人的收入中位数只有 1.89(最终样本是 3.22)——也就是说,"收入缺失"本身就和贫困高度相关:越可能不报收入的人越可能被整批剔除。
5.3 为什么这件事很要命
抑郁在研究人群里恰好与低收入、低教育、少数族裔相关。把收入缺失者(偏穷、偏少数族裔)系统性剔除之后,剩下的样本变成了"低风险人群"——暴露与结局的关联估计可能被稀释,也可能被扭曲,方向都不一定。
这类偏倚在方法学上有名字:无应答偏倚 / 缺失偏倚。它和"抽样设计造成的结构偏差"是两码事:后者靠权重可以修正,前者权重修不了。权重只能让有数据的人代表全国,替没数据的人说话它做不到。第 07 篇会专门讲权重的能力边界,这里先立住这句话:加权 ≠ 万能。
5.4 论文做了多少?你还能补什么?
| 动作 | 论文是否做了 | 说明 |
|---|---|---|
| 报告完整排除流程图(Figure 1) | ✅ 做了,且逐级人数与我们实测完全一致 | 这是规范做法 |
| 报告"纳入 vs 排除"基线对比 | ❌ 没做 | 复现者一眼能看出的软肋 |
| 做缺失敏感性分析 | ❌ 没做 | 例如把"收入缺失"单列一类、或用多重插补 |
| 在局限里写明这一点 | ❌ 没提 | 论文只写了"横断面不能推断因果" |
这就是复现能多给你的东西:你不但能复现出论文的数字,还能看出论文没做的事。等你自己做研究时,上面第 2–4 行就是三个现成的加分项——一张纳入/排除基线对比表、一次缺失敏感性分析、一句诚实的局限说明,成本不高,但审稿人喜欢。第 10 篇写复现报告时,我们会把这一节正式写进"研究局限"里。
3,863 人不是"剩下的",是"被选出来的"。知道它怎么被选出来,才知道结论能推到谁身上。
六、另一种拼法:跨周期纵向追加(Append)
本篇的 merge 是横向拼(同一个人加列);还有一类需求是纵向叠——把两个周期的数据上下摞起来增加样本量(第 03 篇讲多周期合并时预告过)。用的是 rbind(),但前提比 merge 苛刻得多,我们实测踩给你看:
前提①:两个周期的 SEQN 不得重叠(实测 DEMO_J × DEMO_L 重复数为 0,安全); 前提②:两边列名、列类型必须一致——这是真正的坑。实测对比 DEMO_J(2017–2018)与 DEMO_L,两种翻车方式:
- 列数不同 → 直接报错。DEMO_J 有 46 列,DEMO_L 只有 27 列,连共同列都没对齐就 rbind,R 直接拒绝:"变量的列数不正确";
- 同名列类型不同 → 更隐蔽:只取共同列后 rbind 不报错,但性别列在 DEMO_J 里是文字 "Female/Male"、在 DEMO_L 里是数字 1/2,硬拼的结果是 DEMO_L 的 11,933 行性别全部变成 NA,只给你 16 条警告——不仔细看就带着脏数据往下走了(实测如此)。
安全做法(实测通过,NA 数为 0):妙招是用第 04 篇的 translated = FALSE 开关——nhanes() 的自动翻译正是类型冲突的元凶之一(把数字编码译成了文字),关掉它,两个周期的性别列就都是数字 1/2 了:
library(nhanesA); library(foreign)   # nhanesA 读旧周期, foreign 读本地下载
demo_j  <- nhanes("DEMO_J", translated = FALSE)   # 读出来就是数字编码
demo_l  <- read.xport("DEMO_L.XPT")               # read.xport 本来就是数字
core    <- c("SEQN", "RIDAGEYR", "RIAGENDR")
a <- transform(demo_j[, core], cyc = "2017-2018")
b <- transform(demo_l[, core], cyc = "2021-2023")
appended <- rbind(a, b)
# 实测:21,187 行(9,254 + 11,933),SEQN 无重复,RIAGENDR 两边都是 1/2,NA 数 = 0
如果当初已经用默认方式读成了文字,补救办法仍是本篇坑 1 的映射(文字 → 数字)。类型对齐是 append 的生死线,而"关翻译"让类型对齐变得顺手。多周期合并还牵扯权重拆分(每周期各有权重),那些到第 07 篇讲完权重再回来做才稳妥——本篇先把方法和坑记下。
七、合并后必做的三件检查(以本篇 left join 为主线)
- 行数不变:left join 后仍是 11,933 行(脚本里的
stopifnot就是自动检查,行数变了立刻报错); - 各来源变量缺失数与源文件一致:合并后
sum(!is.na(m$LBXVIDMS))应为 7,307(实测一致)——如果对不上,多半是合并方向或键错了; - 抽样抽查几个人:随机挑 2–3 个 SEQN,回源文件核对年龄、维生素 D 值是否一一对应。我们实测抽查了 2 人(如 SEQN 132786:合并表年龄 74 / 维生素 D 94,与 DEMO_L、VID_L 源文件完全一致),方法可行。机器校验之外的人工抽查,是数据工作者的基本素养。
这三关全过,m 这份 11,933 行的宽表 + 第四节清洗出的 3,863 人分析样本,就是全系列攒出的可直接建模的数据集,第 07 篇的加权描述与第 08、09 篇的建模都将基于它。
这几种拼法各有各的用:left join 拼宽表做单人分析(本案例主线)、rbind 叠长表做跨周期扩样;inner join 新手慎用。先把 left join 用熟,另一个知道存在、踩过坑即可。
【暗线进度条 · 里程碑 M2 ✅ M3 ✅】 数据获取已掌握(第 04、05 篇)→ 三表横向合并 + 跨周期纵向追加 + 合并后清洗(N=3,863 与论文一致) → 下一站:权重该用哪个,并立刻用它产出论文的第一张结果表(第 07 篇) (对应论文 2.1:数据合并拼接)
本篇对应的复现脚本段落(完整代码)
总脚本第 2 步就是这段(合并与漏斗),代码一字未改。
##### 第 2 步:合并 + 按论文排除流程筛人(论文 2.1 / Figure 1 流程图)########
#
# 论文 Figure 1 的排除流程(每一步我们都实测核对过,数字与论文完全一致):
#   11,933(总样本)
#   → 排除 <18 岁(3,780 人)→ 剩 8,153
#   → 排除抑郁数据缺失(2,698 人)→ 剩 5,455
#   → 排除维生素 D 缺失(411 人)→ 剩 5,044
#   → 排除协变量缺失(1,181 人)→ 剩 3,863(论文最终分析样本)
#
# 先合并成一张宽表(本篇教过:以 DEMO 为主表 left join):
# merge(a, b, by="SEQN", all.x=TRUE) 的意思是:以 a 为主表,按 SEQN 把 b 的列贴上去
#(all.x=TRUE 就是 left join:保住 a 的所有人,b 里没有的就留空)

dat <- demo[, c("SEQN", "RIDAGEYR", "RIAGENDR", "RIDRETH3", "INDFMPIR",
                "DMDEDUC2", "WTMEC2YR", "SDMVSTRA", "SDMVPSU")]
dat <- merge(dat, vid[, c("SEQN", "WTPH2YR", "LBXVIDMS", "LBXVD2MS", "LBXVD3MS")], by = "SEQN", all.x = TRUE)
dat <- merge(dat, dpq[, c("SEQN", paste0("DPQ0", 1:9, "0"))], by = "SEQN", all.x = TRUE)
dat <- merge(dat, bmx[, c("SEQN", "BMXBMI")],  by = "SEQN", all.x = TRUE)
dat <- merge(dat, smq[, c("SEQN", "SMQ020")],  by = "SEQN", all.x = TRUE)
dat <- merge(dat, alq[, c("SEQN", "ALQ121")],  by = "SEQN", all.x = TRUE)
dat <- merge(dat, bpq[, c("SEQN", "BPQ020")],  by = "SEQN", all.x = TRUE)
dat <- merge(dat, diq[, c("SEQN", "DIQ010")],  by = "SEQN", all.x = TRUE)

items <- paste0("DPQ0", 1:9, "0")   # PHQ-9 的九道题 DPQ010~DPQ090

# 漏斗第一步:只留成年人(论文:≥18 岁)
step1 <- dat$RIDAGEYR >= 18
cat("漏斗 1:≥18 岁成人 =", sum(step1), "(论文:8,153)\n")

# 漏斗第二步:PHQ-9 九道题全部有效作答(每题取值 0~3;7=拒答、9=不知道算缺失)
# apply(dat[, items], 1, ...) 的意思是:对这张表的每一行(每个受访者)做一次检查
phq_ok <- apply(dat[, items], 1, function(r) all(r %in% 0:3))
step2 <- step1 & phq_ok
cat("漏斗 2:抑郁数据完整 =", sum(step2), "(论文:5,455)\n")

# 漏斗第三步:有血清维生素 D 结果
step3 <- step2 & !is.na(dat$LBXVIDMS)
cat("漏斗 3:有维生素 D =", sum(step3), "(论文:5,044)\n")

# 漏斗第四步:协变量全部完整(论文要求 PIR、BMI、高血压、吸烟、饮酒、教育都不缺)
# 注意反直觉点(规格书已破解):从不饮酒者的 ALQ121 是缺失值,论文按缺失剔除;
# 糖尿病 DIQ010 的缺失(拒答/不知道)同样剔除
step4 <- step3 &
  !is.na(dat$BMXBMI)   &   # BMI 完整
  !is.na(dat$INDFMPIR) &   # 收入贫困比完整
  !is.na(dat$DMDEDUC2) &   # 教育完整(拒答/不知道官方已置缺失)
  (dat$SMQ020 %in% c(1, 2)) &  # 吸烟:1=是 2=否(7=拒答 9=不知道剔除)
  (dat$ALQ121 %in% 0:10)   &  # 饮酒频率有效编码(NA/77/99 剔除,含从不饮酒者)
  (dat$BPQ020 %in% c(1, 2)) &  # 高血压:1=是 2=否
  (dat$DIQ010 %in% c(1, 2, 3)) # 糖尿病:1=是 2=否 3=临界

# ana <- dat[step4, ] 的意思是:从 dat 里挑出 step4 为真的行(逗号后留空=所有列)
ana <- dat[step4, ]   # ana = 最终分析数据集
cat("漏斗 4:协变量全完整 =", nrow(ana), "(论文:3,863)✅ 复现成功\n")
以下两段分别与《复现总脚本》第 3 步、第 4 步逐字一致——筛出人之后紧接着定义"暴露、结局、协变量",这是合并清洗与建模之间的桥(饮酒四组映射已按论文口径修正,见段内注释)。
##### 第 3 步:定义暴露与结局(论文 2.2)######################################
#
# 暴露:血清总维生素 D。NHANES 官方单位是 nmol/L;论文按 ng/mL 报告
#      (1 ng/mL = 2.5 nmol/L,复现对照时用换算后口径,见第 5 步注释)。
# 结局:PHQ-9 总分 ≥10 判为有抑郁症状。

ana$phq_total <- rowSums(ana[, items])          # PHQ-9 总分(0~27):rowSums=按行求和
ana$depression <- as.numeric(ana$phq_total >= 10)  # >=10 判为有抑郁症状,记 1;否则记 0

cat("结局自查:分析样本中抑郁人数 =", sum(ana$depression),
"(", round(100 * mean(ana$depression), 1), "%,未加权口径)\n")##### 第 4 步:协变量重编码(论文 2.3)########################################
#
# 把 NHANES 的原始编码翻成论文 Table 1 里的分组:
ana$male <- as.numeric(ana$RIAGENDR == 1) # 性别:1=男
ana$race <- ifelse(ana$RIDRETH3 %in% c(6, 7), 5, ana$RIDRETH3) # 6/7 合并为"其他种族"
ana$race <- factor(ana$race, levels = 1:5,
labels = c("Mexican American", "Other Hispanic",
"Non-Hispanic White", "Non-Hispanic Black", "Other Races"))
ana$education <- factor(ana$DMDEDUC2, levels = 1:5) |>
(\(x) factor(ifelse(x %in% 1:2, "Less than high school",
ifelse(x == 3, "High school or GED", "Above high school")),
levels = c("Less than high school", "High school or GED", "Above high school")))()
ana$smoking <- as.numeric(ana$SMQ020 == 1) # 1=吸烟
# 饮酒四组(ALQ121 官方编码,2021–2023 版):0=过去一年从不喝;1=每天;2=几乎每天;
# 3=每周3-4次;4=每周2次;5=每周1次;6=每月2-3次;7=每月1次;8=一年7-11次;
# 9=一年3-6次;10=一年1-2次(77/99=拒答/不知道,已在漏斗里剔除)
# ★ 论文口径(已用原文 Table 3 各组 N=645/1,510/903/805 精确反推为唯一解,见复现核对报告 4.1):
# Never=0|Frequent=1-5(每周至少一次)|Infrequent=6-8(每月级)|Occasional=9-10(一年仅几次)
# cut() 的区间是左开右闭:(0,5] 恰好是编码 1~5,(5,8] 是 6~8,(8,10] 是 9~10
ana$drinking <- cut(ana$ALQ121, breaks = c(-1, 0, 5, 8, 10),
labels = c("Never", "Frequent", "Infrequent", "Occasional"))
# 再把四组的显示顺序排成论文 Table 1 的样子(Never 在前做参照组,不影响模型结果)
ana$drinking <- factor(ana$drinking, levels = c("Never", "Occasional", "Infrequent", "Frequent"))
ana$diabetes <- as.numeric(ana$DIQ010 == 1) # 1=糖尿病
ana$hypertension <- as.numeric(ana$BPQ020 == 1) # 1=高血压
# 暴露的两种口径:nmol/L(官方)与 ng/mL(论文报告口径)
ana$vitD_nmol <- ana$LBXVIDMS
ana$vitD_ngml <- ana$LBXVIDMS / 2.5
cat("协变量自查:", sum(is.na(ana$smoking)), "个吸烟缺失(应为 0)\n")本篇常见坑
- 不查重复键直接 merge:SEQN 重复会让行数暴涨、结果面目全非——合并前
duplicated()一查。 - 方向用反:以 VID_L 为主表 left join DEMO_L,只剩 8,727 人,把没抽血的人全弄丢了。
- 合并后不核对行数/缺失数:错联、漏联悄无声息,所有下游分析跟着错。
- nhanes() 文本编码直接求和:见坑 1,读取时关翻译或事后映射回数字。
- 跨周期 append 不管列类型:一边文字一边数字,rbind 悄悄塞 NA——只取共同核心列、统一类型、自加周期列。
下篇预告
第 07 篇:权重到底选哪个,以及怎么用——WTINT2YR / WTMEC2YR / WTPH2YR 等权重的分工与判断表、svydesign 的正确姿势(对设计对象取子集,而不是对数据取子集)、加权与未加权的实测对比,最后直接用它产出论文的 Table 1 基线特征表并与原文逐行核对。
参考来源
- CDC/NCHS. NHANES Tutorials — Data Structure & Merging. https://wwwn.cdc.gov/nchs/nhanes/tutorials/default.aspx
- 案例论文:Front Nutr. 2025;12:1545443. PMID: 40497025.
- 本篇合并流程、5,044 人数、nhanes() 文本编码问题均为 2026 年 9 月 R 实测记录