科研资讯
获取最新的医学科研动态与学术指导,覆盖 Meta 分析、生信分析、临床研究、投稿经验等前沿话题。
医学科研动态与学术指导,覆盖 Meta 分析、生信分析、临床研究、投稿经验等话题。
NHANES复现教学 8:加权回归与剂量反应,复现论文 Table 2
把关联算出来:svyglm 的系数怎么变成 OR、三个递进模型为何要逐级调整、连续三行(总量/D2/D3)与四分位剂量反应全部复现——9 个 OR 偏差 ≤0.004,剂量反应 15.4%→8.5% 单调递减。并讲透两个容易被忽略的点:OR 的量纲换算(每 1 ng/mL 与每 10 ng/mL 差一个数量级),以及单周期 NHANES 设计自由度只有 15、全调整模型参数过量导致 P 值无解时该怎么如实处理。
NHANES复现教学 7:加权描述统计,复现论文 Table 1
权重怎么选、怎么用:四类权重的判断表、权重为 0 的个体必须剔除、官方分析指南该看哪七条、svydesign 四参数与子人群分析的正确姿势(对设计对象取子集)、方差估计与设计效应(实测 deff = 3.27);再补一节「读结果的四个基本功」(患病率≠发病率、95%CI、P 值、odds 与 OR),然后当场复现论文 Table 1——6 个连续变量最大偏差 0.17、16 行分类百分比全部对齐。
NHANES复现教学 6:合并清洗,复现样本漏斗 11,933→3,863
复现的核心一步:merge 按 SEQN 横向拼表、append 跨周期纵向叠行;把论文每条排除标准落成代码,逐级复现漏斗 11,933 → 3,863,每一级人数与论文咬合;讲清暴露是怎么测出来的(HPLC-MS/MS 与单位换算),并实测揭开论文没讲的一件事——被排除的 8,070 人系统性更穷、更年轻、少数族裔更多,完整病例分析的代价与权重修不了的那部分偏倚。
NHANES复现教学 5:nhanesA 一条命令读进 R
拿到数据(下):用 nhanesA 把重复劳动交给机器——nhanes() 一条命令下载并读入、nhanesCodebook()/nhanesTranslate() 把 Doc 搬进 R、nhanesSearchVarName() 跨周期检索变量、nhanesManifest() 拿全量文件清单;并如实记录哪些函数已在官网改版后失效、工具坏了怎么兜底,以及「手动 vs 自动」该怎么选。
NHANES复现教学 4:装好环境,下载数据文件
拿到数据(上):10 分钟装好 R 与六个必备包(附常见报错速查),再走官网手动下载案例论文需要的八个文件与配套 Doc——含真实页面实拍、四段网址规律、下载后必验的三件事(格式/大小/行数),以及很多人不知道的死亡率链接文件(NDI)专门入口与数据使用协议要点。
NHANES复现教学 3:选题可行性与案例论文
读论文的第一课:这篇论文到底要回答什么问题——从 Introduction 的三段式(问题重要 → 既往证据矛盾 → 研究空白)拆出「为什么要把维生素 D2 与 D3 分开研究」这一核心逻辑;再教你把论文拆成六要素与六块结果,用三步自查判断选题可行性:变量存在吗、样本量够吗、是否受限数据(RDC)。
NHANES复现教学 2:数据结构与 SEQN 主键
讲透 NHANES 的数据组织:一个受访者对应多张表、DEMO 人口学表是主表、SEQN 主键贯穿所有文件、变量名前缀暗号、周期命名 _B 到 _L 的规则、Doc 文档四段结构怎么读;并第一次解释 WT* 与 SDMVPSU/SDMVSTRA 这些「设计信息」列是什么(第 07 篇会用它们做加权分析)。附案例论文完整变量清单,全部在真实文件与 Doc 中实机核验。
NHANES复现教学 1:认识数据库与复现路线
认识 NHANES:60 余年的美国全国健康调查、多阶段分层抽样为什么带来全国代表性、五类公开数据文件各装什么、横断面设计能回答什么不能回答什么;并公告全系列终点——10 篇内容完整复现一篇真实发表的论文(PMID 40497025),产出 Figure 1 样本漏斗、Table 1 基线表、Table 2 主分析、Figure 2/3 剂量反应与 Table 3 亚组分析,每一块都与原文数字逐格核对。
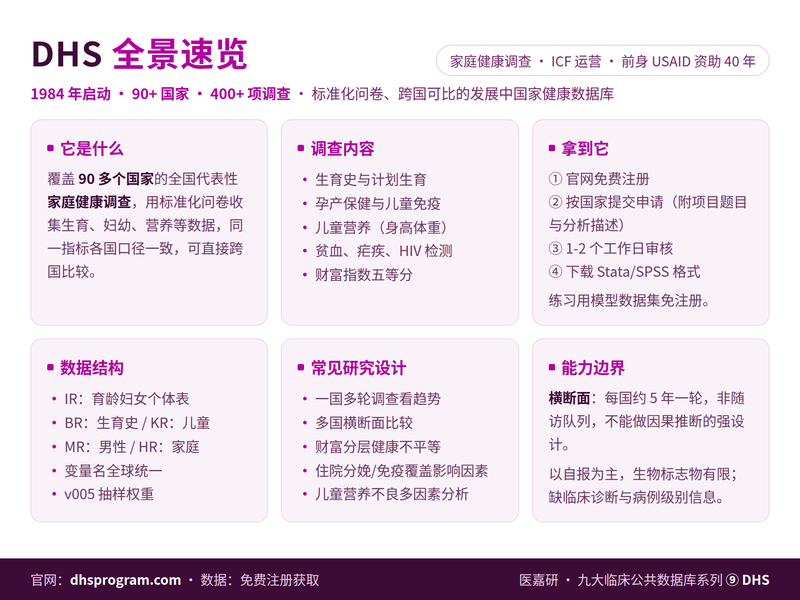
DHS 数据库完全指南:90+ 国家家庭健康调查,全球健康研究标配
DHS(Demographic and Health Surveys)是 1984 年启动、覆盖 90 多个国家的家庭健康调查项目:标准化问卷让各国指标口径一致、可直接跨国比较,主题涵盖生育、计划生育、妇幼健康、营养、HIV 与疟疾。本文按认识、获取、读懂、正确分析、研究设计与发表的顺序,介绍它的 Recode 文件体系、免费申请流程、svyset 加权要点与高频发文方向。
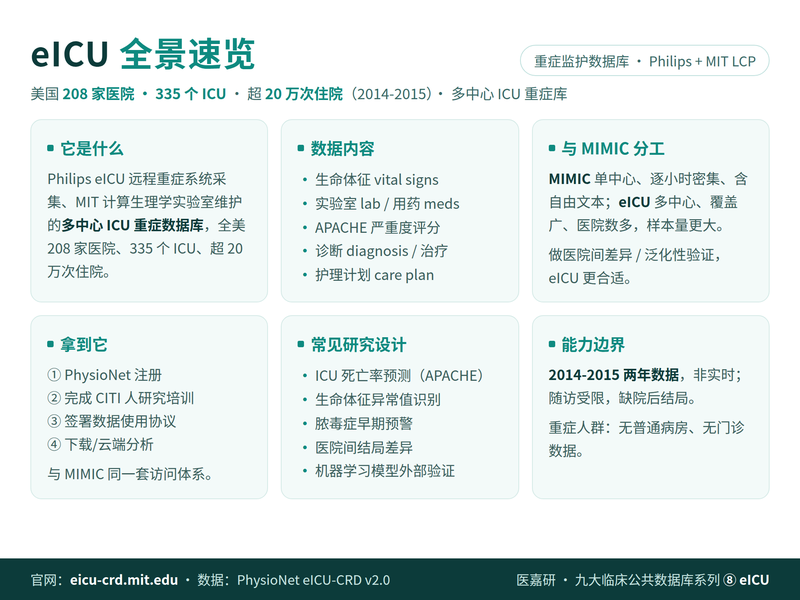
eICU 数据库完全指南:208 家医院、20 万次住院的多中心 ICU 重症库
eICU(Collaborative Research Database)是 Philips 与 MIT 计算生理学实验室共同维护的多中心 ICU 重症数据库:覆盖全美 208 家医院、335 个 ICU、超 20 万次住院(2014-2015)。本文按认识、获取、读懂、正确分析、研究设计与发表的顺序,系统介绍它的表结构、PhysioNet 访问流程、医院异质性处理与 MIMIC 互补用法。
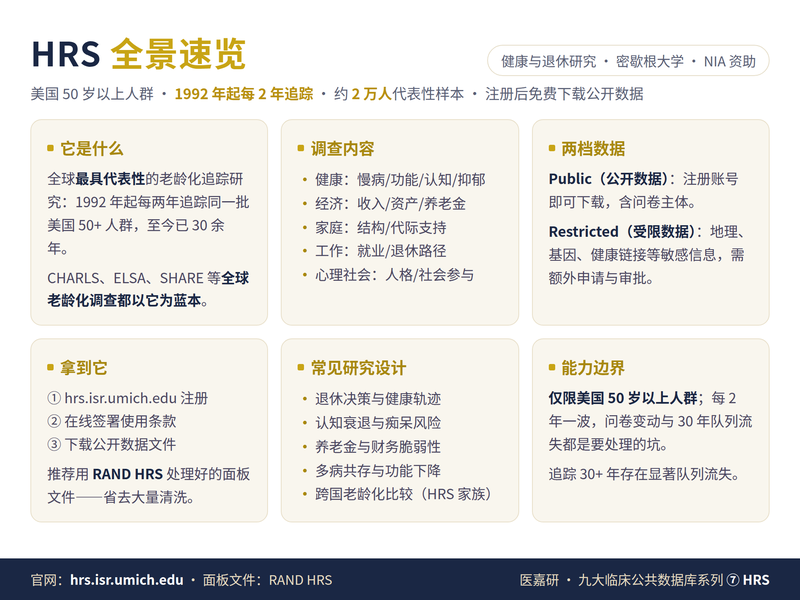
HRS 数据库完全指南:追踪美国 50+ 人群 30 年的老龄化研究标杆之作
HRS(健康与退休研究)是密歇根大学运营的全球最具代表性的老龄化追踪研究:1992 年起每 2 年追踪约 2 万名美国 50+ 人群,覆盖健康、经济、家庭、工作与心理社会五大维度,注册后免费下载。本文按认识、获取、读懂、正确分析、研究设计与发表的顺序,系统介绍它的队列设计、波次结构、RAND HRS 面板文件、追踪流失处理与常见研究设计。
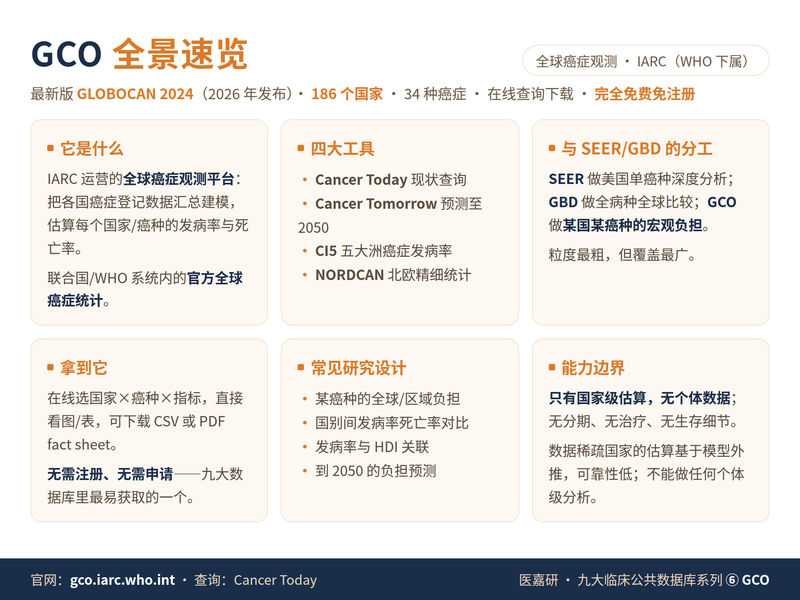
GCO 数据库完全指南:覆盖 186 国的全球癌症观测,打开网页就能查的官方统计
GCO(全球癌症观测)是 IARC/WHO 运营的全球癌症统计平台:186 个国家、34 种癌症的发病率与死亡率估算,在线查询直接下载,完全免费免注册。本文按认识、获取、读懂、正确分析、研究设计与发表的顺序,系统介绍它的四大工具、数据源透明度、ASR 标化要点与常见研究设计。
- 1
- 2
- 3
- 4
- 5
- 6
- 8